Jahangirnagar University 的 Department of Pharmacy 中 Sukalyan Research Group 的网站,由 Sukalyan Kumar Kundu 教授领导:七个研究方向及其技术和论文,一份按年份归类、可筛选的一百二十四条 Google Scholar 记录的论文列表,首席研究员的简介,按姓名和肖像列出的成员,一面校友去向墙,一个 Lab Life 图库,以及带邮件清单的四条路径加入页面。Next.js 静态导出,React 和 TypeScript,Tailwind CSS,所有内容都在一个查询函数之后,因此迁移到无头 CMS 时其他一切都不必改变。作为单个容器部署在自托管的 Kubernetes 集群上。
Md Moniruzzaman

完整故事
一个有二十年积累的研究小组,网上只有一个地址,收件箱里的邮件也更像样。
工作是真实的。找到它却不是。
Sukalyan Research Group 在 Jahangirnagar University 的 Department of Pharmacy 工作,研究药用植物、药物递送、毒理学和计算药理学。其首席研究员 Sukalyan Kumar Kundu 教授有八十三篇列出的论文,指导十一位博士研究人员,并已指导六十多篇 MS 论文和七十多个荣誉学位项目。这些都不在同一个地方。寻找这个小组的准学生、合作者或制药公司,找到的是一个 Google Scholar 主页、一个 ResearchGate 页面、一份大学教职员名单和一个社交账号,每个都只显示一角,没有一个说明这个小组是做什么的。
一个研究小组,是以搜索结果来评判的。任务是一个能承载全貌的地址:实验室研究什么、谁在其中工作、它发表过的每一篇论文,以及如何加入。
一句话,让陌生人明白这个实验室是做什么的
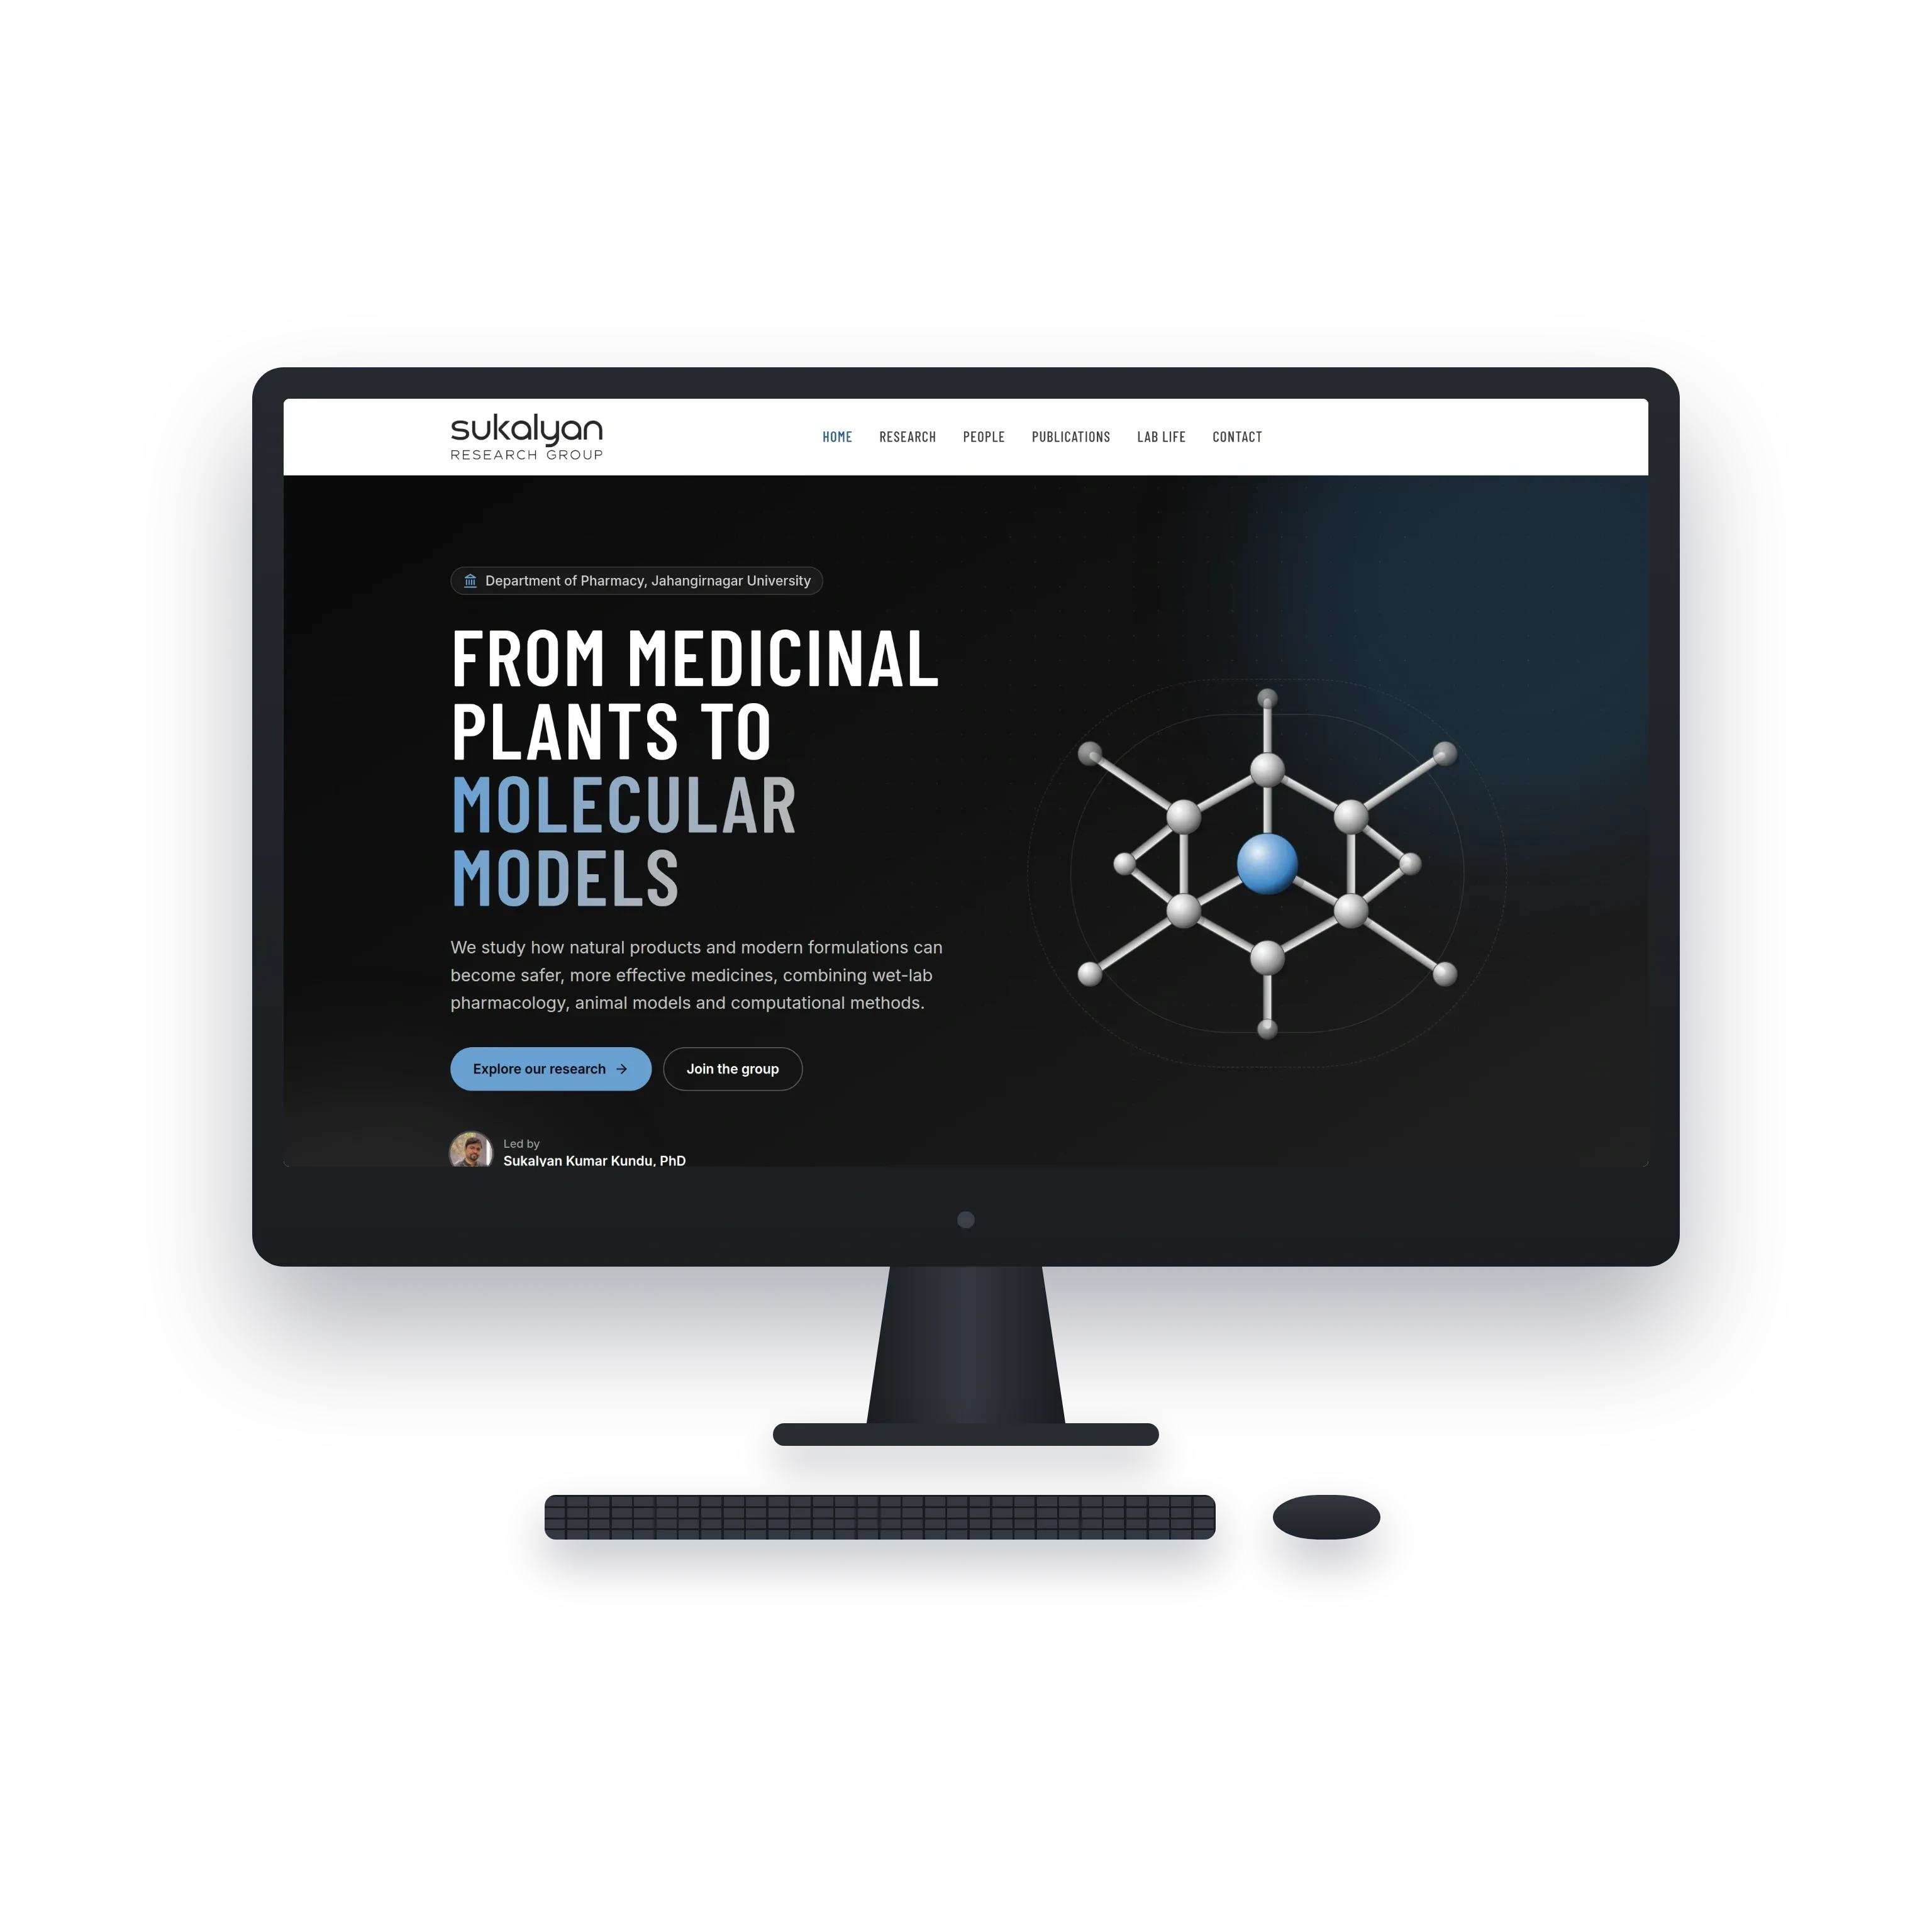
首页以小组只有三十秒时会说的那句话开场:从药用植物到分子模型,研究天然产物和现代制剂如何成为更安全、更有效的药物。它下面是访问者真正想要的两样东西,研究和加入的途径,然后是小组能够担保的三个数字:八十三篇论文,指导十七位博士研究人员,一百三十多篇 MS 和荣誉学位论文。再往下是七个研究方向、带着五个公开主页的首席研究员、六篇精选论文、按姓名和职位列出的团队,以及对小组所在大学和院系的一段简短而诚实的介绍。
小组研究的问题,始于孟加拉国人真正使用的药物,从传统的植物疗法到药房货架上的仿制药片。在第一屏上把这一点说清楚,正是陌生人能否看懂一个小组的分界。
七个研究方向,每一个都在提问之前给出答案
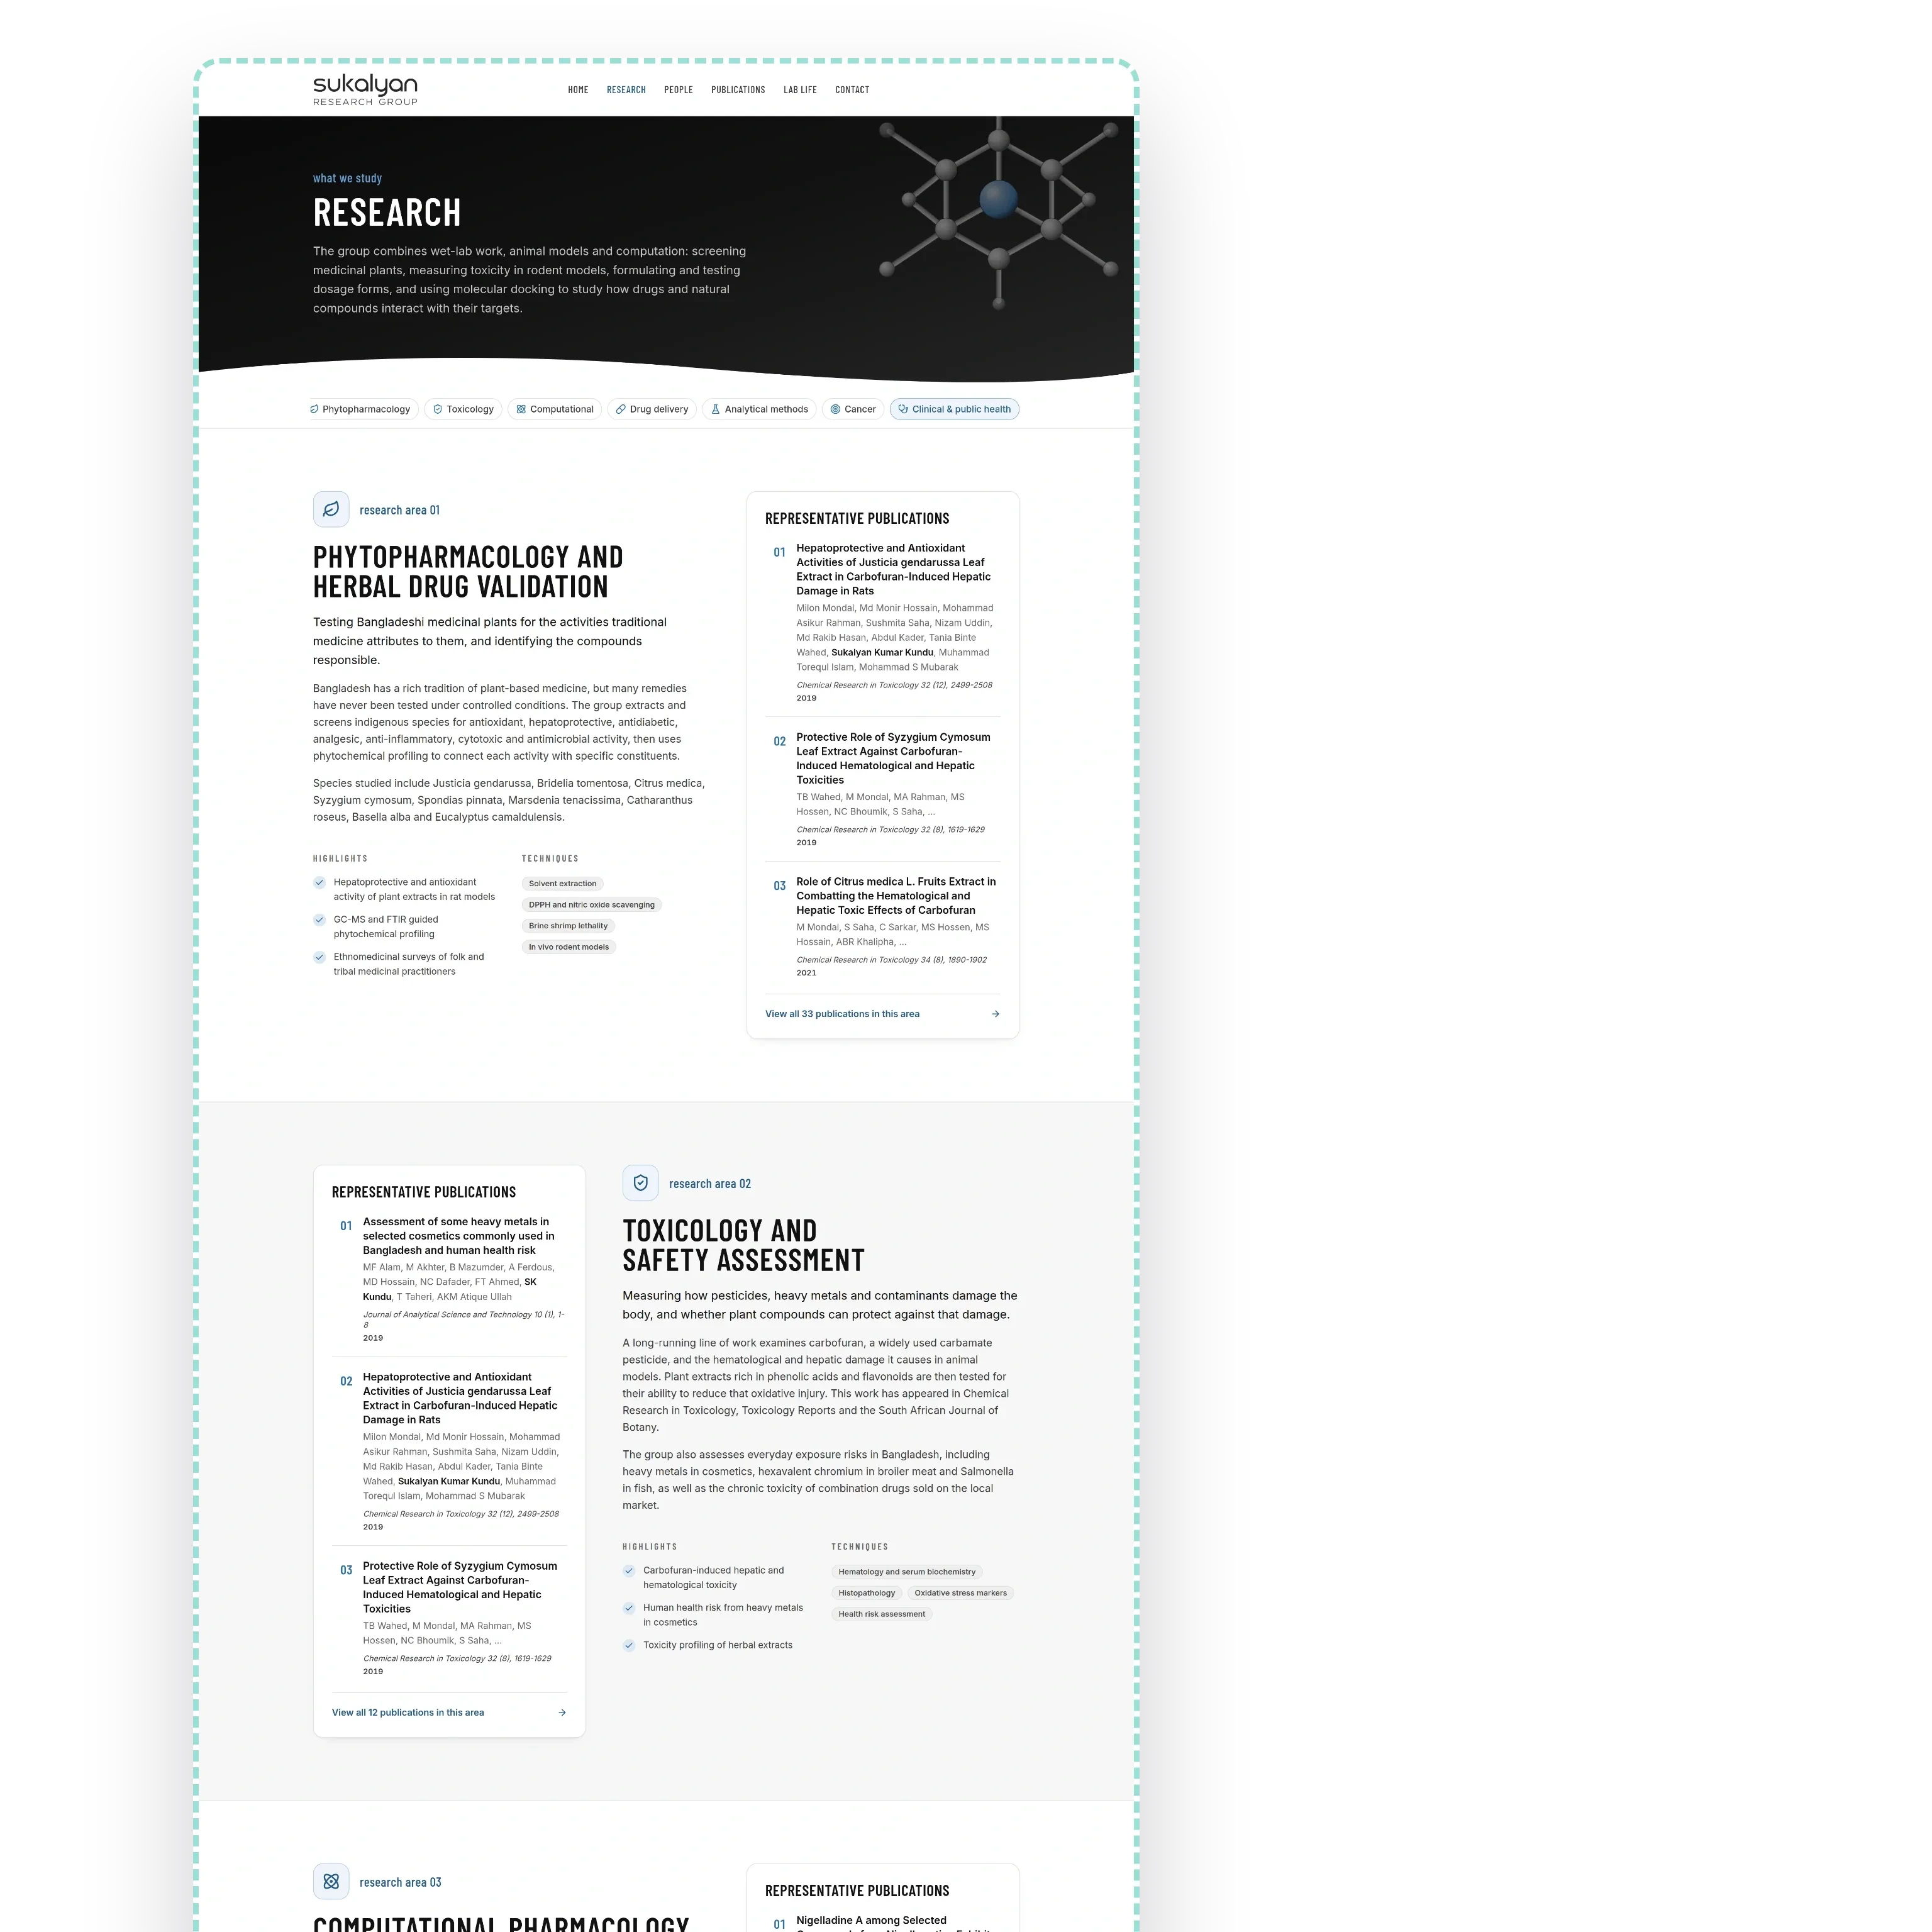
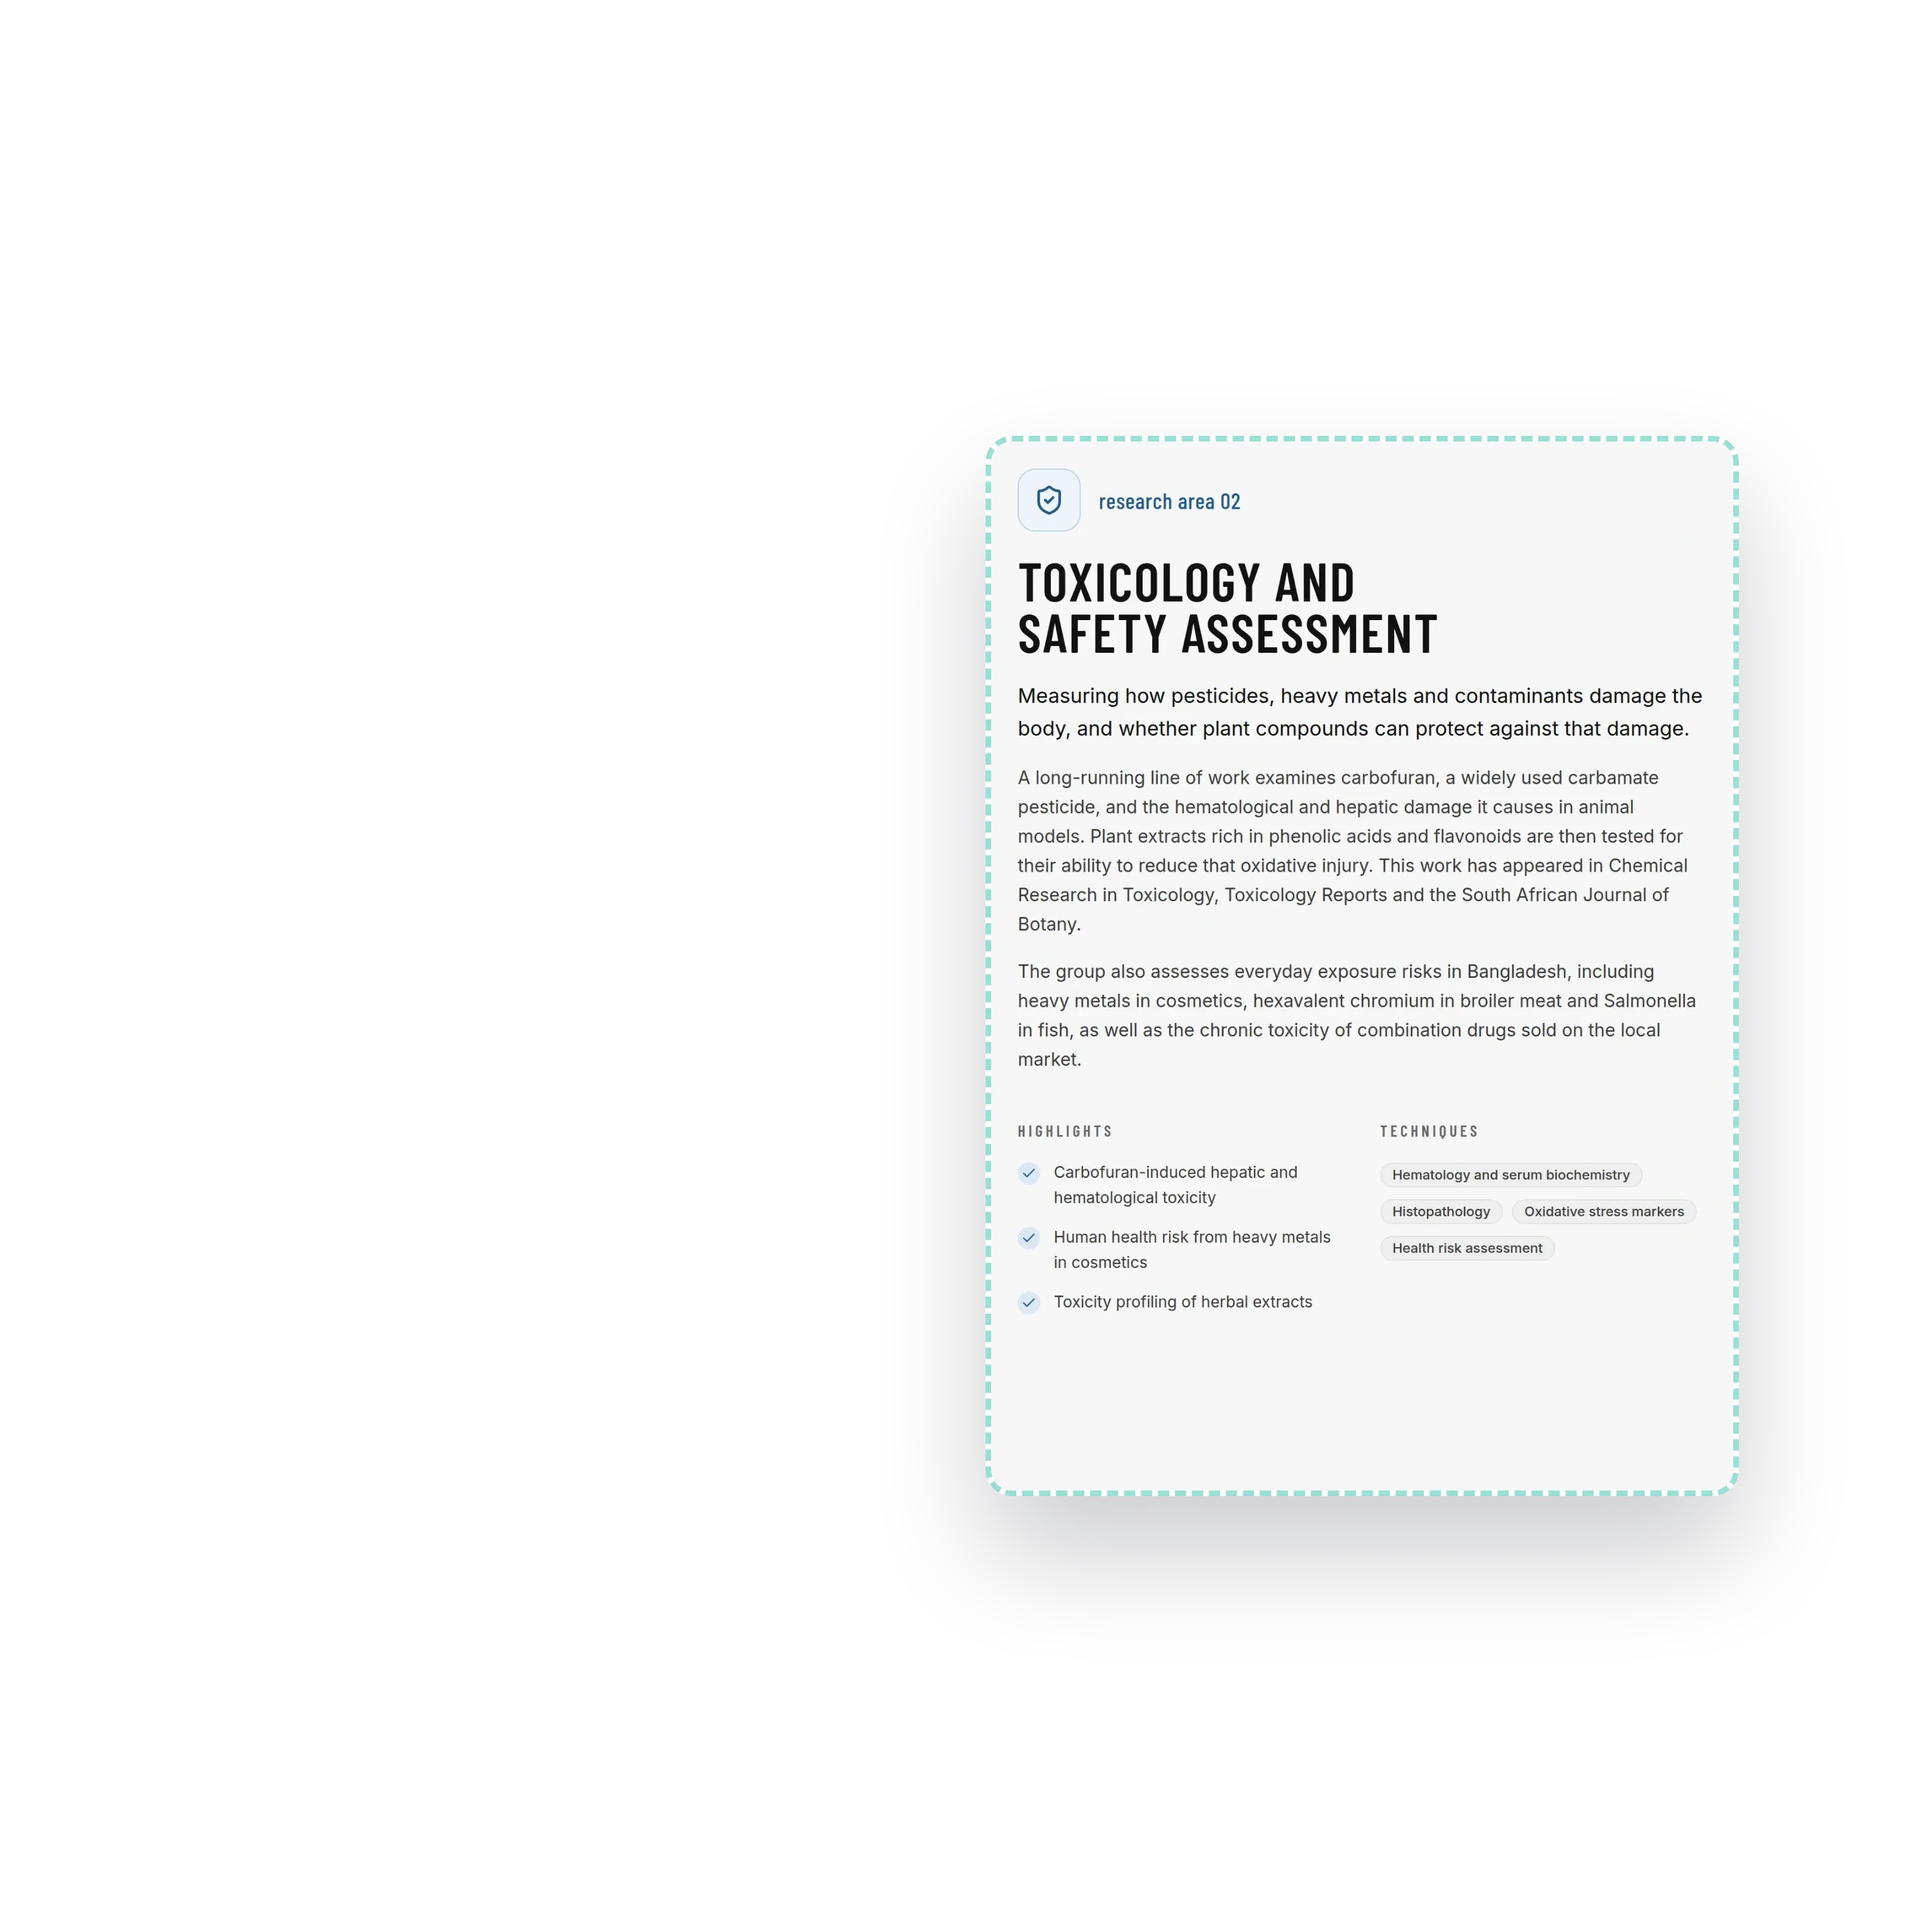
研究页面列出七个方向:植物药理学与草药验证,毒理学与安全评估,计算药理学与分子对接,药物递送与制剂科学,分析方法开发与验证,癌症治疗,以及临床与公共卫生研究。每个方向都写明研究内容、所用技术、亮点和三篇代表性论文,并链接到背后的每一篇论文,因此没有哪个方向只是一个空标题,而七个方向组成的条带会在页面滚动时固定在顶部。
这是替小组做筛选的页面。读到实验室在动物模型中研究克百威毒性,或研究化妆品中的重金属的学生,写出的邮件与只知道这是一个药学系的学生不同。方向下方的方法栏按学科归类技术,对接与 ADMET 分析、HPLC 与溶出度测试、骨架片与水凝胶、动物模型与卤虫致死试验、免疫组织化学,合作者在一屏之内就能看出小组是否做他需要的检测。
每篇论文都可浏览,错误归属也得到诚实处理
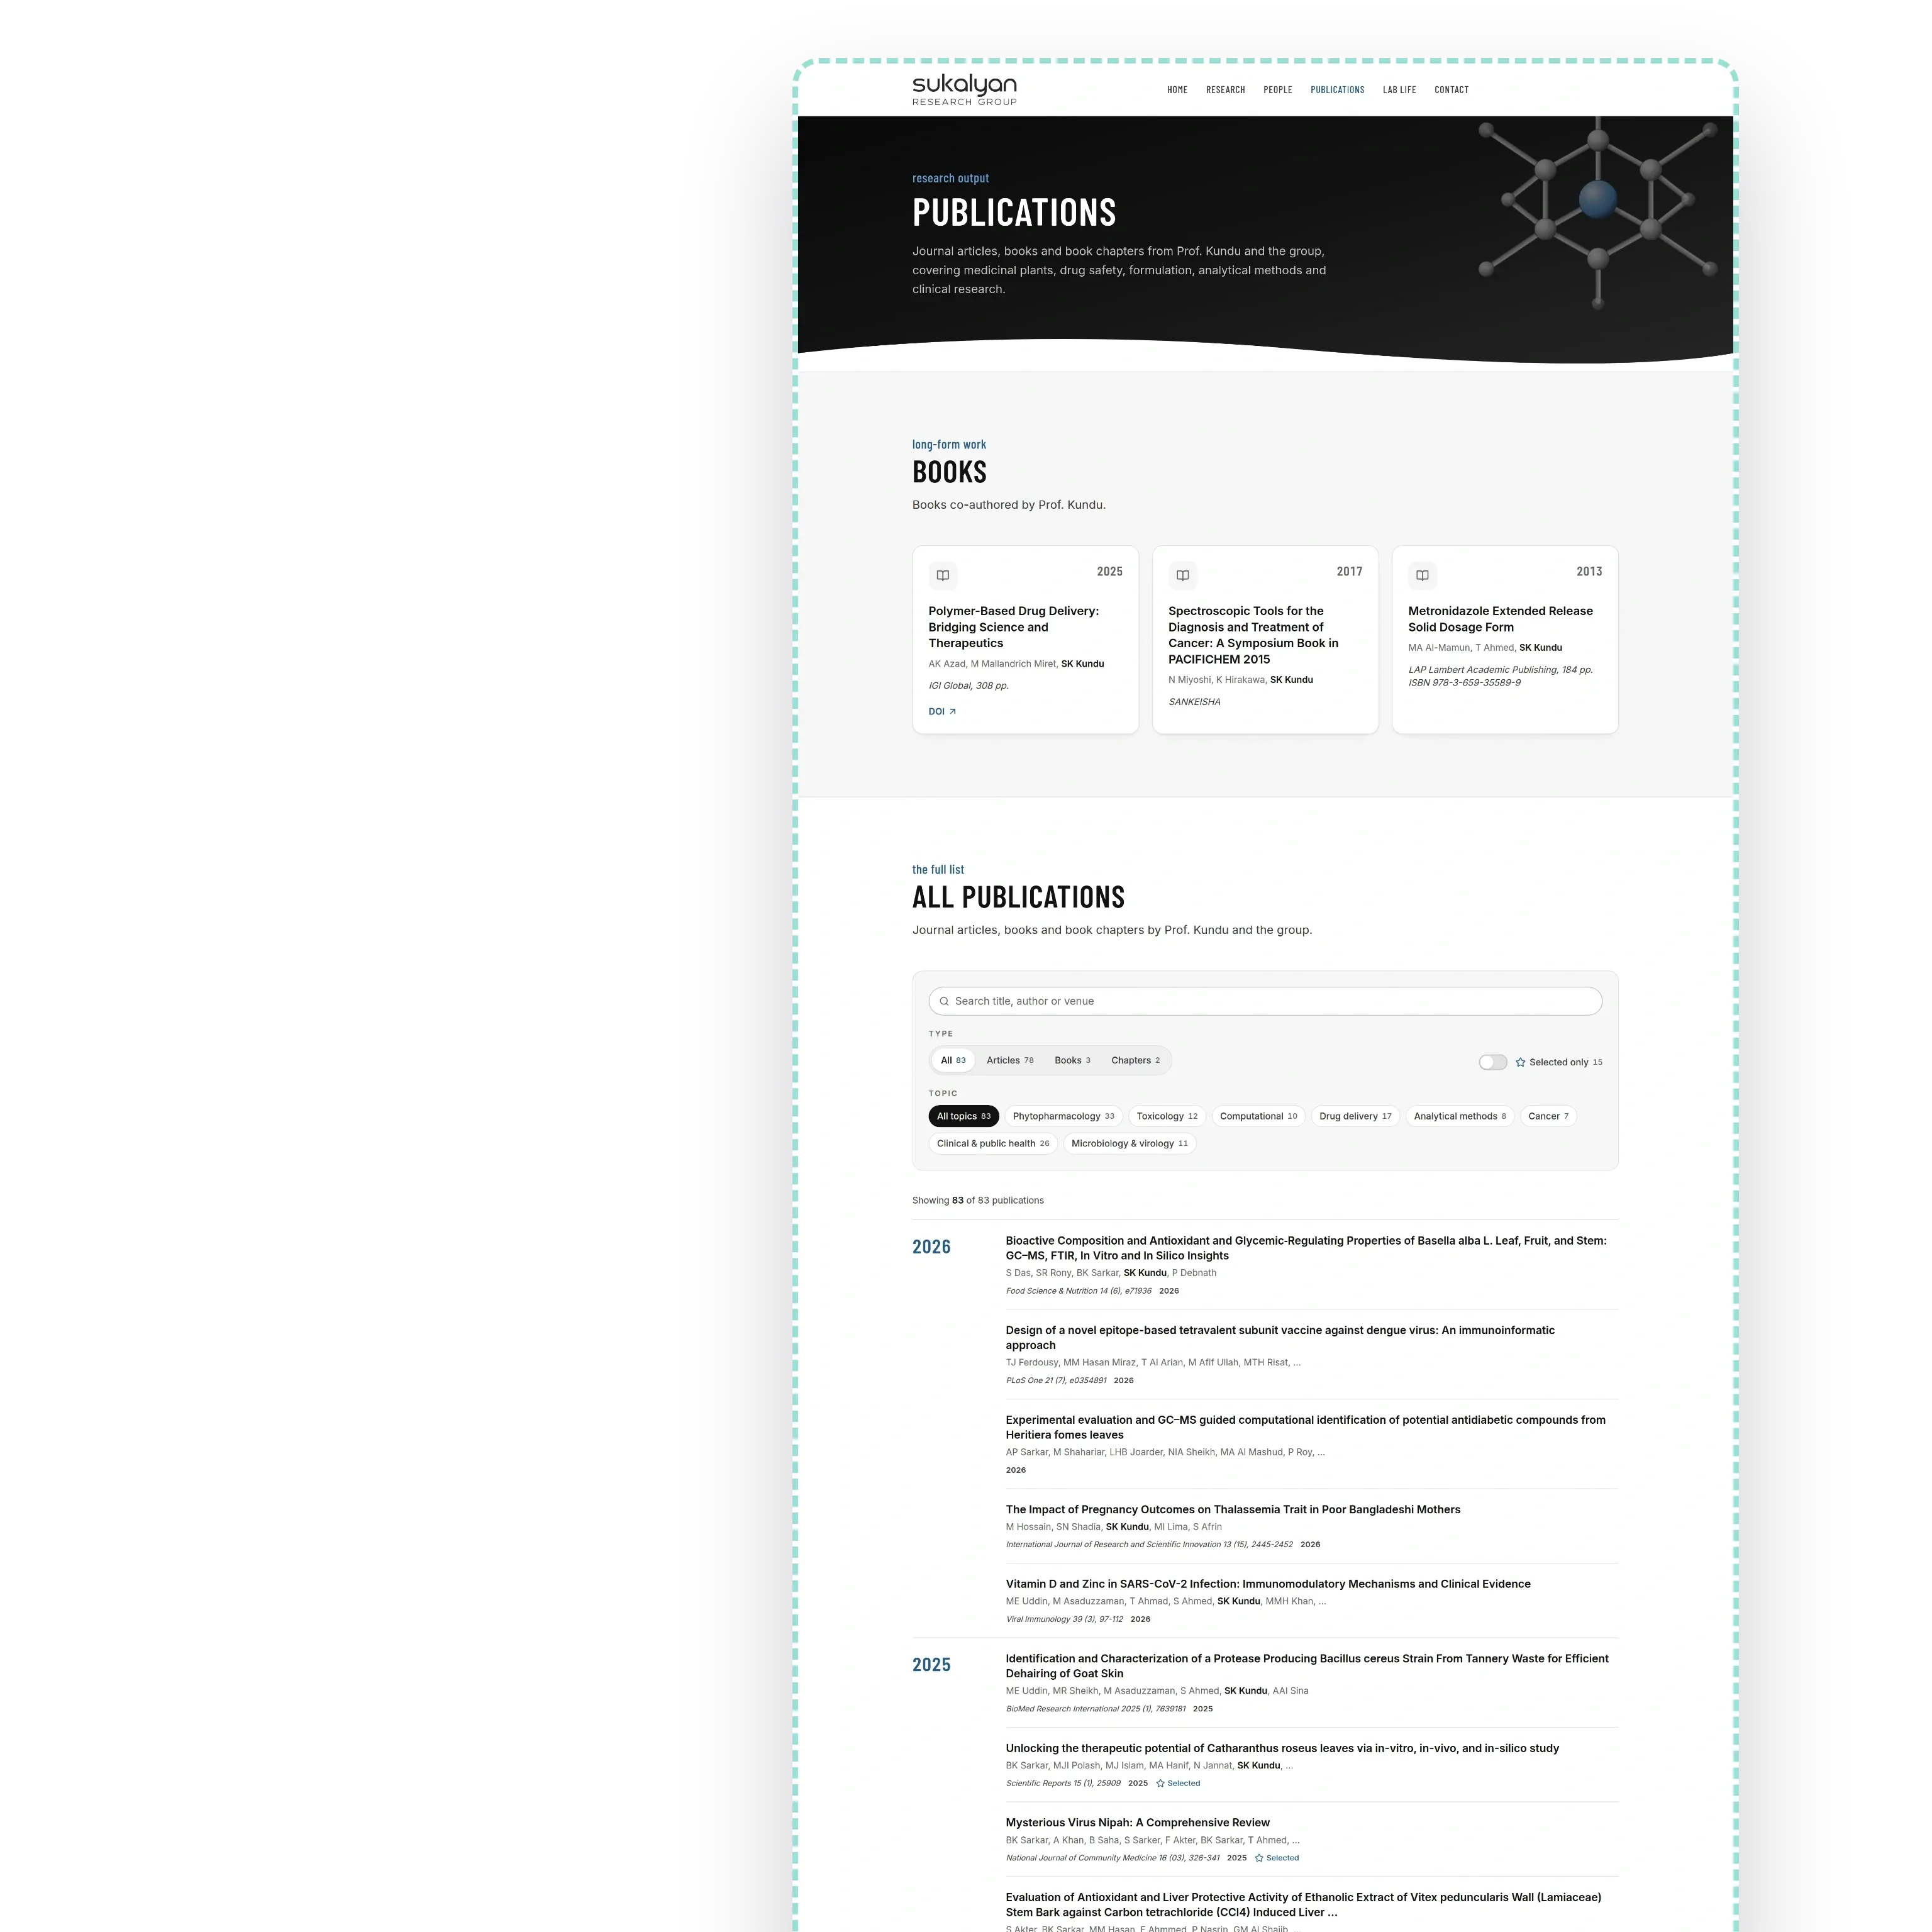
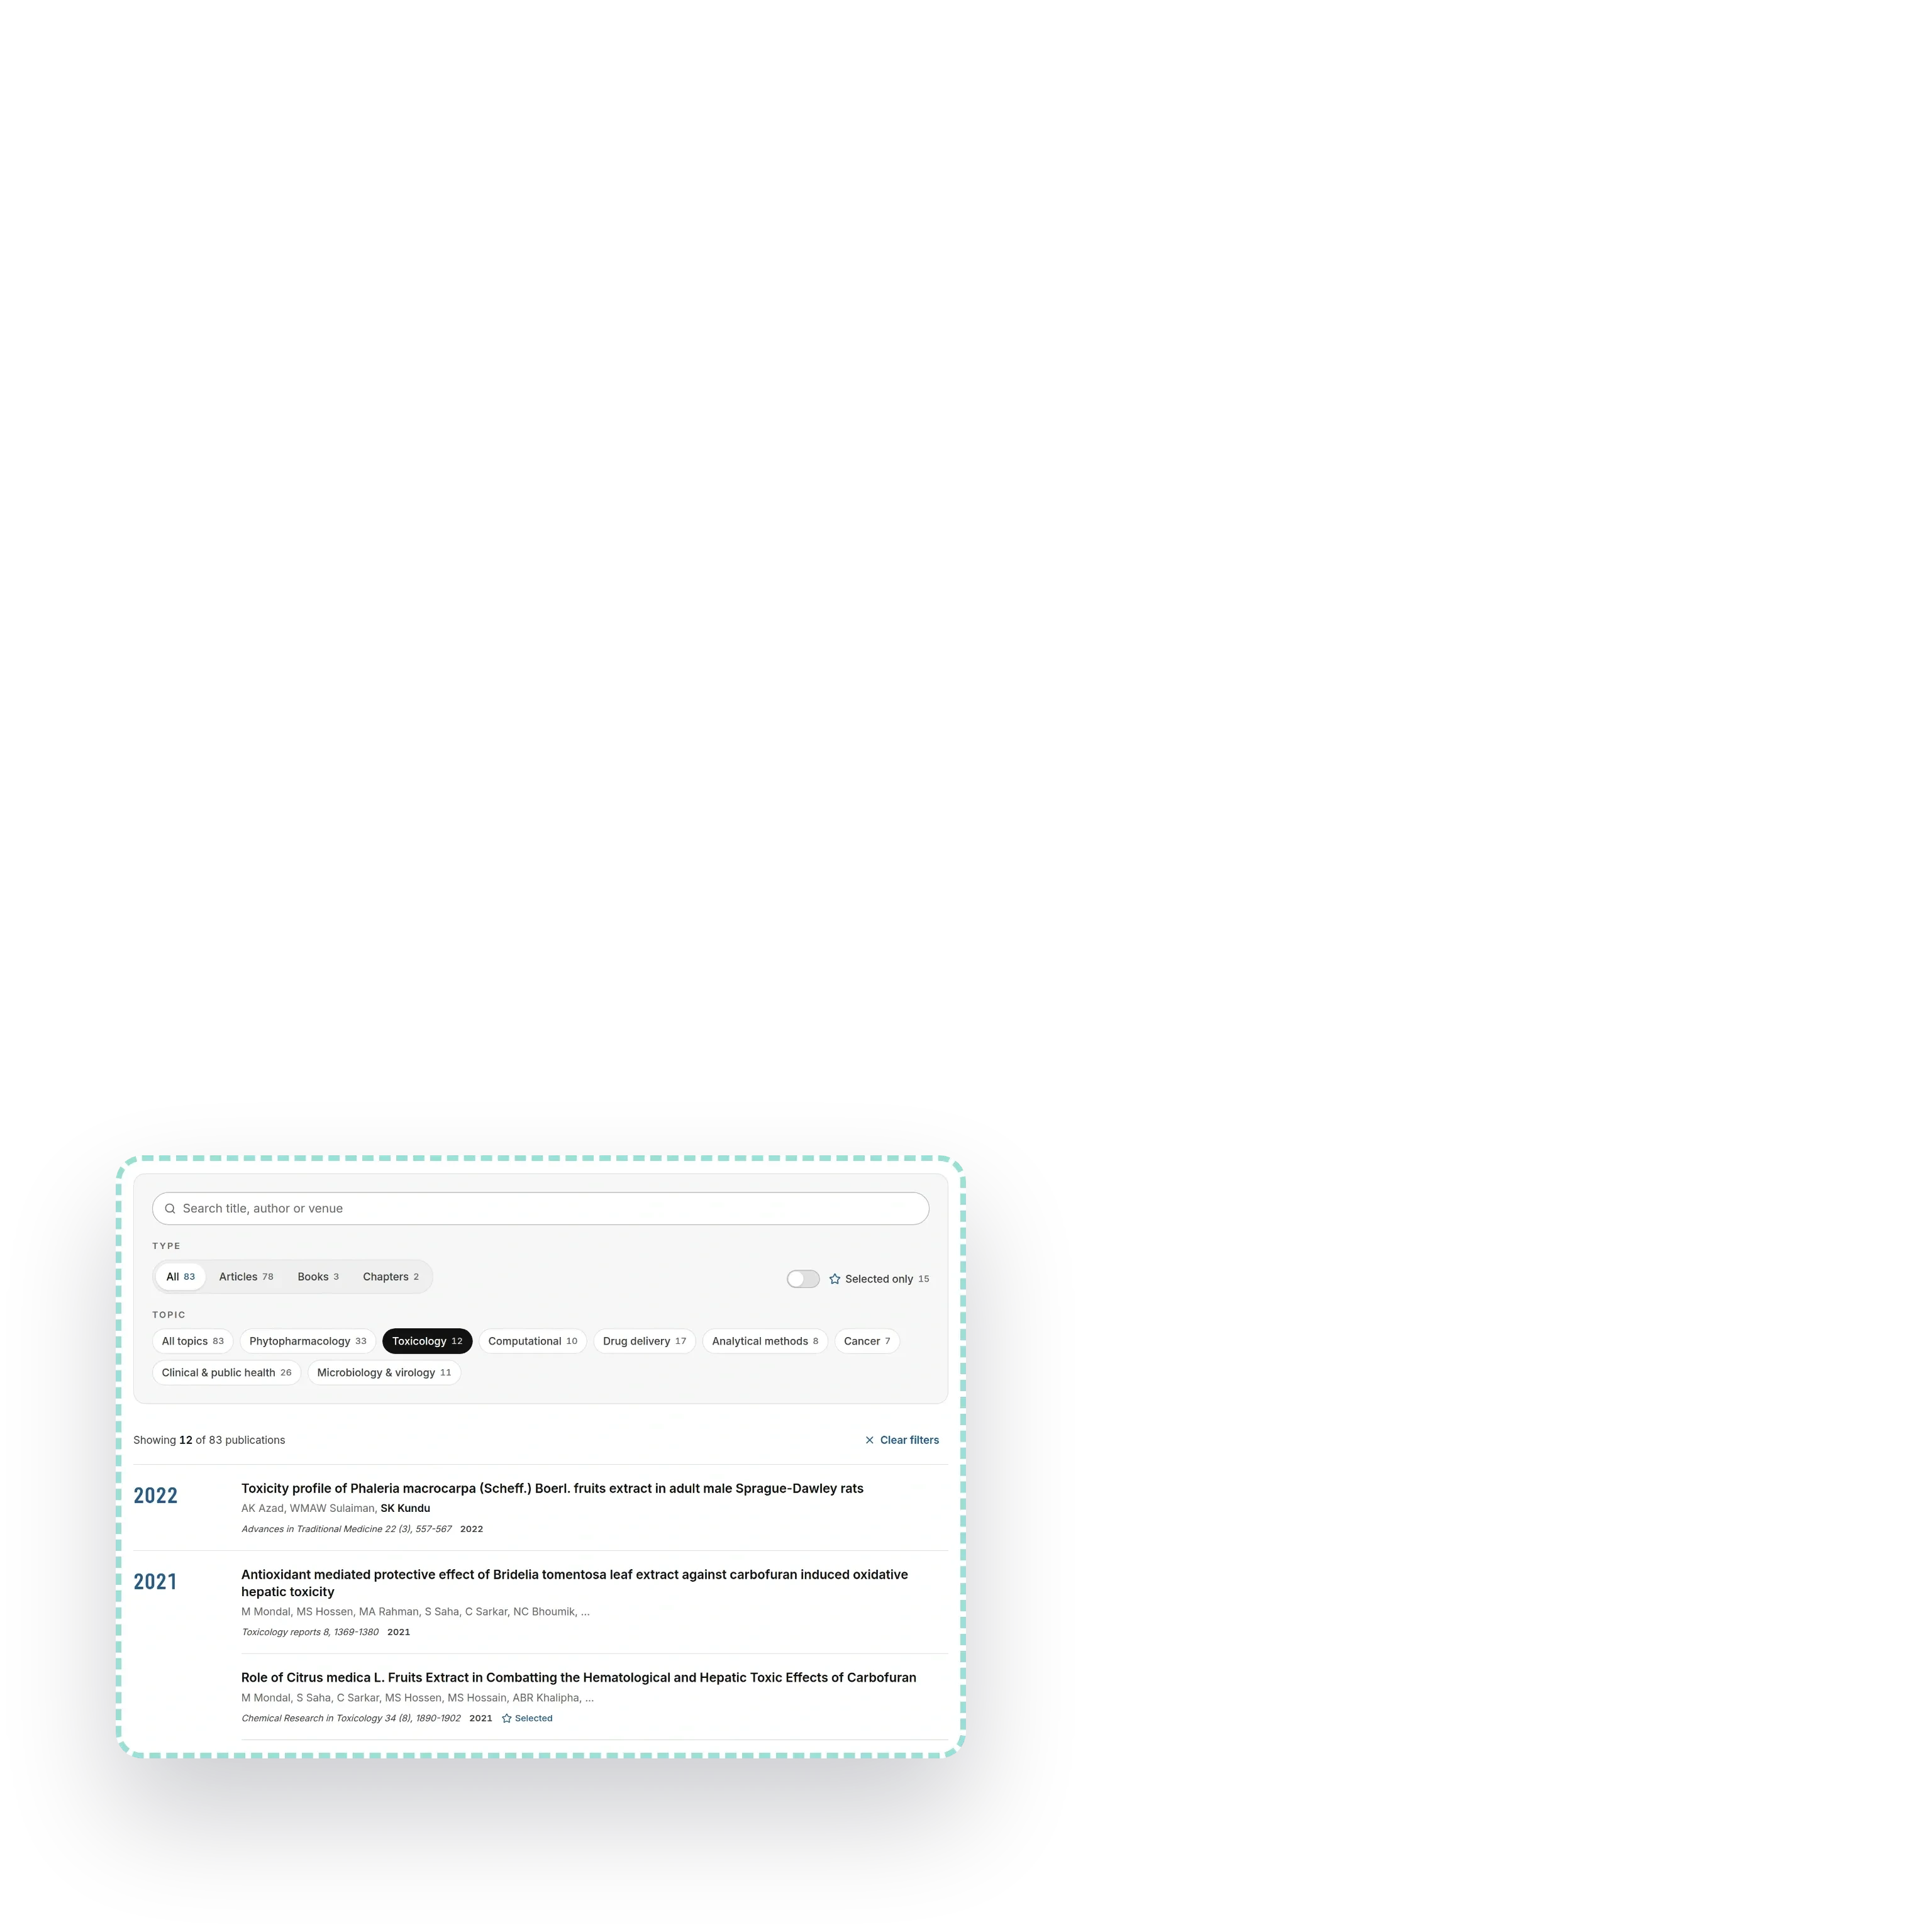
论文页面收录了从 Google Scholar 同步的一百二十四条记录。其中八十三条被显示,按年份归在滚动时固定的标题下,可按类型、主题和自由文本筛选,有一个只看十五篇精选论文的开关,三本书则以独立卡片置于列表之上。每个筛选条件都保存在地址栏中,因此一个研究方向可以直接链接到属于它的十二篇或三十三篇论文。
有意思的是没有显示的那四十一条。Scholar 会把姓名相似的其他作者的论文挂进来,这些记录没有被删除,而是留在内容中,并附有说明每条为何隐藏的评审注释。小组的论文列表是评审者会逐行核对的那一页,一条错误记录的代价高于一条缺失的记录,而隐藏的记录在有人确认的那一刻就能恢复。
按姓名和职位列出的人,以及他们后来去了哪里
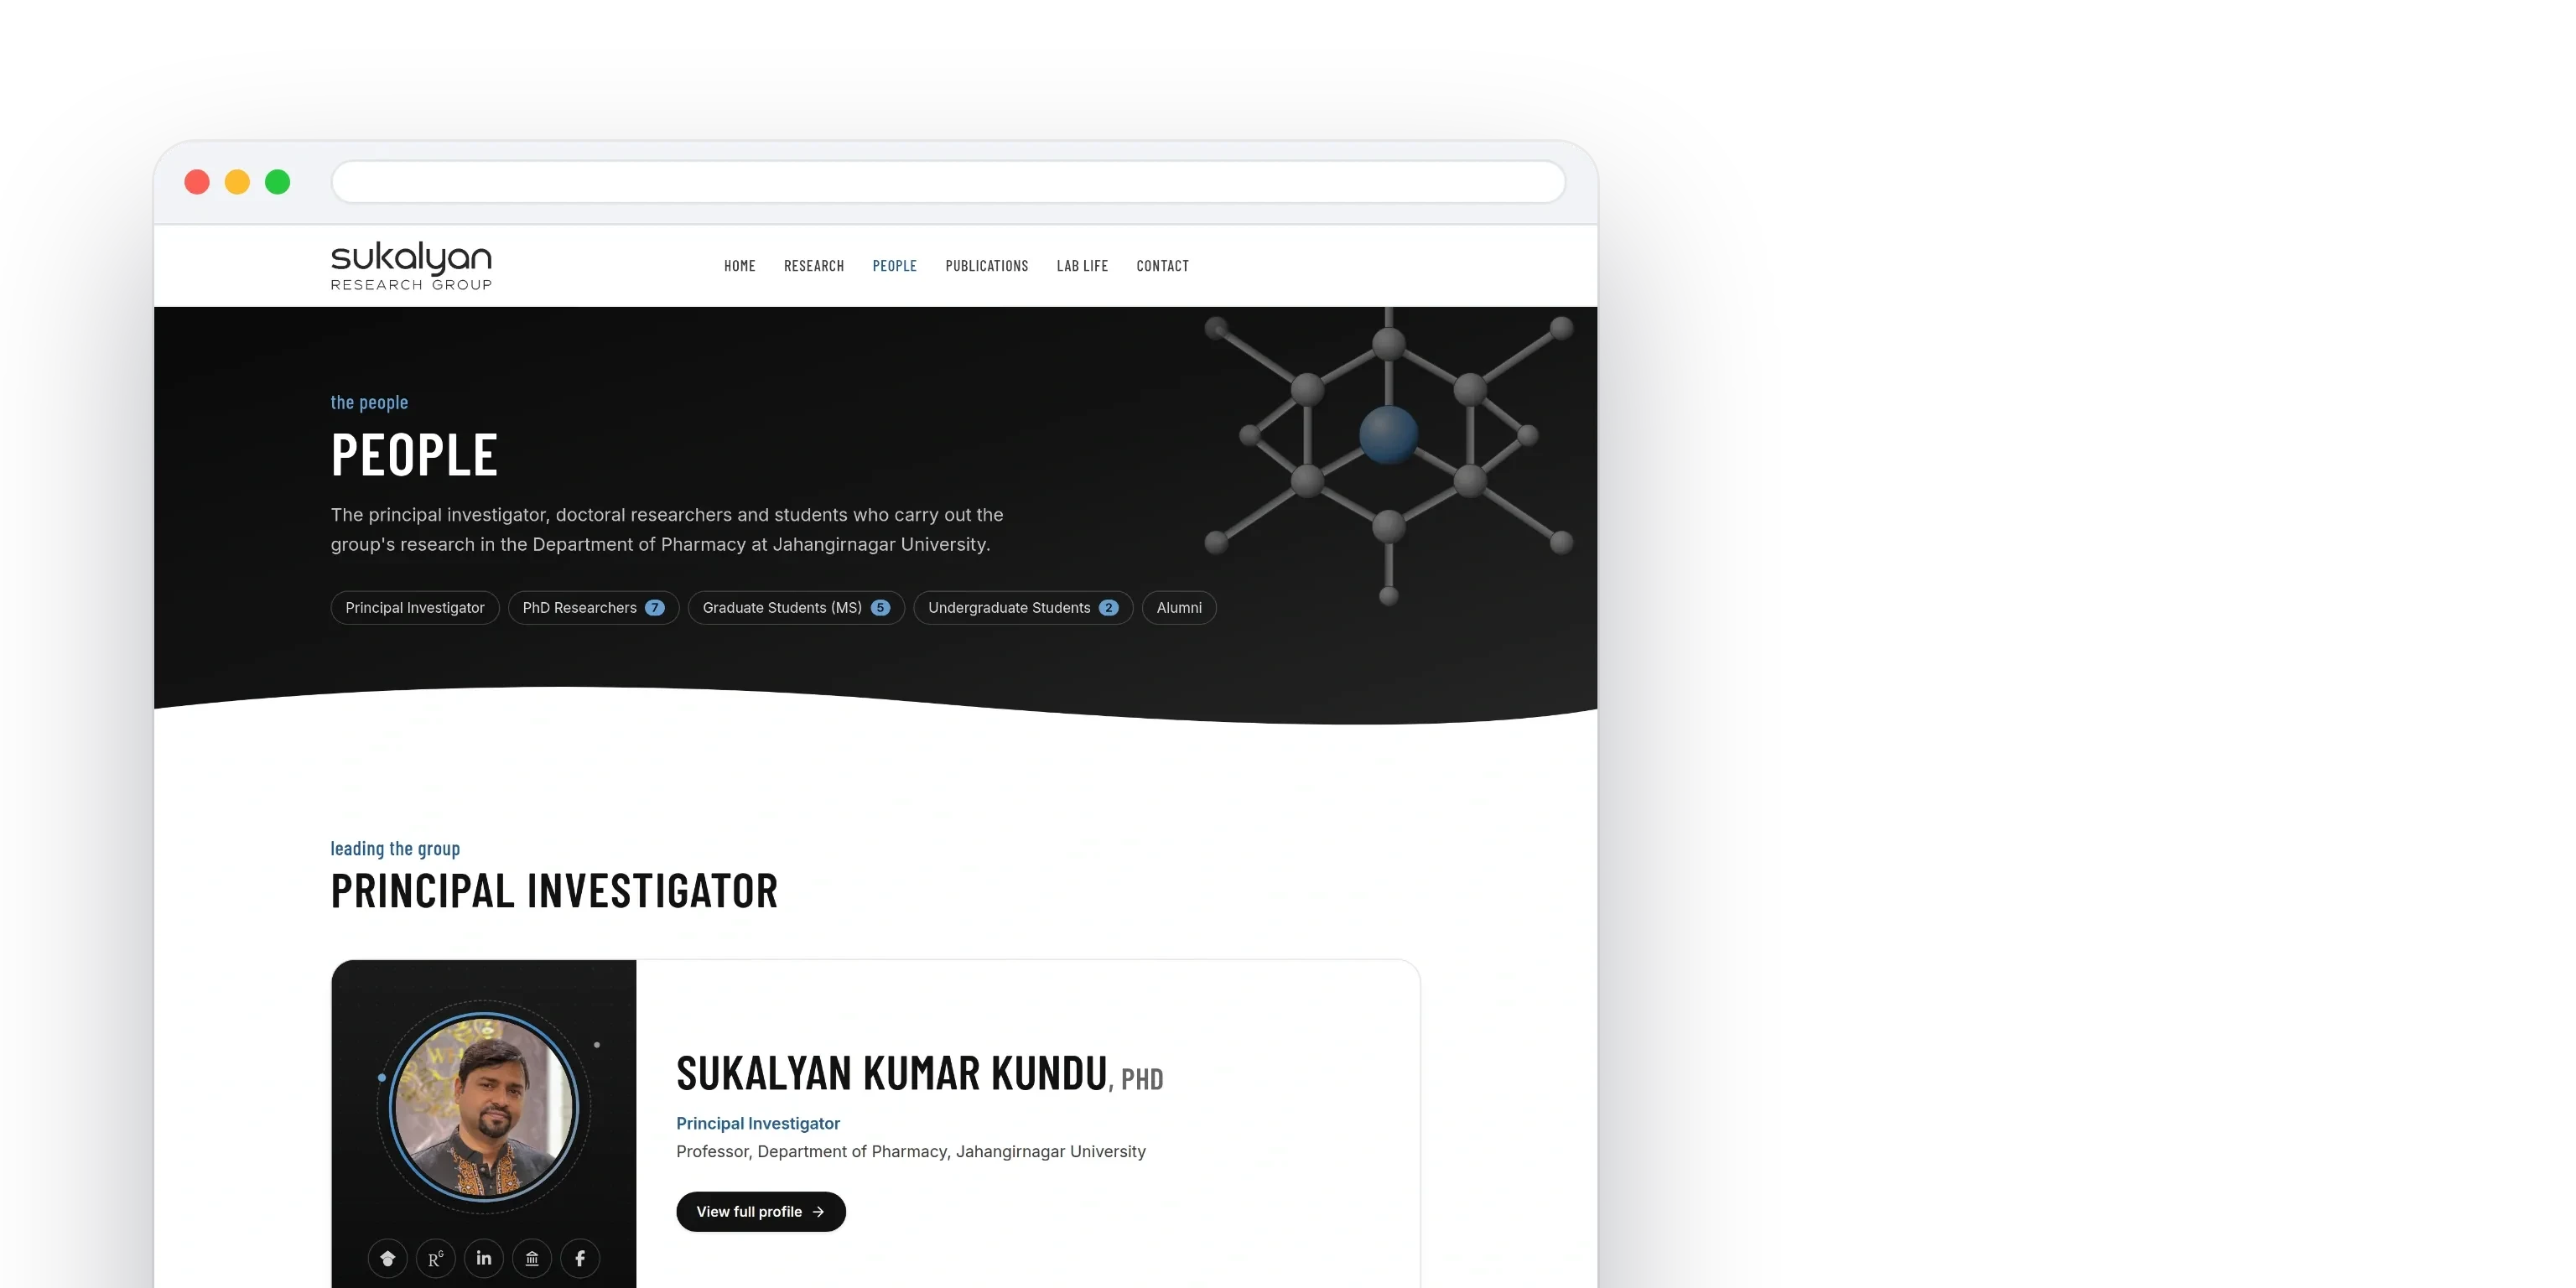
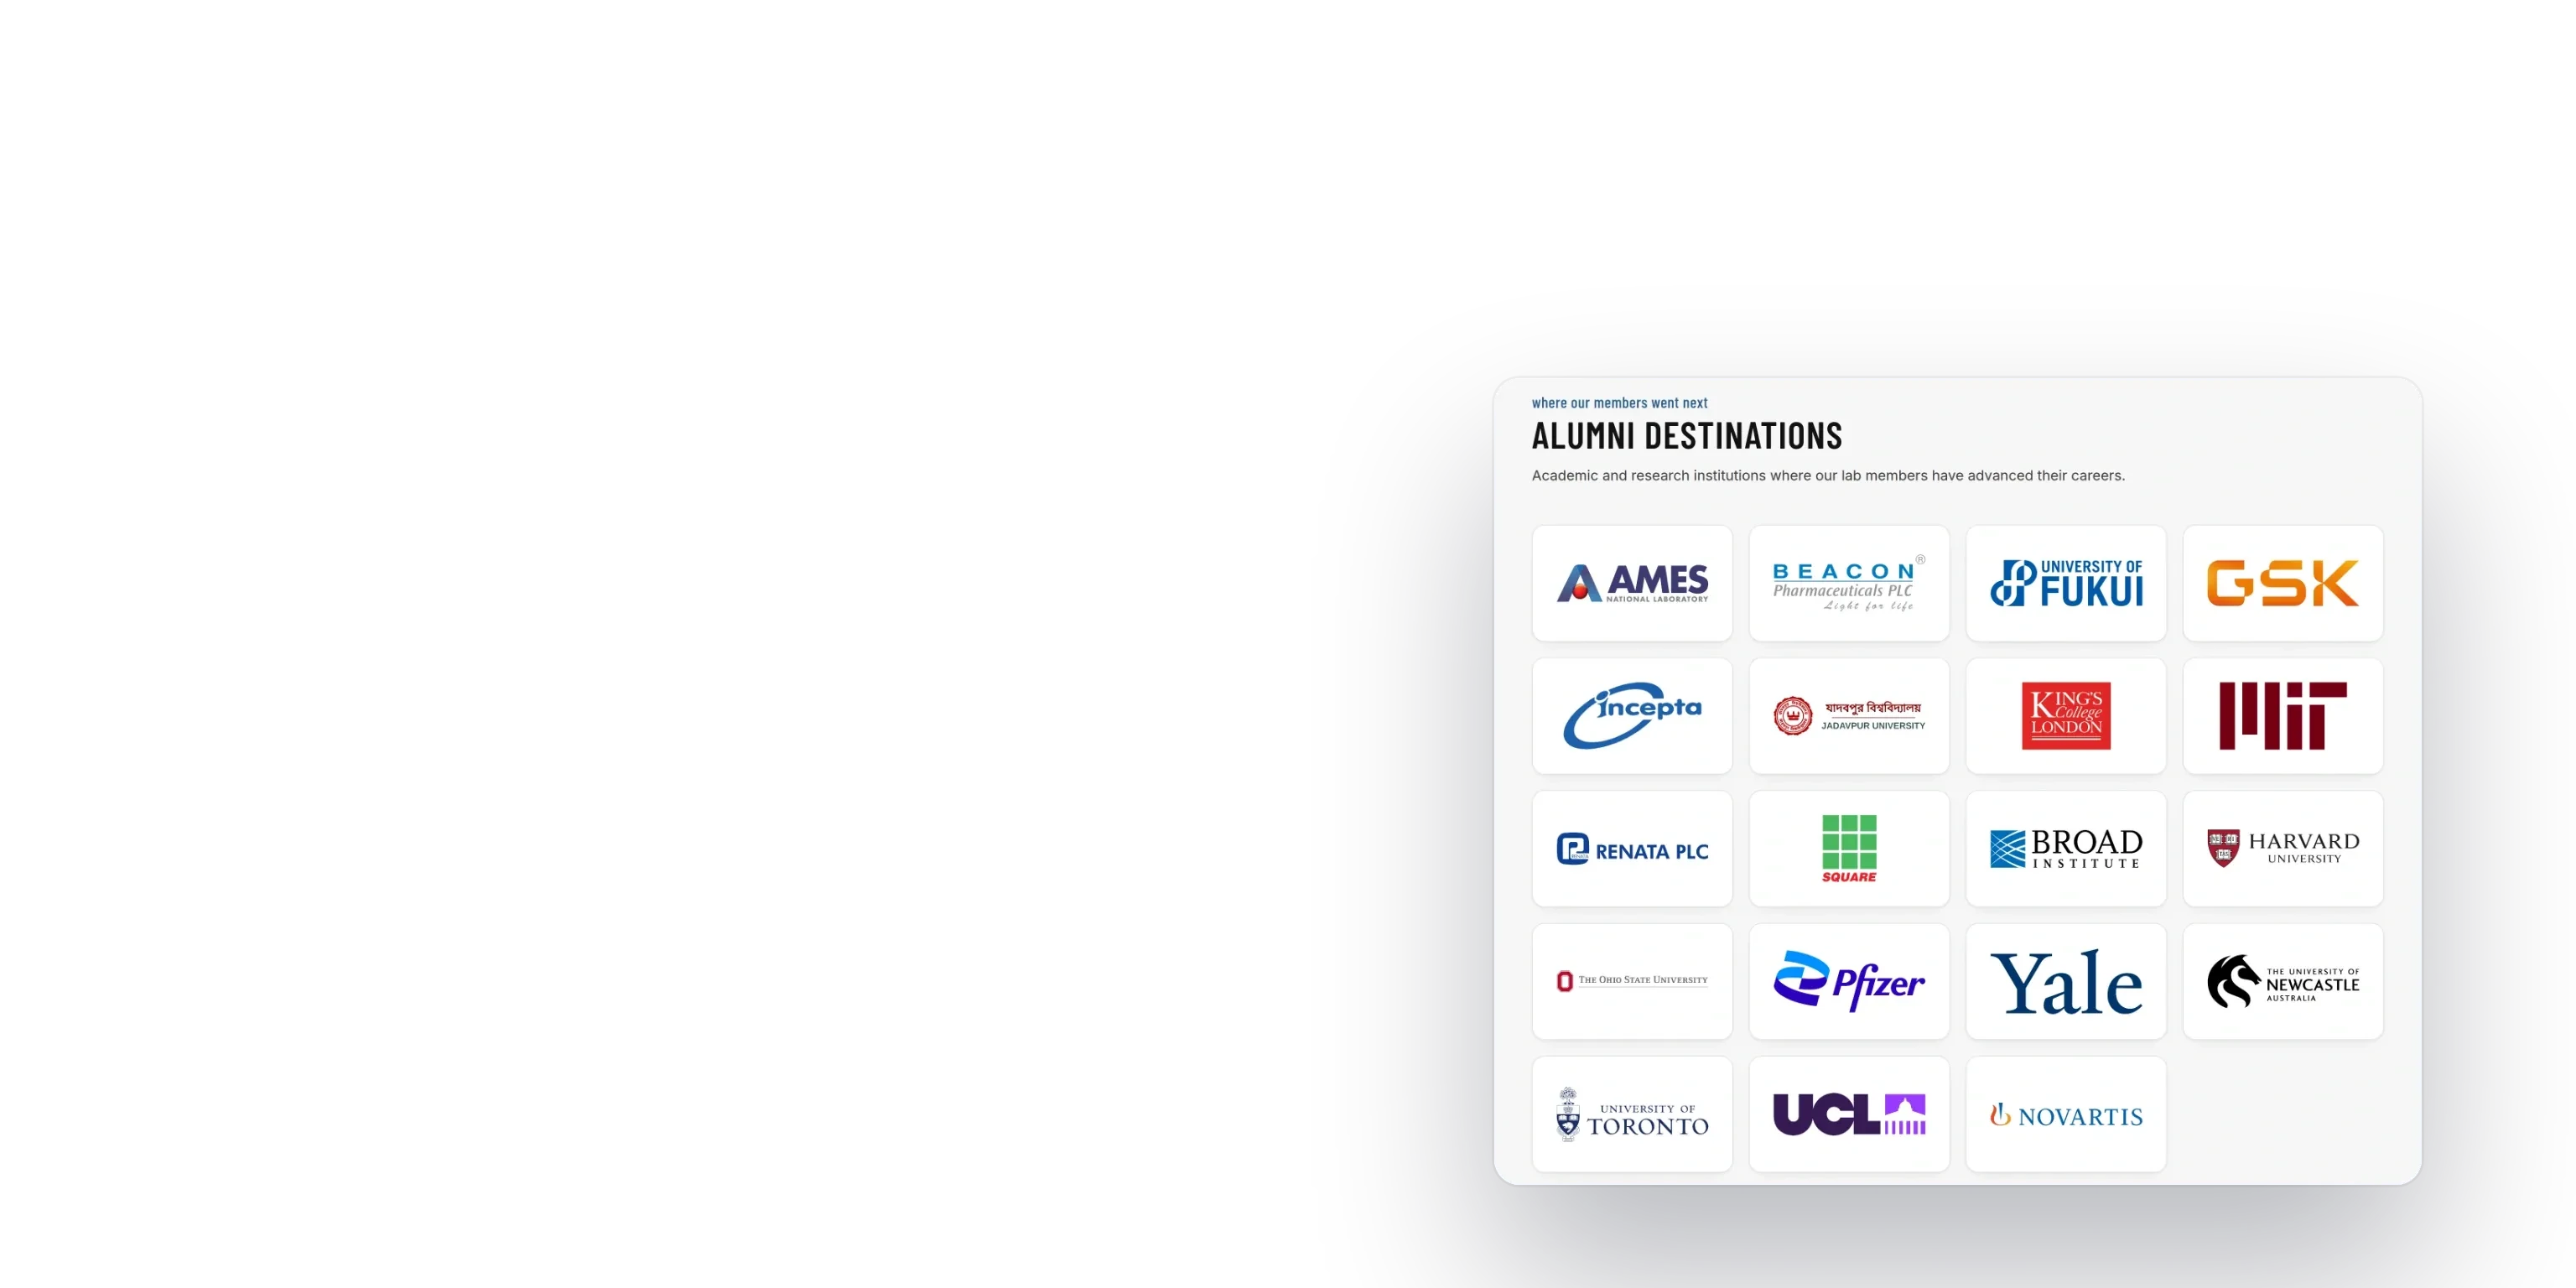
人员页面列出首席研究员,带着五个公开主页和背后的完整简介,然后是七位博士研究人员。研究页面以前成员后来去了哪里收尾:八个国家的十九个去向,从 Harvard、MIT 和 Yale 到 Pfizer、Novartis 和 Square。
一封值得回复的第一封邮件
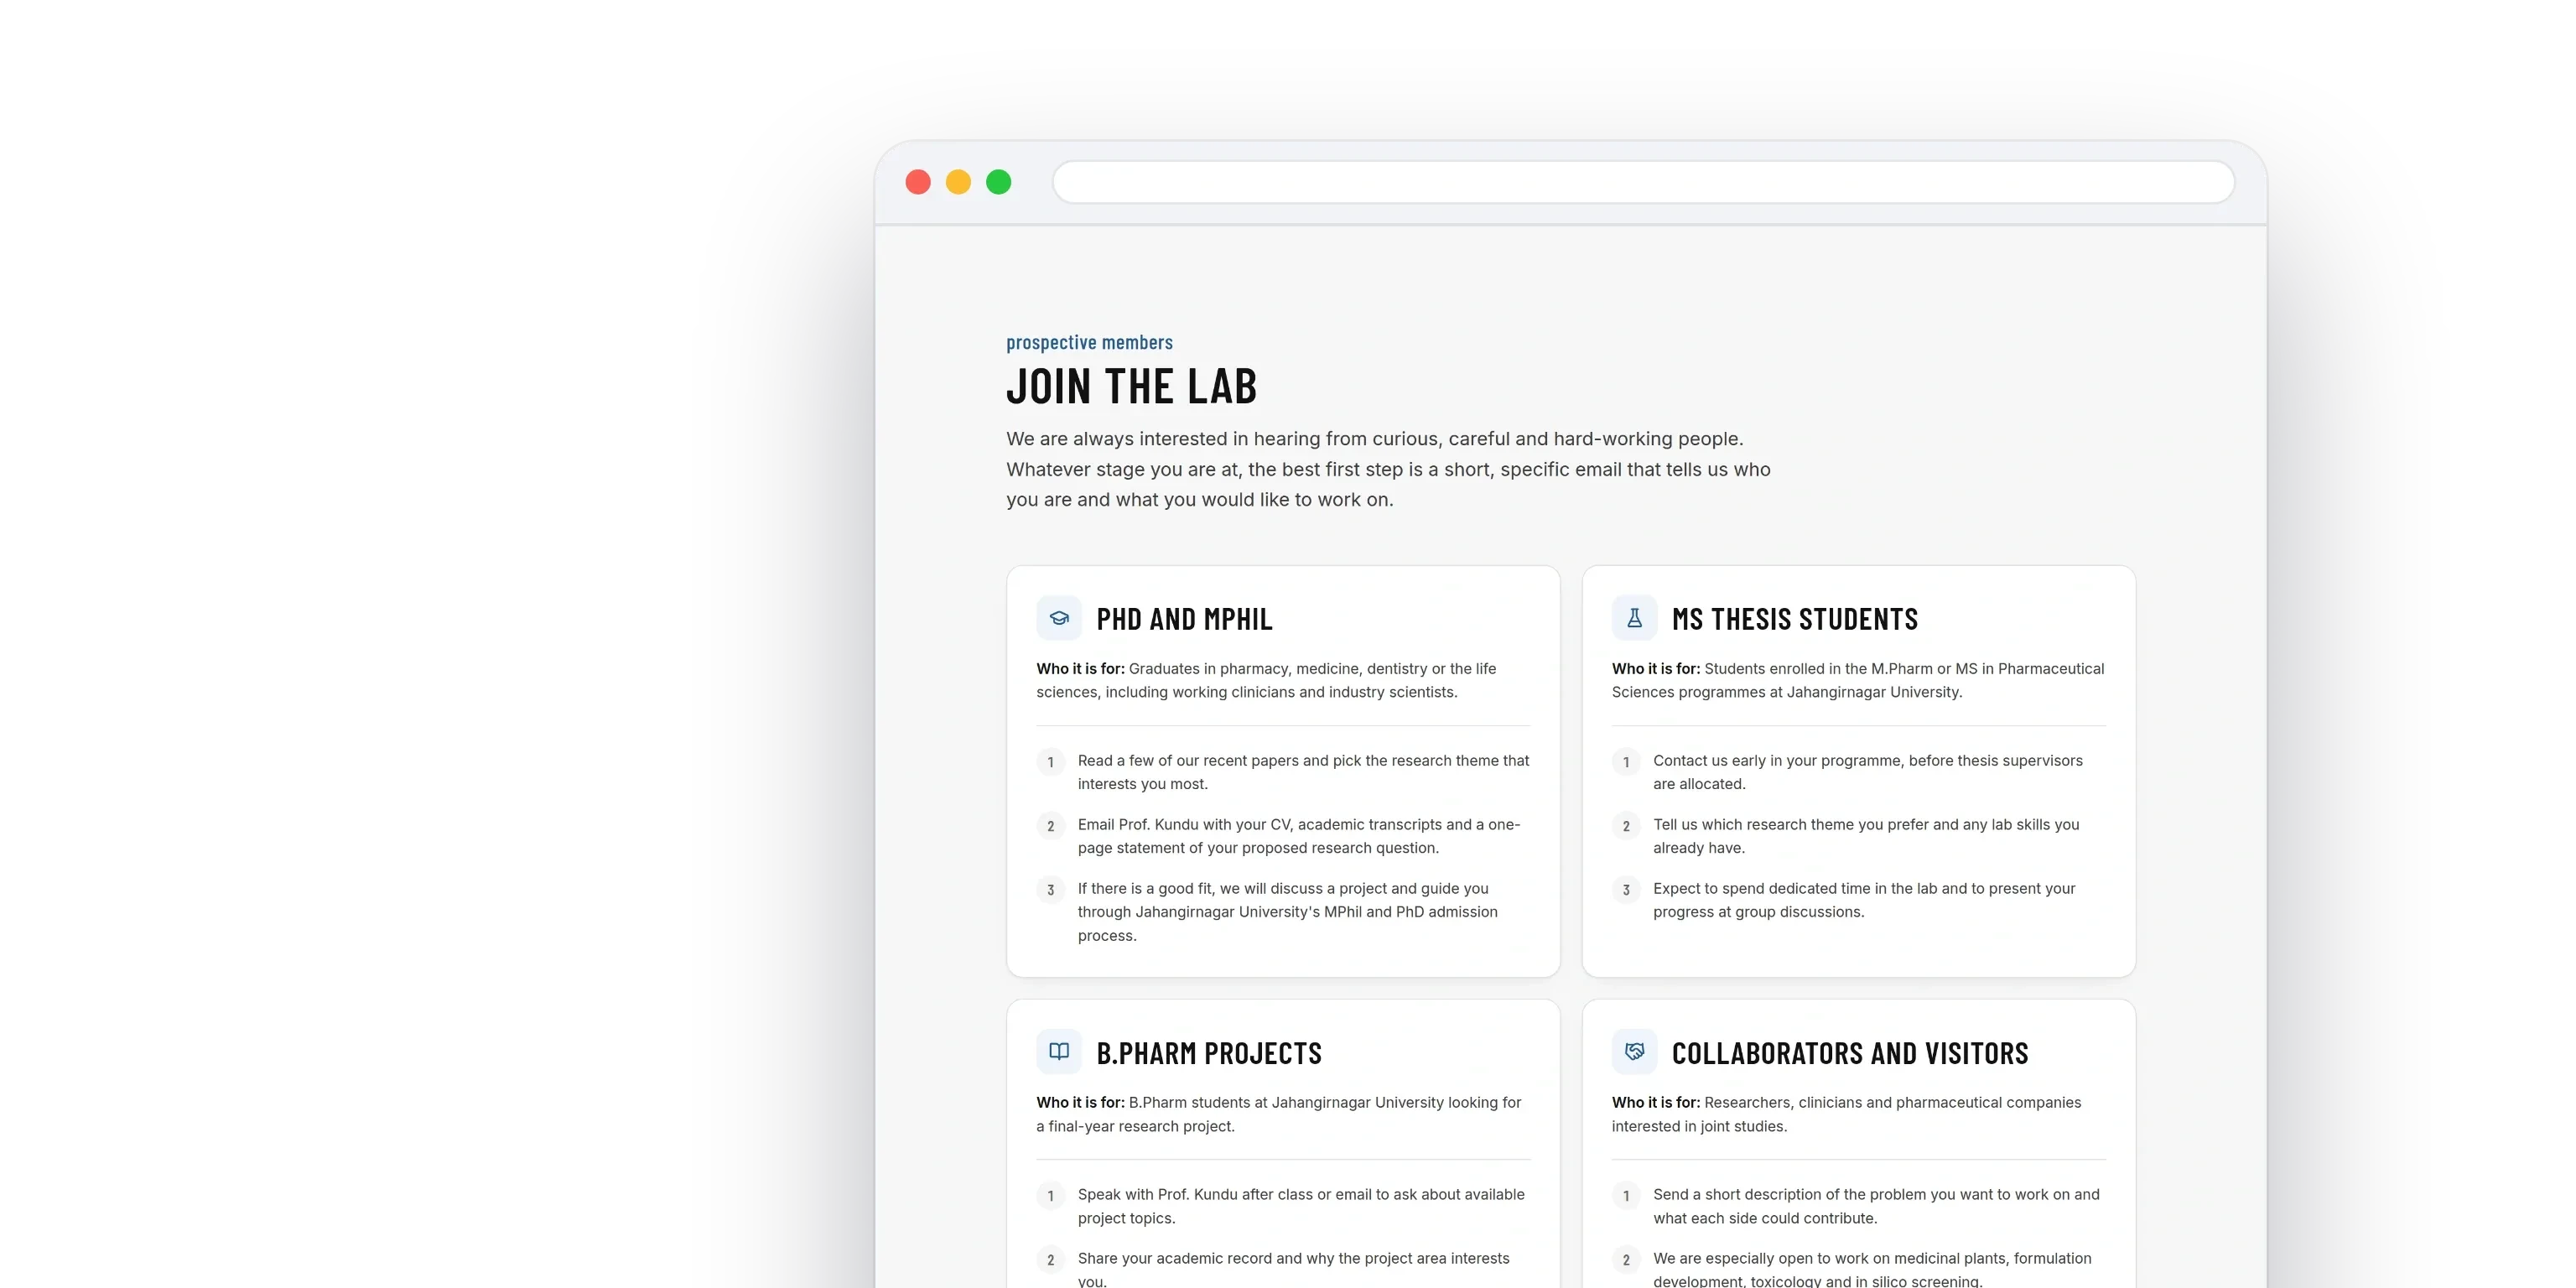
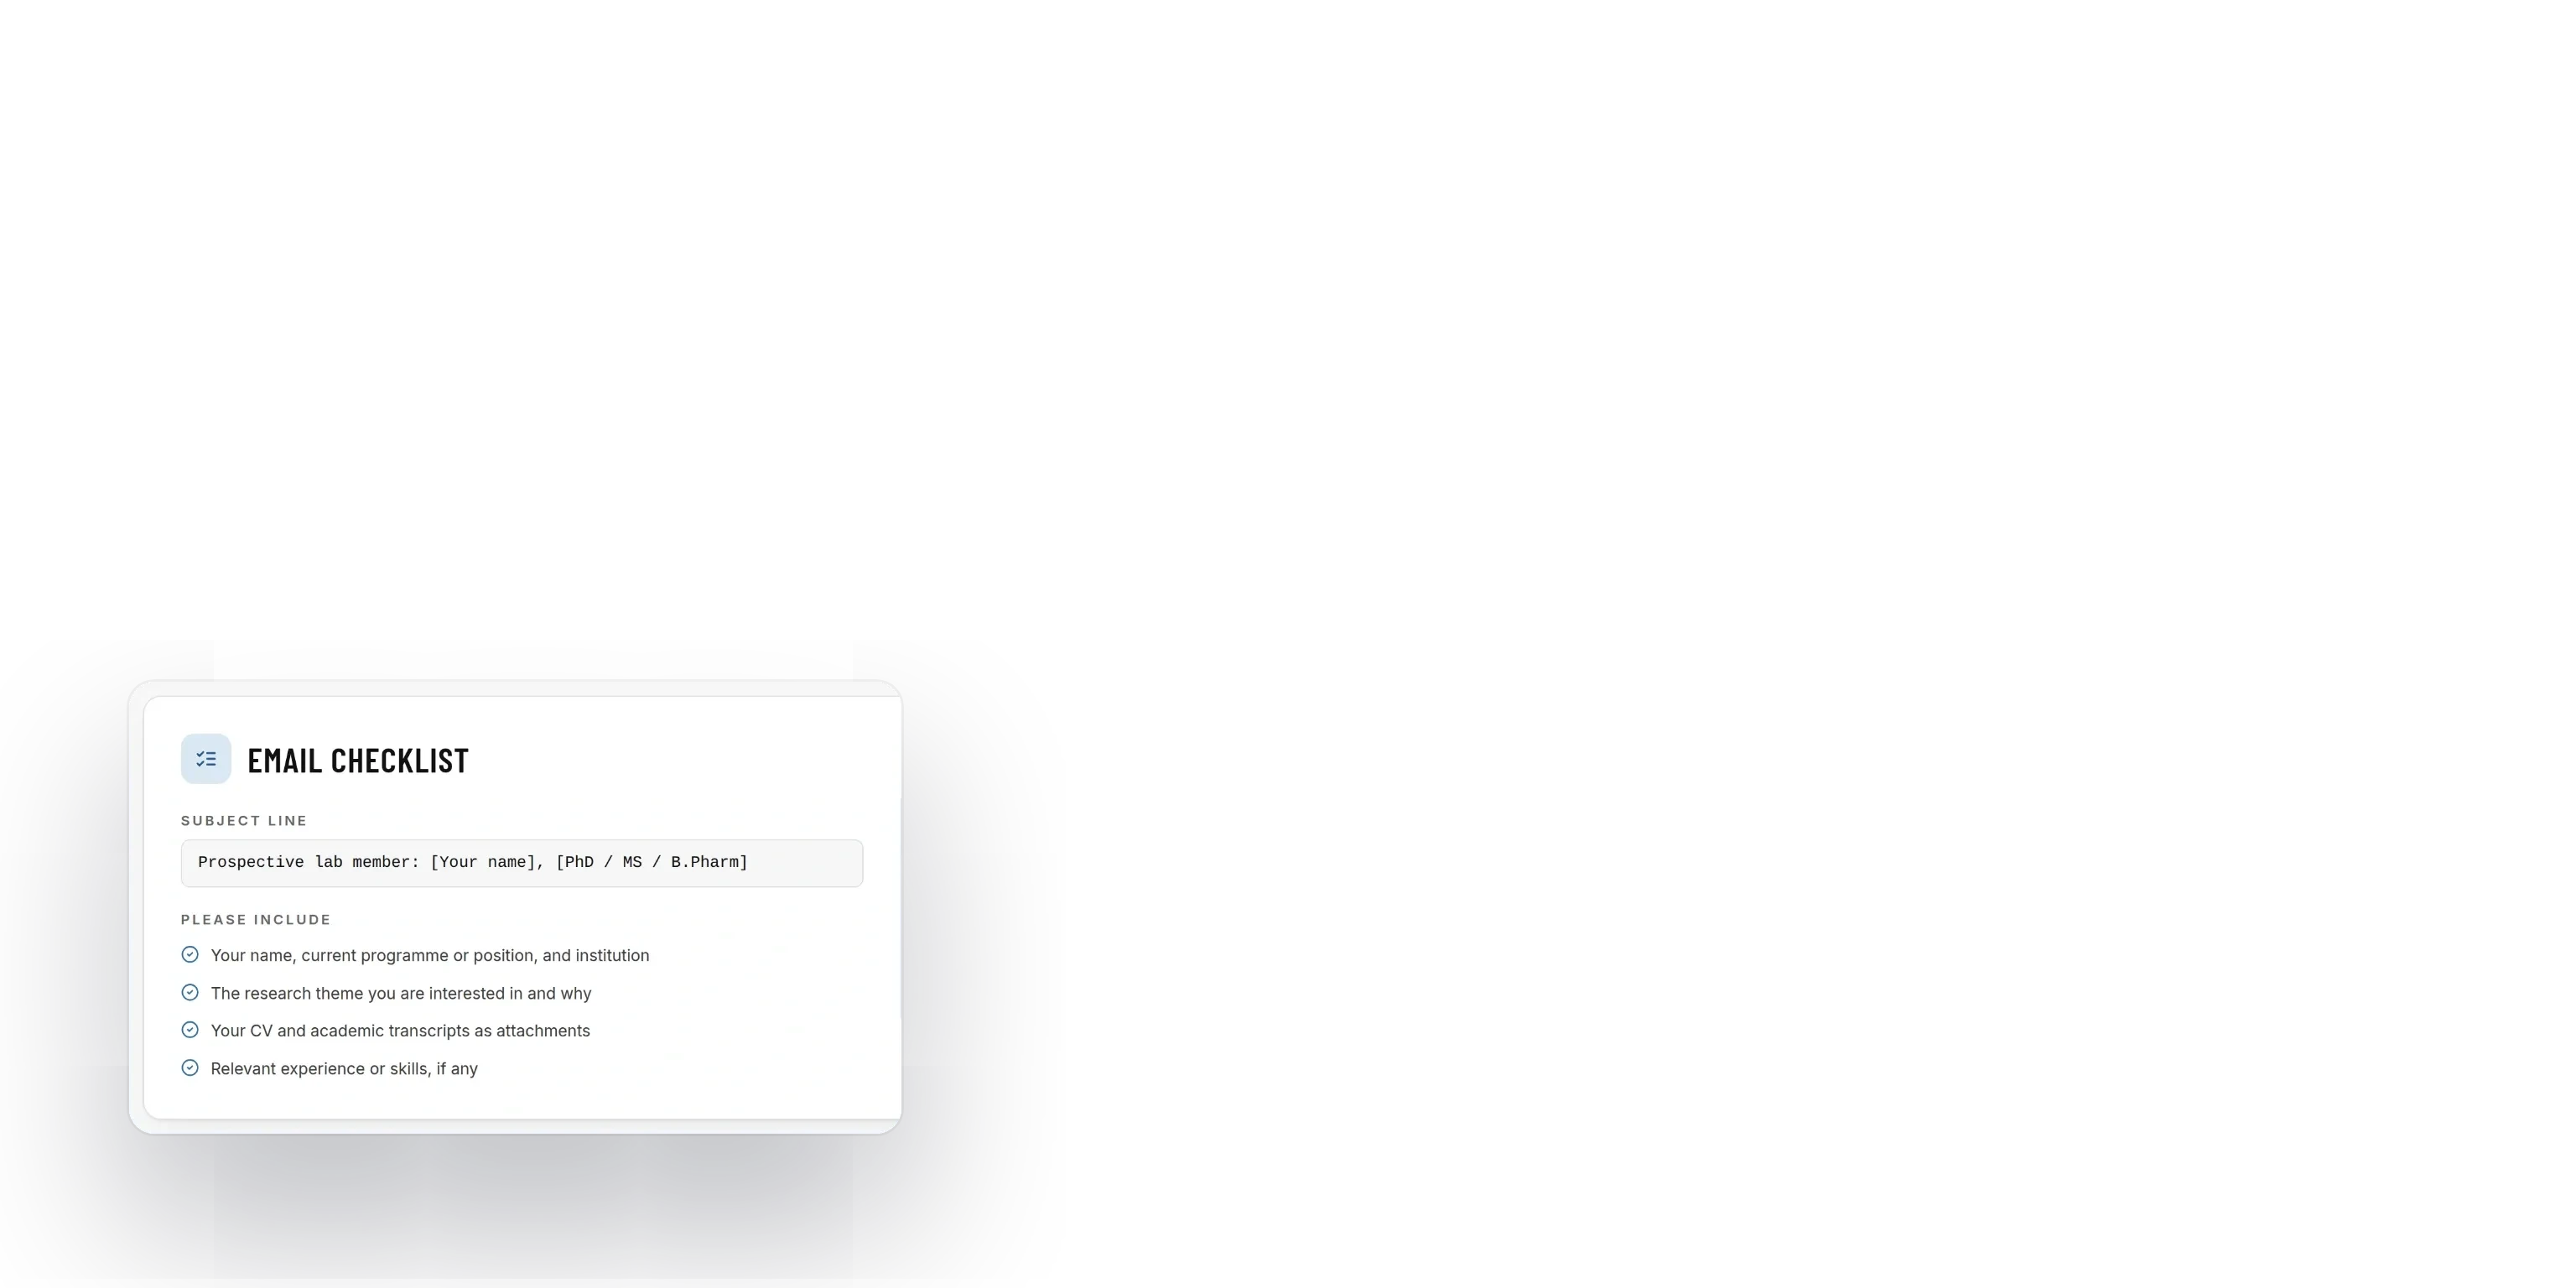
寄给教授的大多数咨询邮件里什么都没有。联系页面用四条路径来回应,博士和 MPhil、MS 论文学生、本科项目和合作者,每条都写明面向谁以及按顺序的步骤,然后是一份清单和一个主题行,一个按钮就把它们放进邮件应用。学生在第一封邮件而不是第三封里就寄出简历、成绩单和一个研究问题。
现在为静态托管而建,将来无需重写即可迁至 CMS
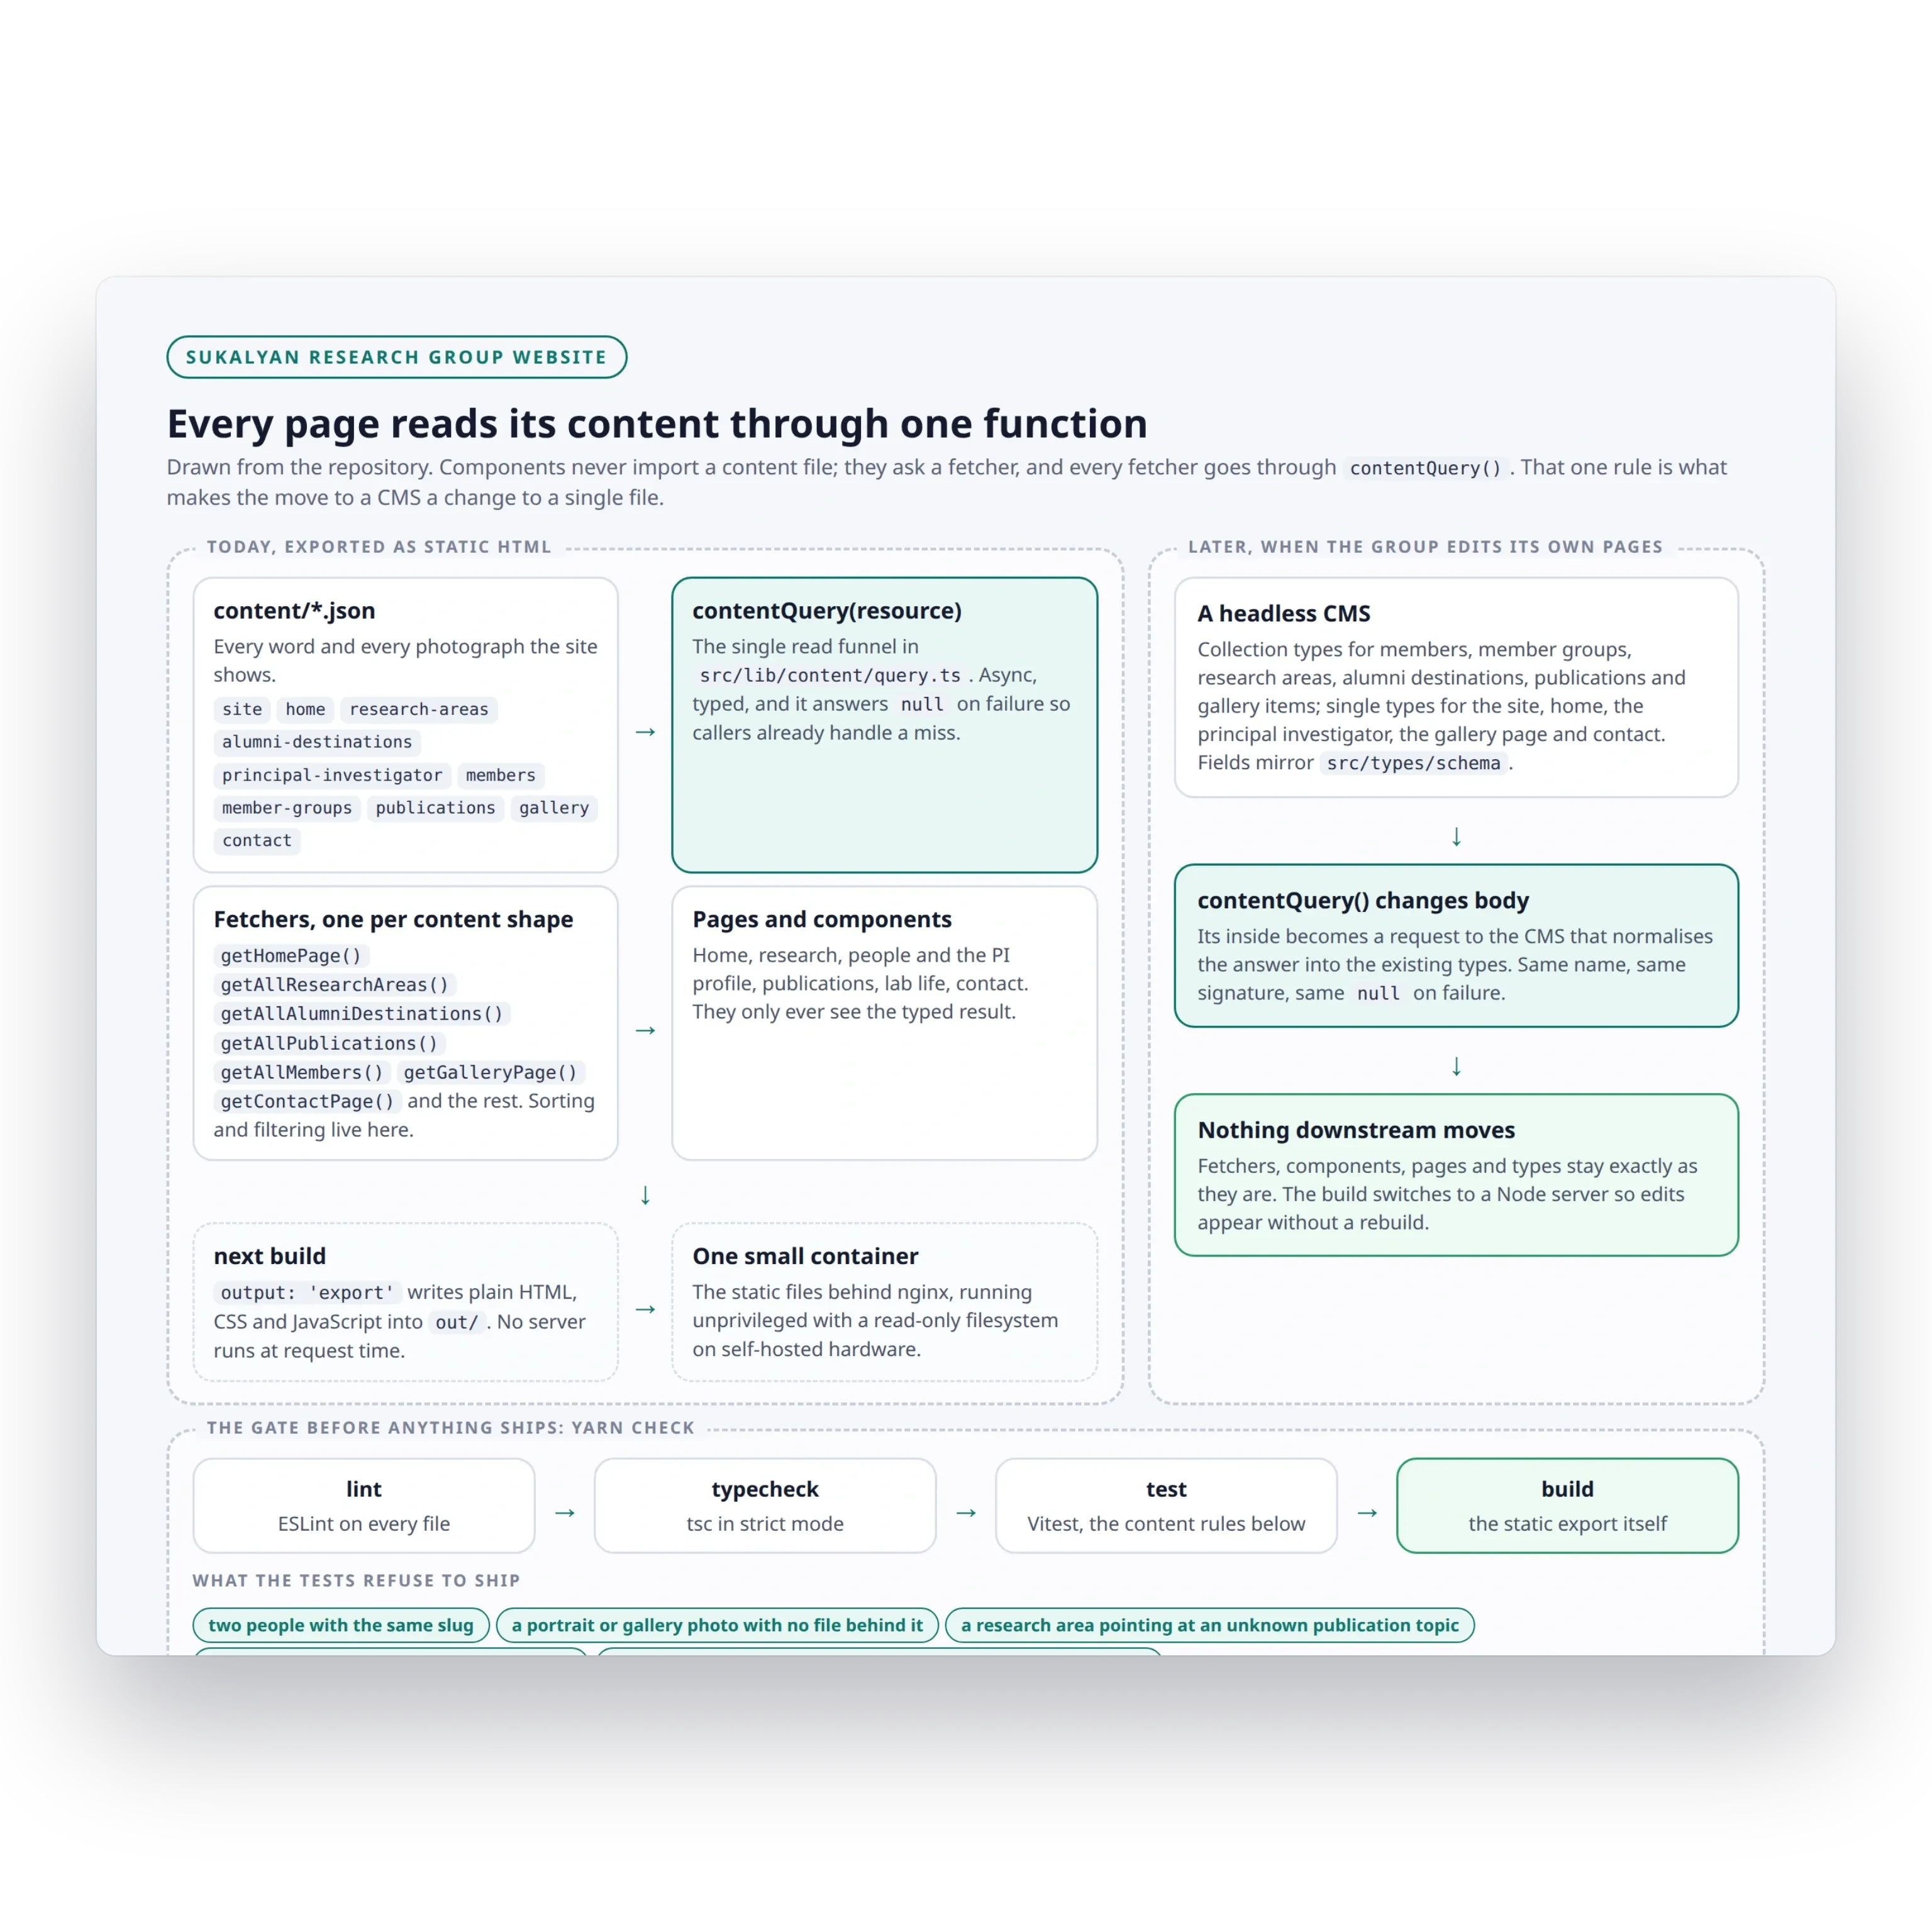
网站上的每个字和每张照片都存放在内容文件中,位于唯一的查询函数之后,没有任何组件直接读取内容。正是这一条规则让下一步变得便宜:当小组准备好自己编辑页面时,把查询指向一个无头 CMS,页面、组件和类型完全保持原样。一整轮改动,包括调色板、标志、人员卡片、图库、校友墙和论文页面,都在一个版本中上线,而每一处改动都只是一个内容文件或一个组件;查询函数和部署没有动过。今天网站导出为静态 HTML,由一个小容器作为普通文件提供,所以它即时加载,维持运行几乎不花钱。
任何东西上线前的关卡是一条命令,运行代码检查、类型检查、测试套件和构建。测试检查的是真正会破坏一个研究网站的东西:没有两个人共用一个 slug,没有指向不存在文件的肖像或图库照片,没有链接到不存在的论文主题的研究方向,首页至少有一篇精选论文,还有一次扫描,只要源码、内容或 README 中任何地方出现破折号,构建就会失败。
小组现在拥有什么
一个承载全部记录的地址,陌生人一分钟就能看懂的研究,经得起逐行阅读的论文列表,按姓名和肖像列出的在这里工作的人,小组自己的照片,以及一条告诉每类申请者到底该寄什么的加入途径。网站作为一个小容器运行在自托管硬件上,维持成本低廉,并且建成后小组随时可以接手编辑,无需为网站付两次钱。
你可能也喜欢
CoverFanz:表演者市场平台的管理后台
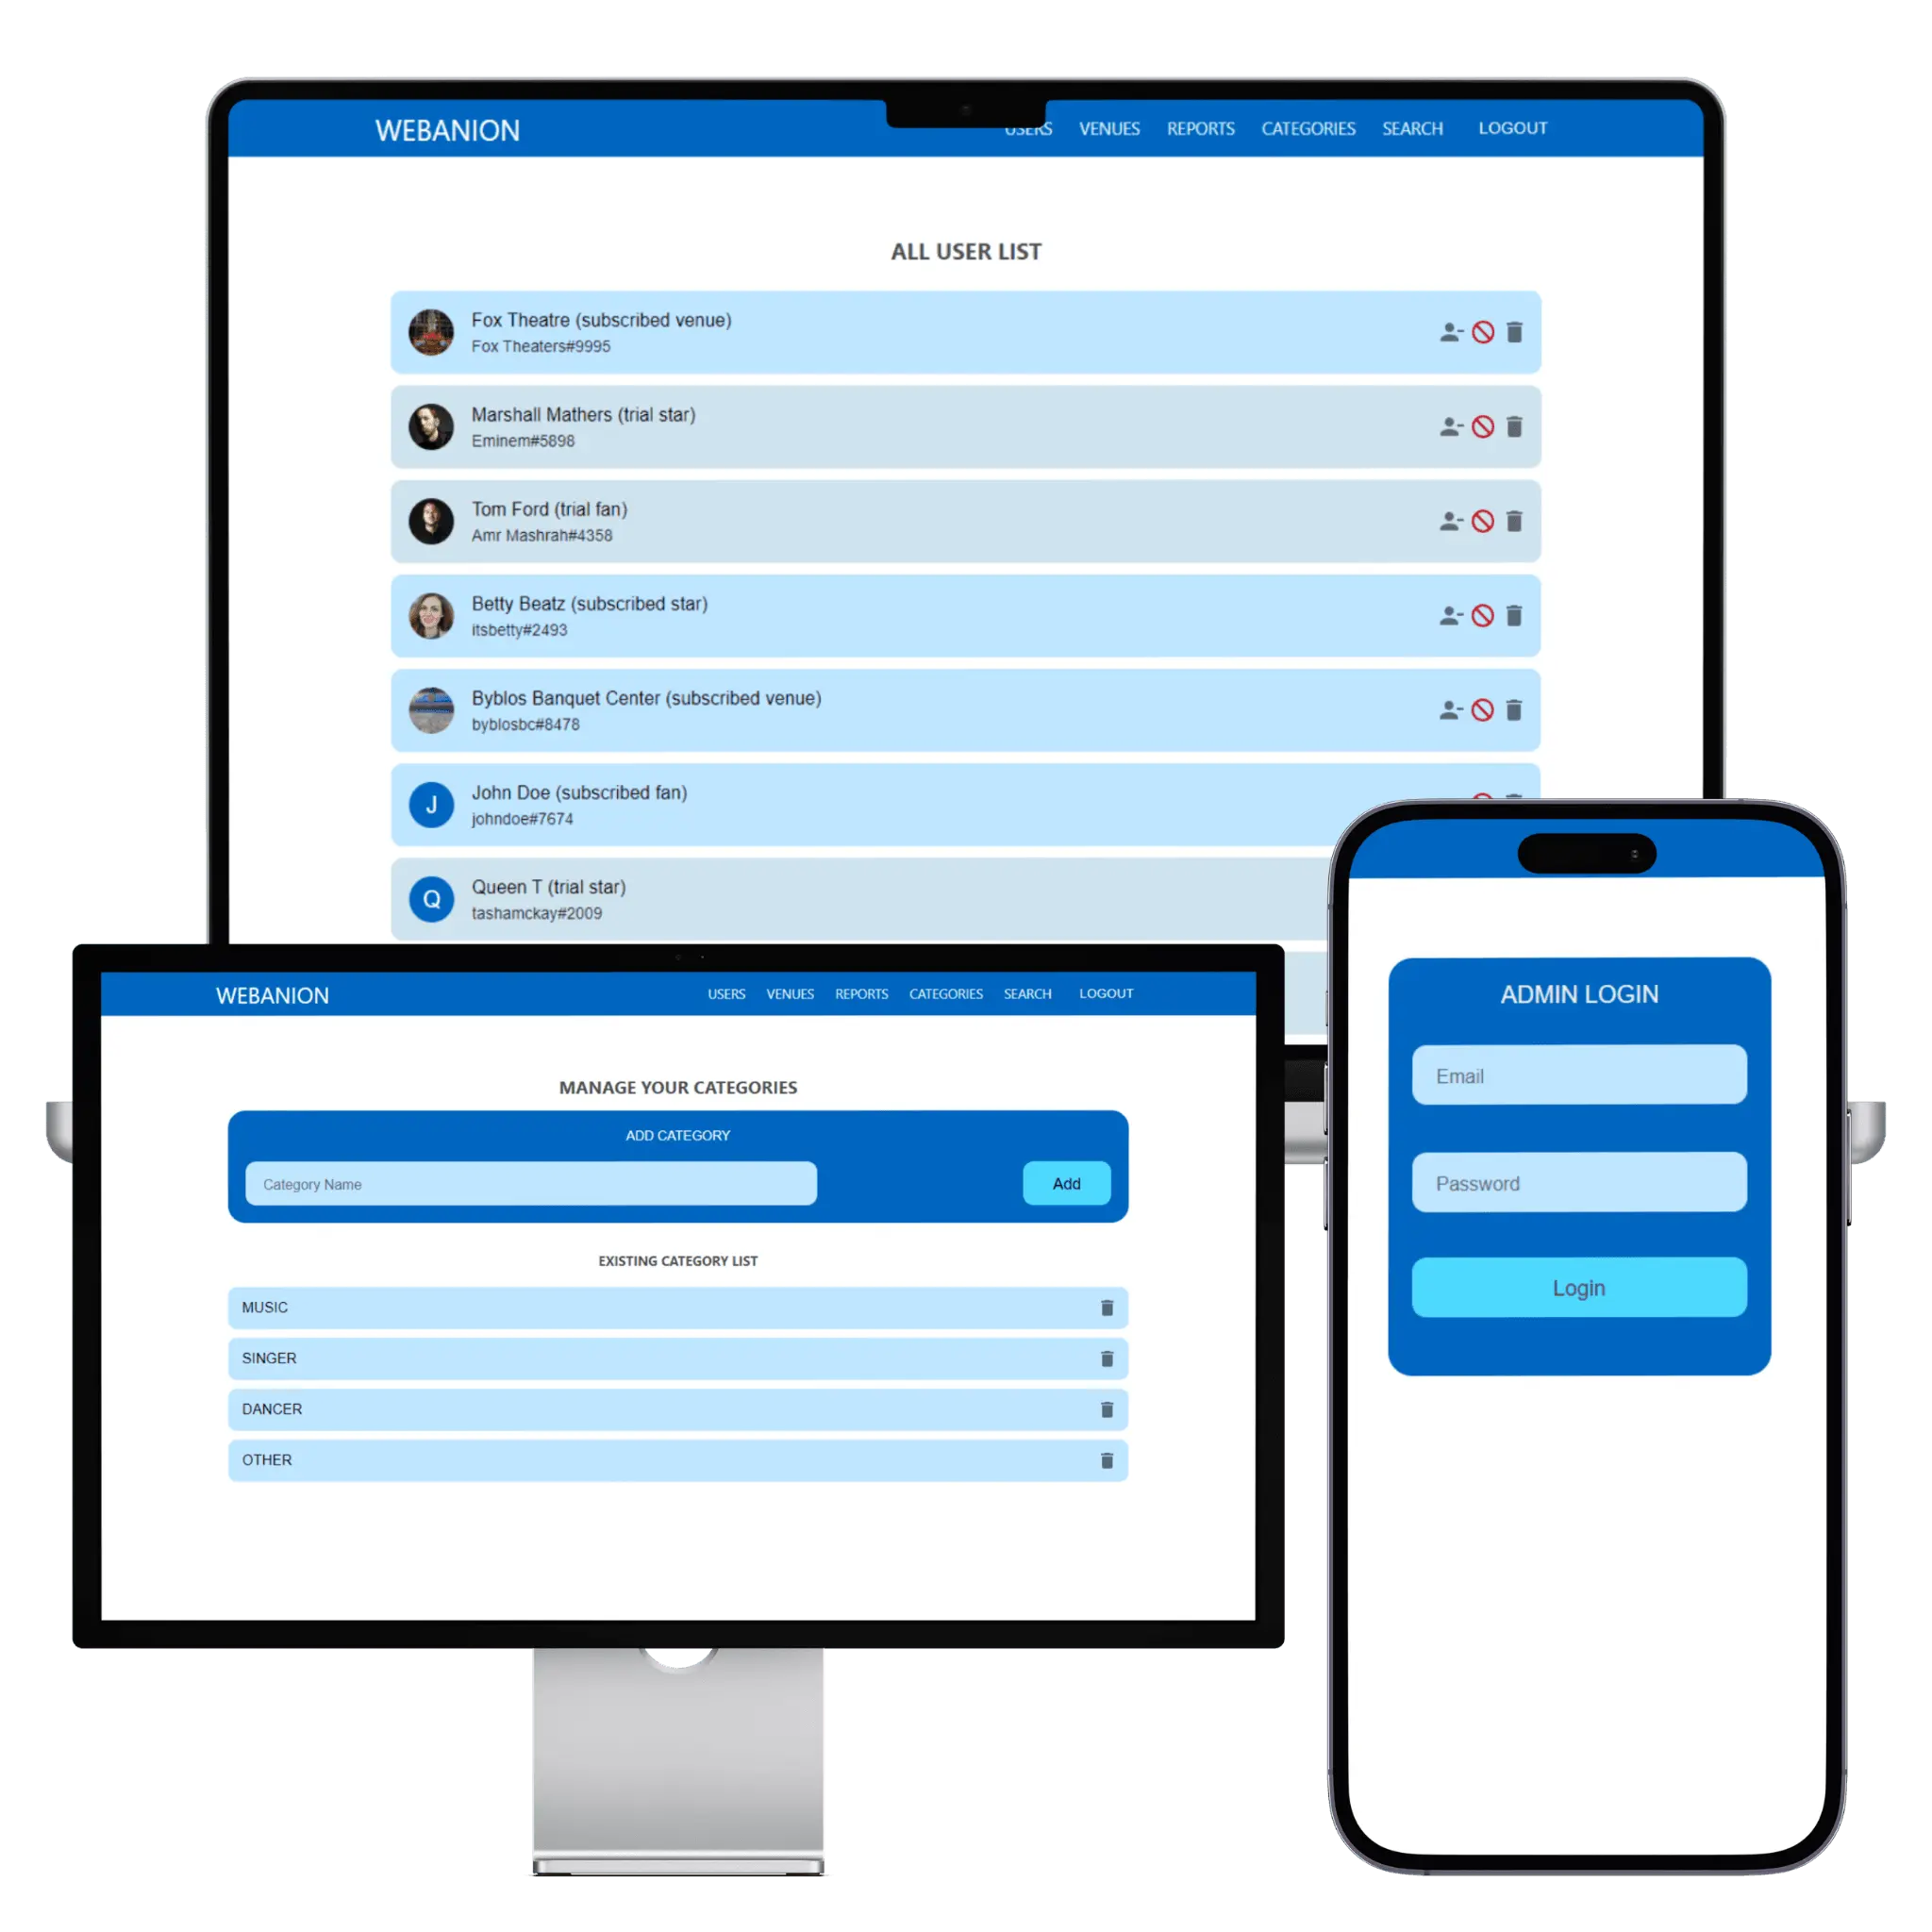
这套管理后台让 CoverFanz 的创始人从上线第一天起,无需求助开发人员就能运营一个表演者市场平台。每一位粉丝、表演者和演出场所都在同一个列表中,附带订阅状态;新场所在地址核实之前一直待在审批队列里;举报会附上原因;表演类型是一份由创始人掌控的列表。它与应用在同一个月内、基于同一套 GraphQL API 构建。

Md Moniruzzaman
4月 29, 2022


Al-Insaf:含总账与贷款的合作社金融平台
一家合作社金融机构此前把社员档案、储蓄、贷款和投资人资本分散在纸质记录与电子表格之间,既无法审计任何一个网点,也无法干净地完成日终结账。我们构建了一套系统把这些全部收拢:社员登记、每日收款、从申请到放款的完整贷款流程、多网点总账、投资人资本,以及一份记录谁做了什么的审计日志。工作人员在每笔收款发生时当场记录,管理者审批贷款并完成日终结账,而权限模型决定每个角色能看到什么、能做什么,而不是简单地把按钮藏起来。本案例研究中展示的一切都运行在预置的演示数据上;真实的社员档案从不出现在作品集材料中。
Md Moniruzzaman

Webanion:带 MCP 服务器的无头 CMS 作品集平台
静态作品集网站既承载不了五种语言的内容,也跟不上背后写作的节奏,于是我们用一个平台取代了它。一套无头 CMS 保存每一份案例研究、文章和记录;一个 Next.js 前端以英语、孟加拉语、西班牙语、印地语和中文呈现它们;一台 MCP 服务器则把同样的内容开放给 AI 助手,让被问及这些工作的智能体去读取源头,而不是根据抓取结果猜测。搜索、媒体管理、审批流程和一个公开的发现层都运行在它之上。证据是递归的:你正在阅读的这个页面,正由本条目所描述的系统提供。
Md Moniruzzaman
博客是来自生产一线的笔记:架构决策、经受住真实用户考验的 AI 系统、能自己挣回成本的基础设施。写于工作之中,而不是隔岸观火。