
La CI alojada era lo más lento y las compilaciones volvieron a casa
Las compilaciones y los despliegues pasaron de los runners alojados de GitHub, donde cada ejecución empezaba en una máquina nueva y las entregas esperaban colas e incidentes, a un pool de runners en casa: una máquina de compilación que toma cada trabajo mientras está encendida y runners de reserva en un servidor siempre encendido, detrás de un watchdog que, ante la duda, se inclina por seguir entregando. Las imágenes van a un registro de contenedores privado y las librerías del estudio a un registro npm privado, ambos dentro del edificio, y cada ejecución se archiva más allá de la retención de GitHub. El despliegue más lento pasó de ocho minutos y veinticuatro segundos a tres minutos y cinco, y la CI fue un tercio más rápida.
Md Moniruzzaman
La historia completa
Lo que le cuesta a una empresa esperar a un pipeline alojado, y lo que cambió cuando las compilaciones, las imágenes y los paquetes pasaron a estar bajo un mismo techo.
El pipeline era la máquina de otro, y el mal día de otro
Hasta mediados de septiembre de 2026, cada compilación y cada despliegue se ejecutaban en los runners alojados de GitHub, y un runner alojado es una máquina virtual nueva cada vez: la imagen base, cada dependencia y cada capa de compilación se descargaban de nuevo por un cambio de una línea y después se tiraban. Luego la imagen se construía en el servidor de producción siempre encendido, porque era el único lugar donde el resultado podía ejecutarse, así que la máquina que servía las bases de datos y los sitios públicos compilaba mientras tanto. El despliegue más lento tardaba ocho minutos y veinticuatro segundos de mediana, casi todo en la compilación, los merges se encolaban unos detrás de otros y una entrega podía fallar porque una descarga de dependencias agotaba su tiempo, un fallo que no tiene nada que ver con el código. Ni siquiera el historial duraba: GitHub conserva los logs de los workflows noventa días por defecto.
El servicio de debajo tuvo su propio año difícil. El 2 de febrero GitHub informó de que sus runners alojados no estaban disponibles y de que los trabajos se quedaron en cola hasta caducar: "Actions jobs queued and timed out while waiting to acquire a hosted runner" (incidente). El 5 de marzo, el noventa y cinco por ciento de las ejecuciones de workflows no arrancó a tiempo: "failed to start within 5 minutes with an average delay of 30 minutes" (incidente). El 9 de julio, durante unas diez horas, los trabajos tardaron en arrancar o no arrancaron: Actions "experienced delayed and failed job starts on GitHub-hosted runners" (incidente). El 26 de agosto los trabajos no arrancaron, "Actions jobs failed to start", y durante las dos horas siguientes las ejecuciones "were delayed starting by more than 5 minutes as the system caught up with delayed load", es decir, arrancaron con más de cinco minutos de retraso (incidente). El 13 de septiembre GitHub informó de una disponibilidad degradada en unos 28 servicios, Actions entre ellos: "degraded availability across approximately 28 services, including Issues, Pull Requests, Actions" (incidente). Contados en su página de estado, más de cincuenta incidentes afectaron a Actions entre enero y septiembre. Los repositorios, las revisiones y las definiciones de los workflows siguen en GitHub; lo que se movió fue la máquina en la que se ejecuta el trabajo, y todo lo que esa máquina había estado descargando y tirando.
Despliegues en tres minutos en lugar de ocho, medidos
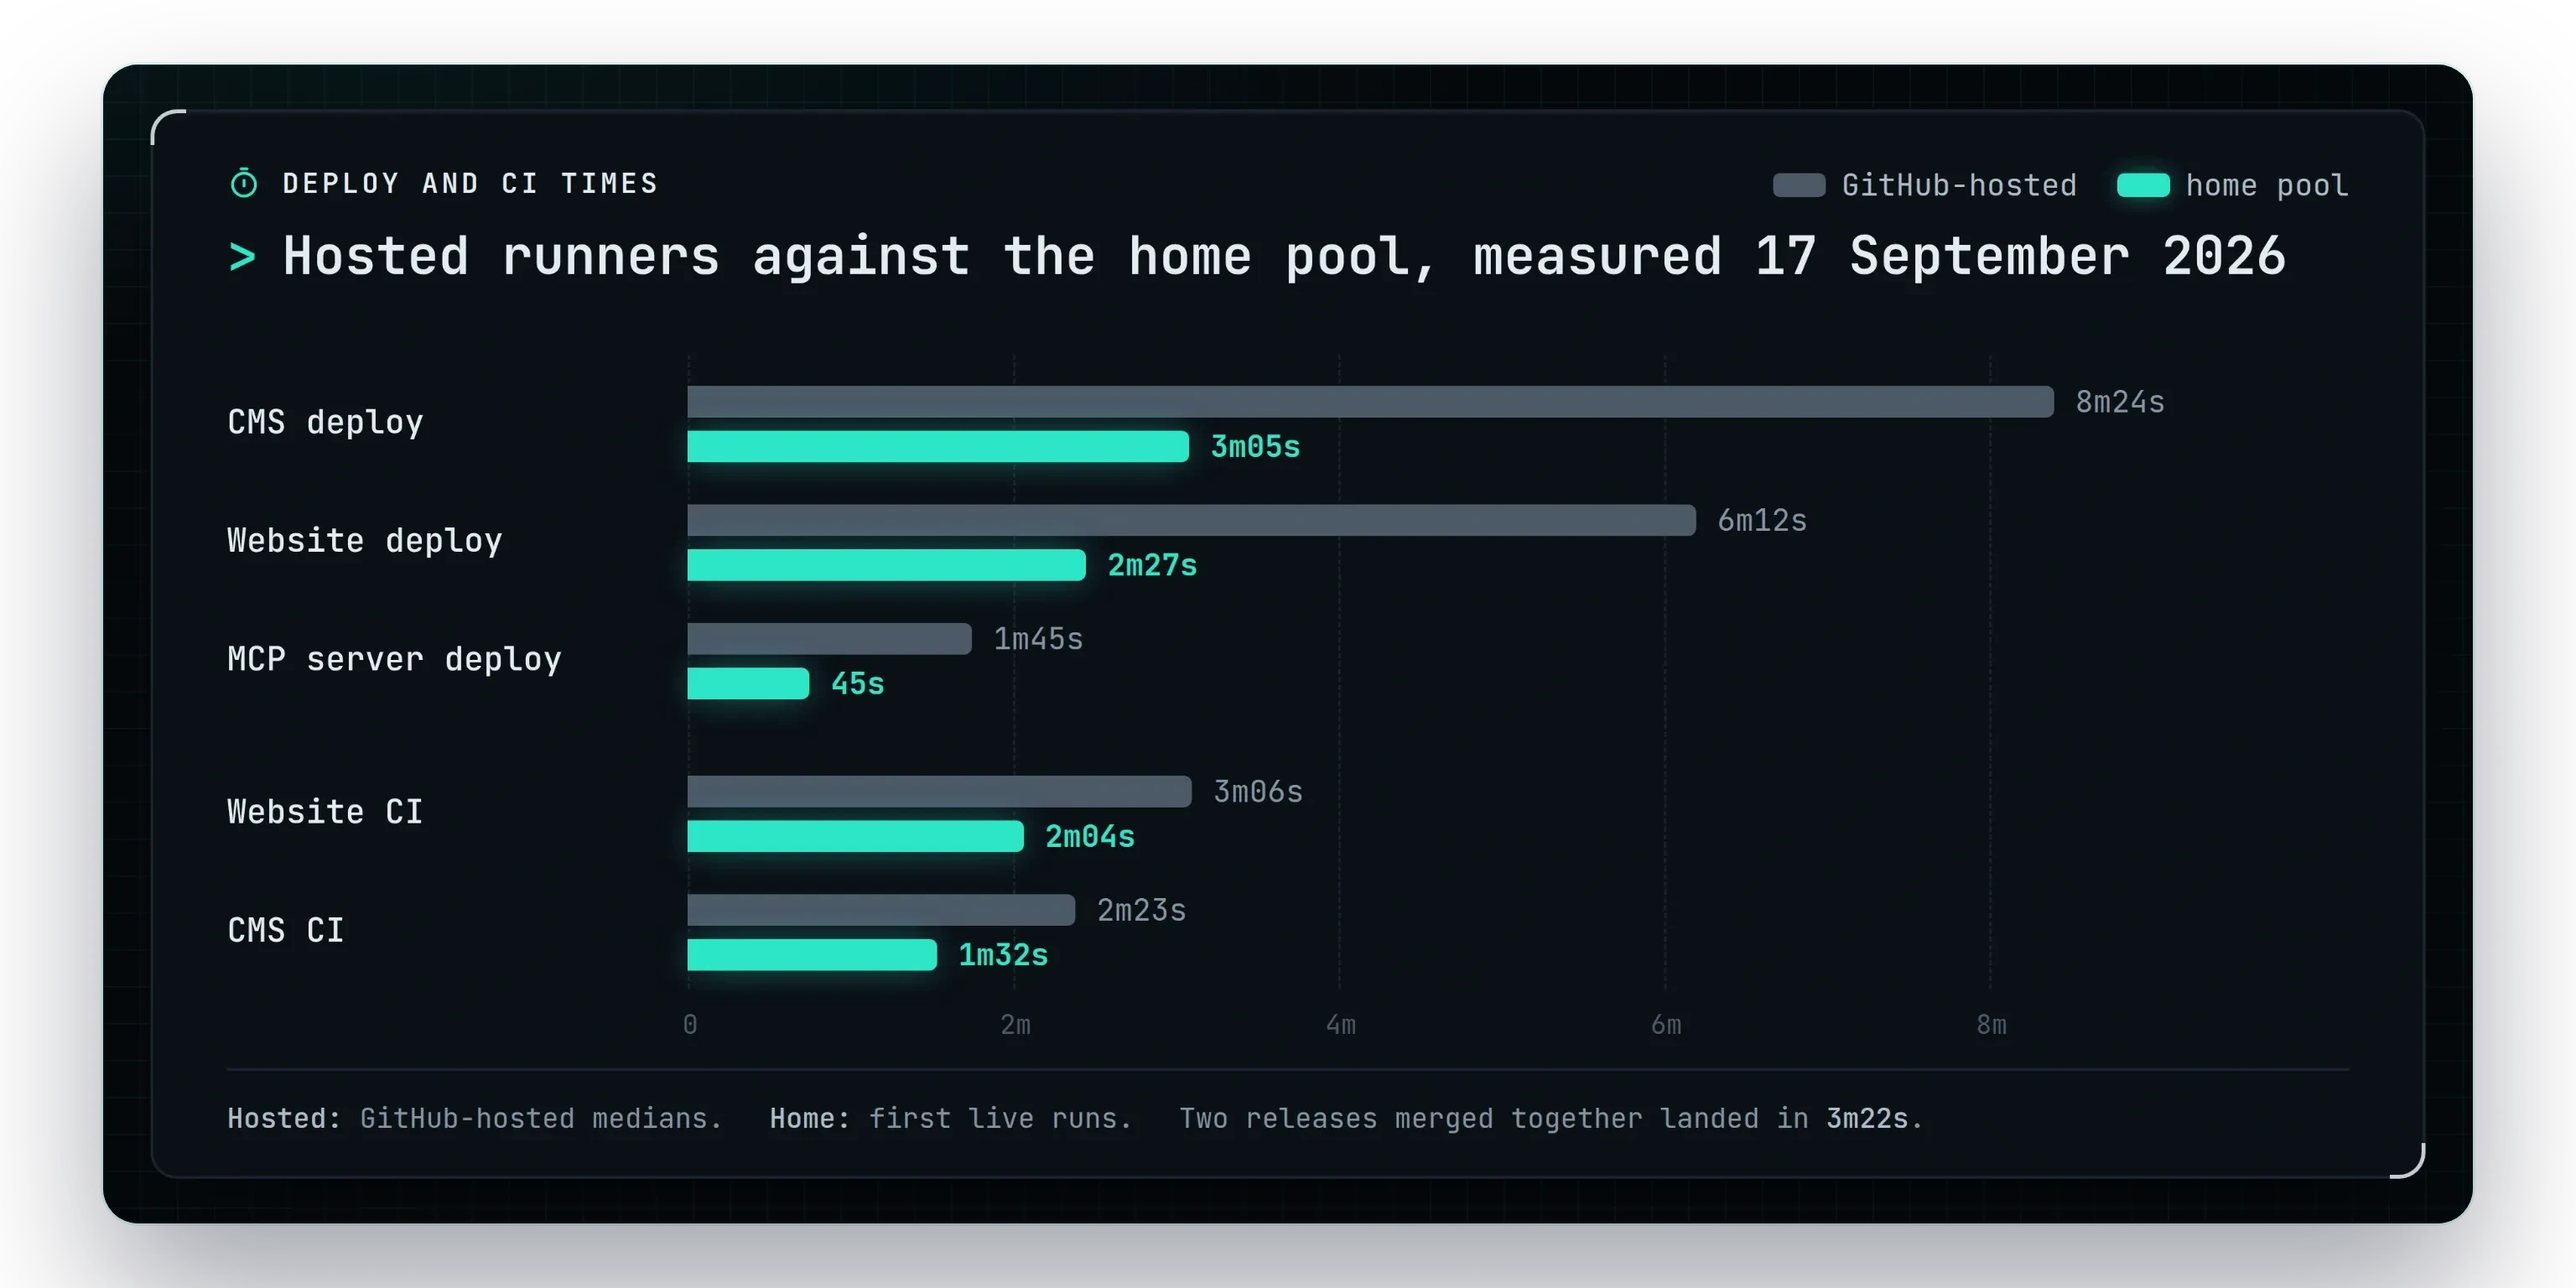
Medido el 17 de septiembre frente a las medianas alojadas: el despliegue del CMS pasó de 8 min 24 s a 3 min 05 s, el del sitio web de 6 min 12 s a 2 min 27 s y el del servidor MCP de 1 min 45 s a 45 s. Dos entregas fusionadas a la vez llegaron en 3 min 22 s de tiempo real, y la CI de los tres servicios ejecutándose a la vez fue un tercio más rápida.
Cada ejecución en la máquina que construyó la anterior
Un runner alojado es una máquina nueva cada vez. El pool de casa son las mismas máquinas en cada trabajo, así que sus capas de imagen y sus cachés de paquetes ya están ahí, la imagen nunca cruza internet camino del clúster y la compilación se ejecuta en una máquina pensada para compilar en lugar de en la que sirve los sitios. La misma compilación midió 528 segundos con la caché fría y 192 con la caché caliente. Las primeras ejecuciones en casa fueron tres veces más lentas hasta que se quitó un paso: cada compilación subía su caché de dependencias de vuelta a GitHub por una conexión doméstica, 411 segundos en el caso del sitio web, algo que tiene sentido cuando el runner es la máquina de otro y ninguno cuando la caché ya vive donde se ejecutará la siguiente compilación.
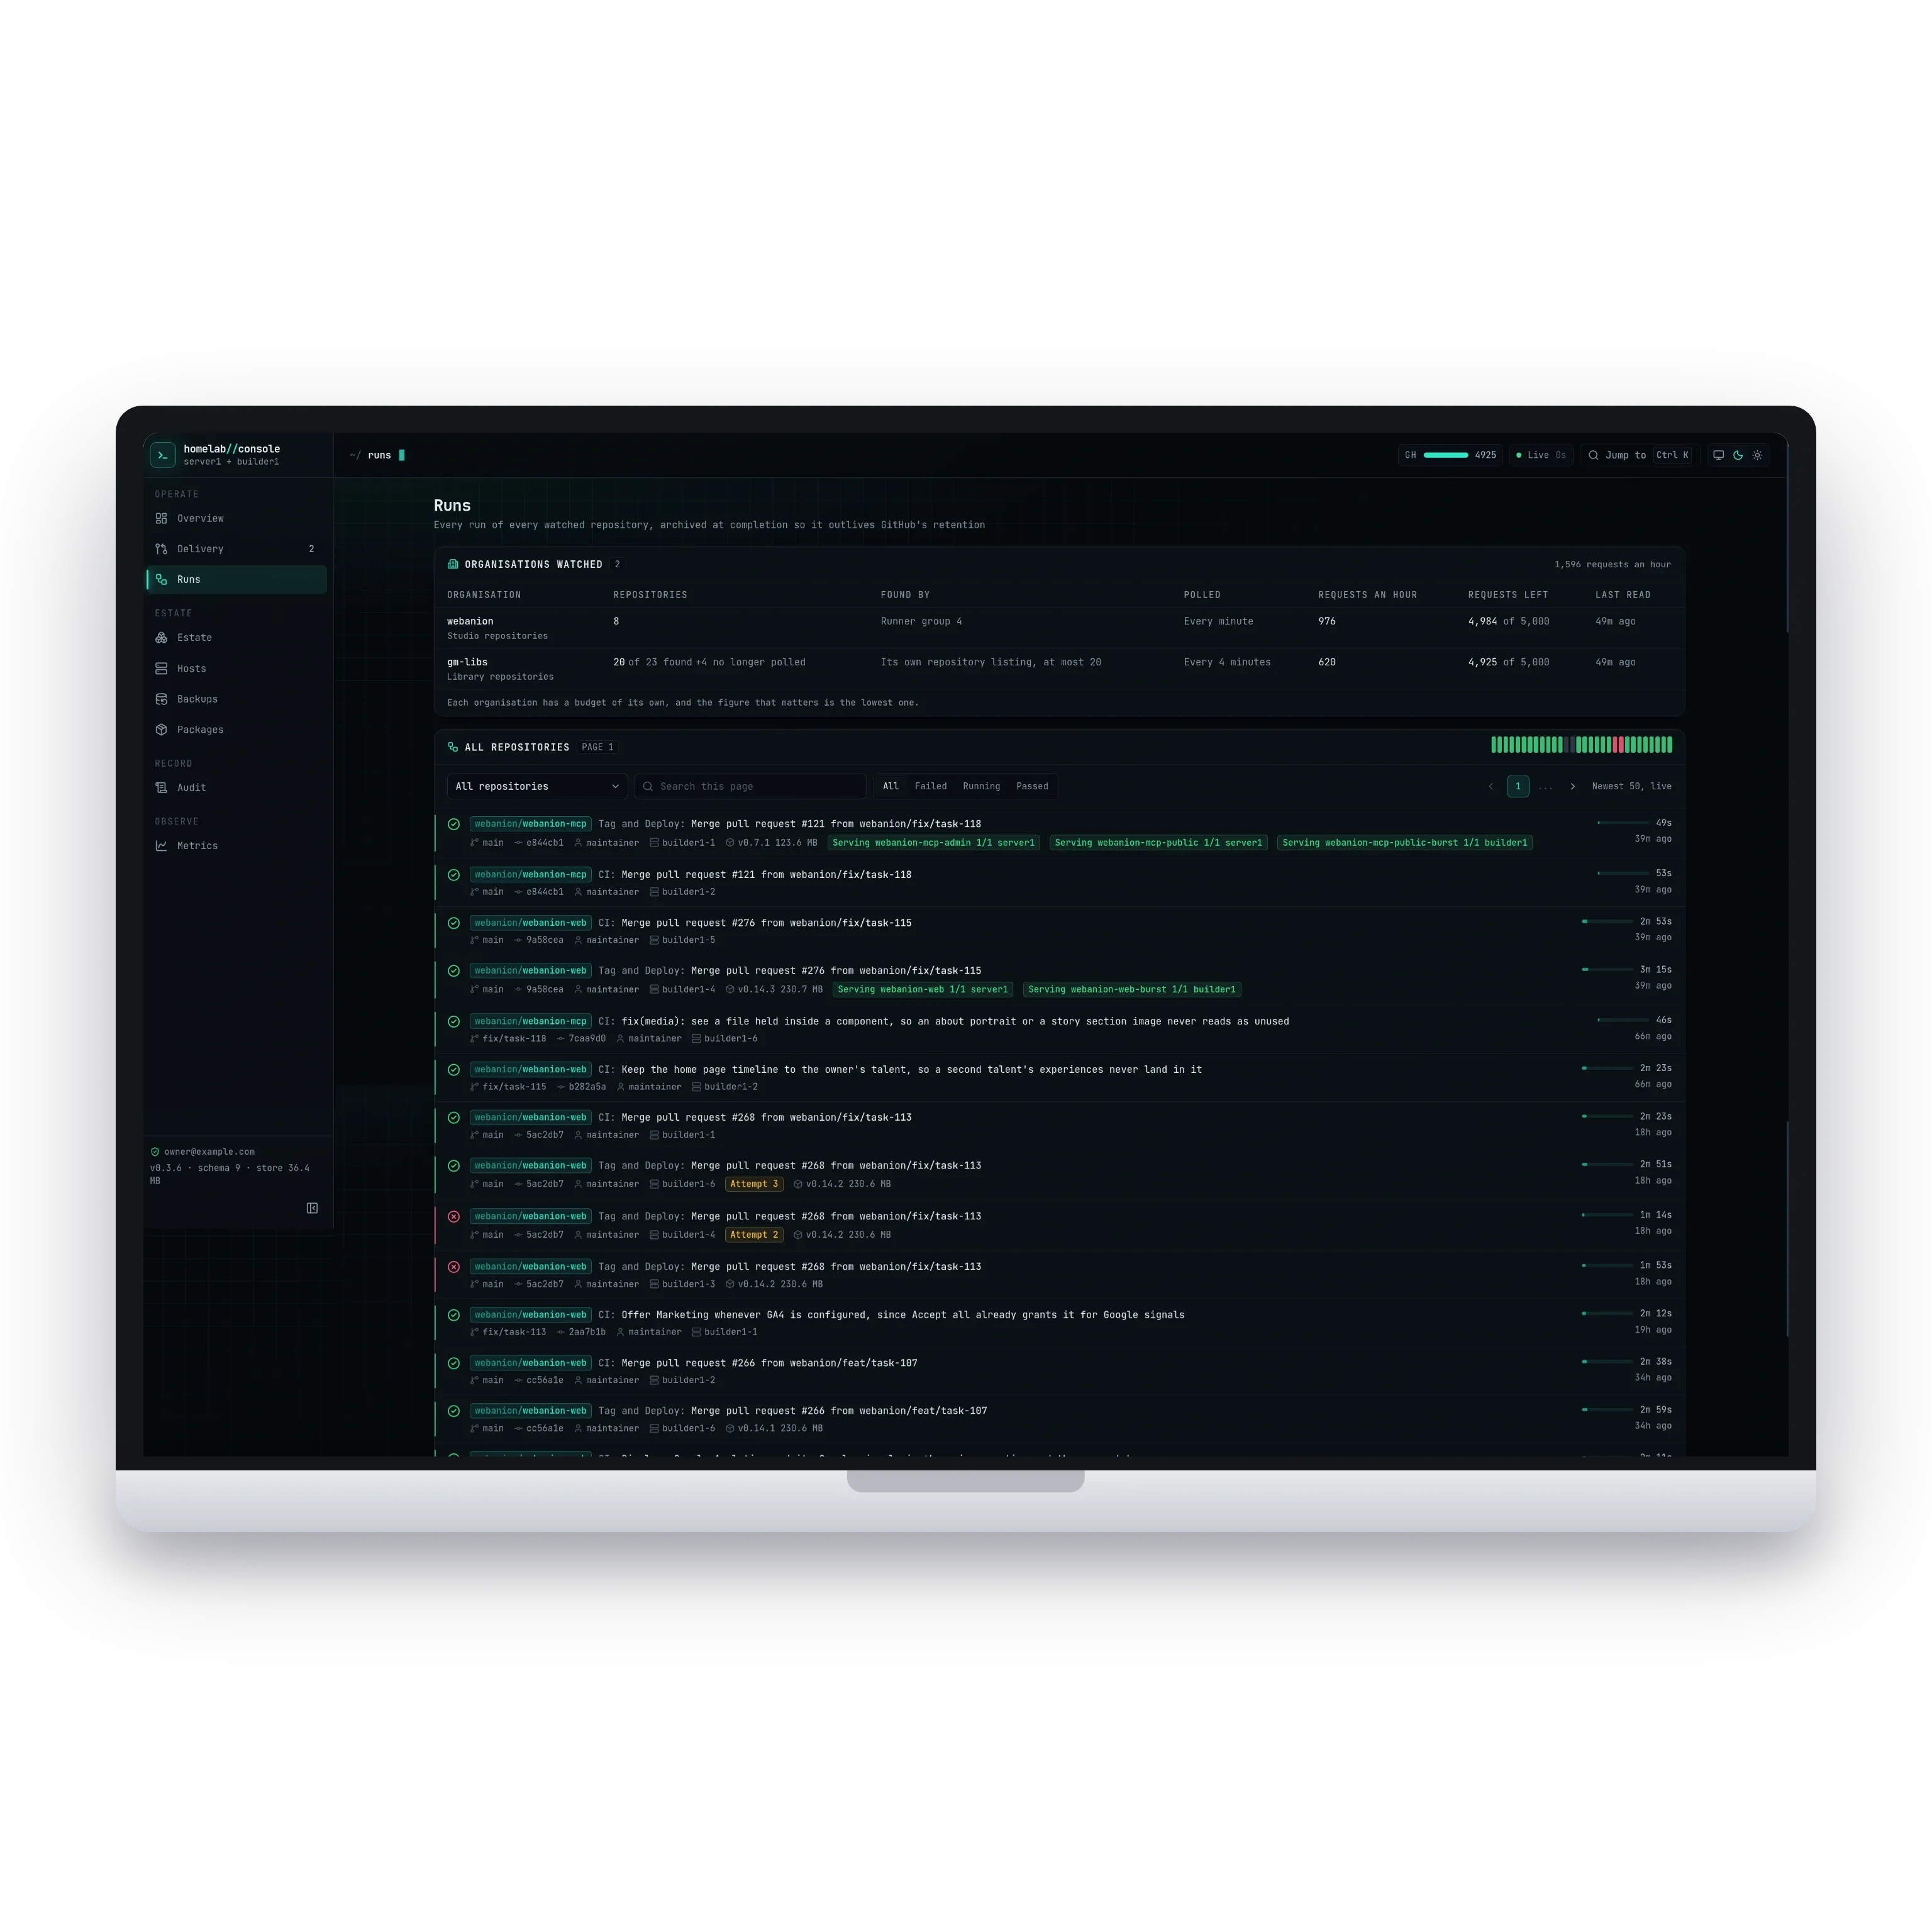
La vista Runs lista cada ejecución de cada repositorio vigilado y archiva cada una al terminar, así que sobrevive a la retención de GitHub. El día de la captura mostraba despliegues de 49 segundos, 3 min 15 s y 2 min 51 s y ejecuciones de CI de dos a tres minutos, y mantenía los fallos a la vista: dos intentos fallidos de un despliegue y después el tercero, que pasó.
Un despliegue, paso a paso, sobre su propio eje de tiempo
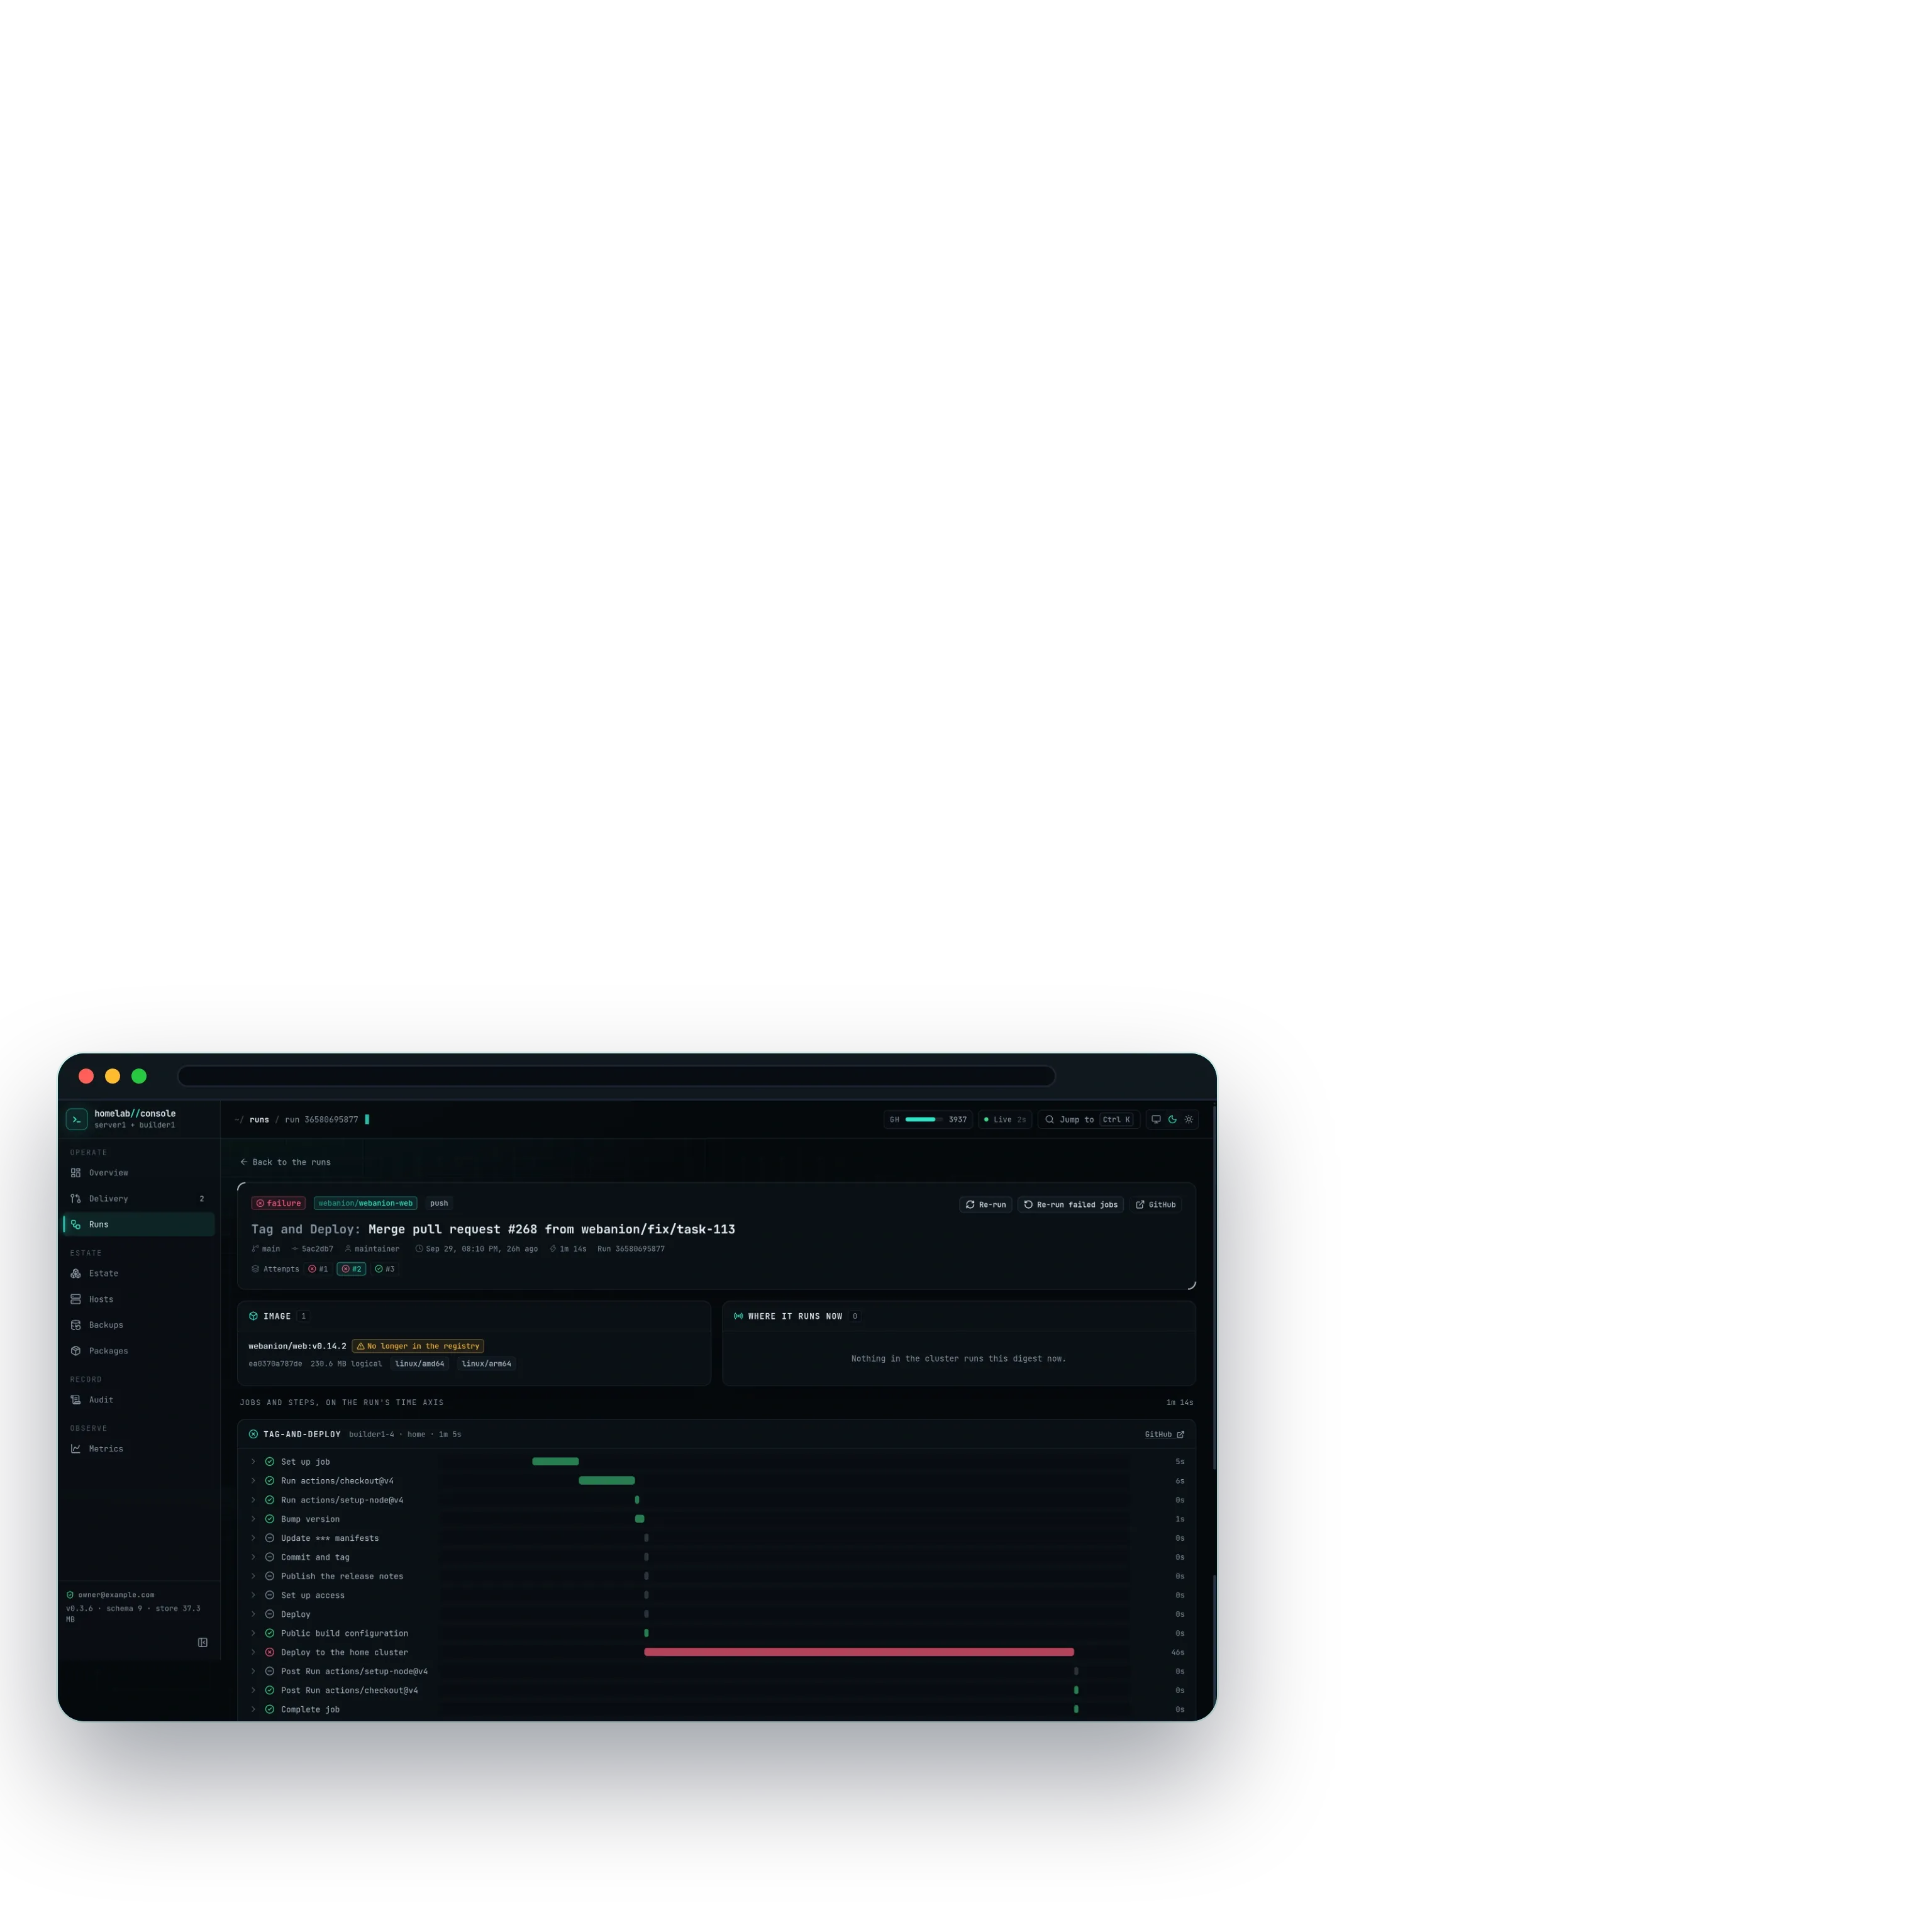
Al abrir una ejecución se ve cada trabajo y cada paso sobre el eje de tiempo de la propia ejecución, medido con las marcas de tiempo de GitHub, junto a la imagen que subió la ejecución con su digest, su tamaño y sus plataformas, y dónde se ejecuta ahora esa imagen. Los reintentos se conservan en lugar de sobrescribirse: el despliegue de las capturas falló en sus dos primeros intentos y pasó en el tercero, cada intento se abre por separado y el segundo muestra el paso de despliegue fallando a los cuarenta y seis segundos, así que el motivo de un fallo sigue ahí después del arreglo.
El intento que pasó muestra adónde va el tiempo en el pool de casa: segundos para el checkout y el cambio de versión, y algo menos de dos minutos y medio para la compilación y el despliegue en el clúster. También muestra lo que una consola puede decir y un log de CI no: que esa imagen ya no está en el registro, porque la retención solo guarda las compilaciones recientes, y que nada en el clúster ejecuta ya ese digest.

Cuando la máquina de compilación se va, el trabajo sigue
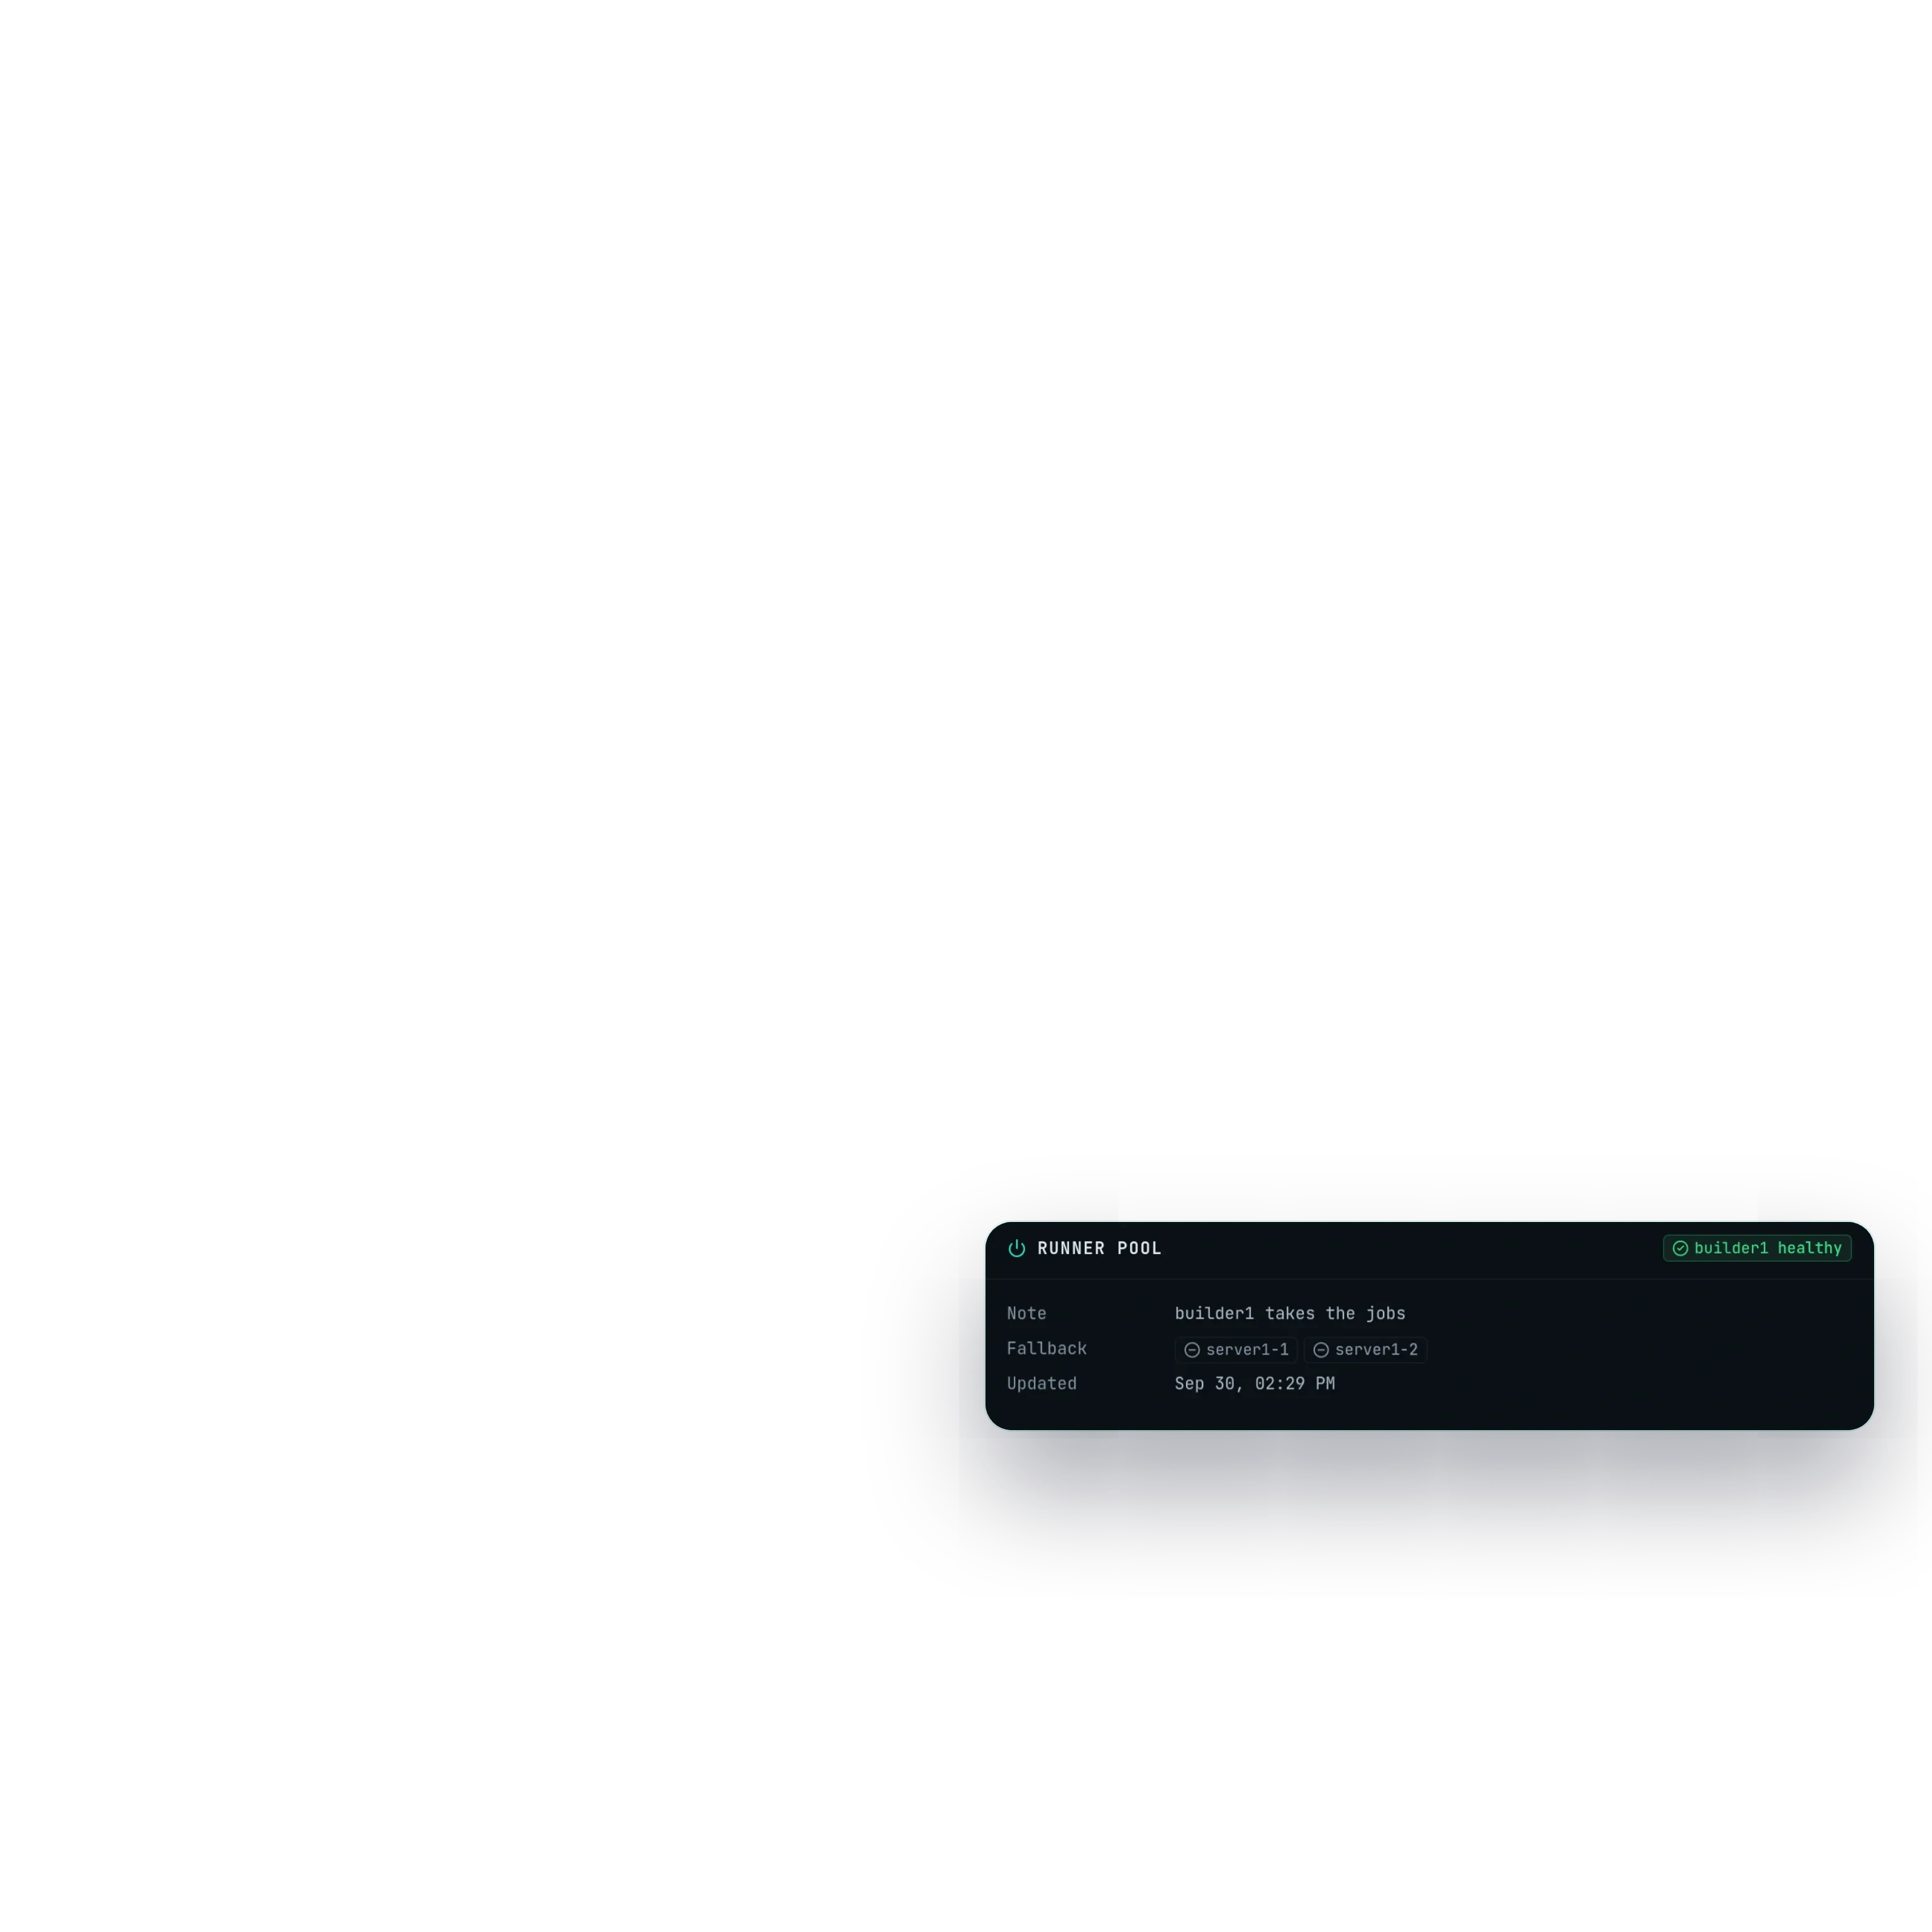
El pool de runners tiene una parte principal y una de reserva. Los runners de la máquina de compilación toman cada trabajo mientras está encendida, y el servidor siempre encendido mantiene runners de reserva que solo arrancan cuando un watchdog decide que la máquina de compilación ya no está. El watchdog necesita más de una comprobación fallida antes de darla por caída y más de una correcta antes de darla por recuperada, así que un corte breve de red nunca hace oscilar nada, y el relevo ocurre en un par de minutos en cualquiera de los dos sentidos. Nunca corta un trabajo a la mitad: un apagado espera al trabajo en curso, y la reserva se retira solo cuando está libre.
Si el watchdog no puede llegar a GitHub en absoluto, arranca la reserva de todos modos, porque un fallo de monitorización que detiene los despliegues es peor que la caída que vigilaba. El panel del pool de runners en la vista general de la consola indica qué lado toma los trabajos y qué runners de reserva están listos.

Imágenes y paquetes, servidos bajo un mismo techo
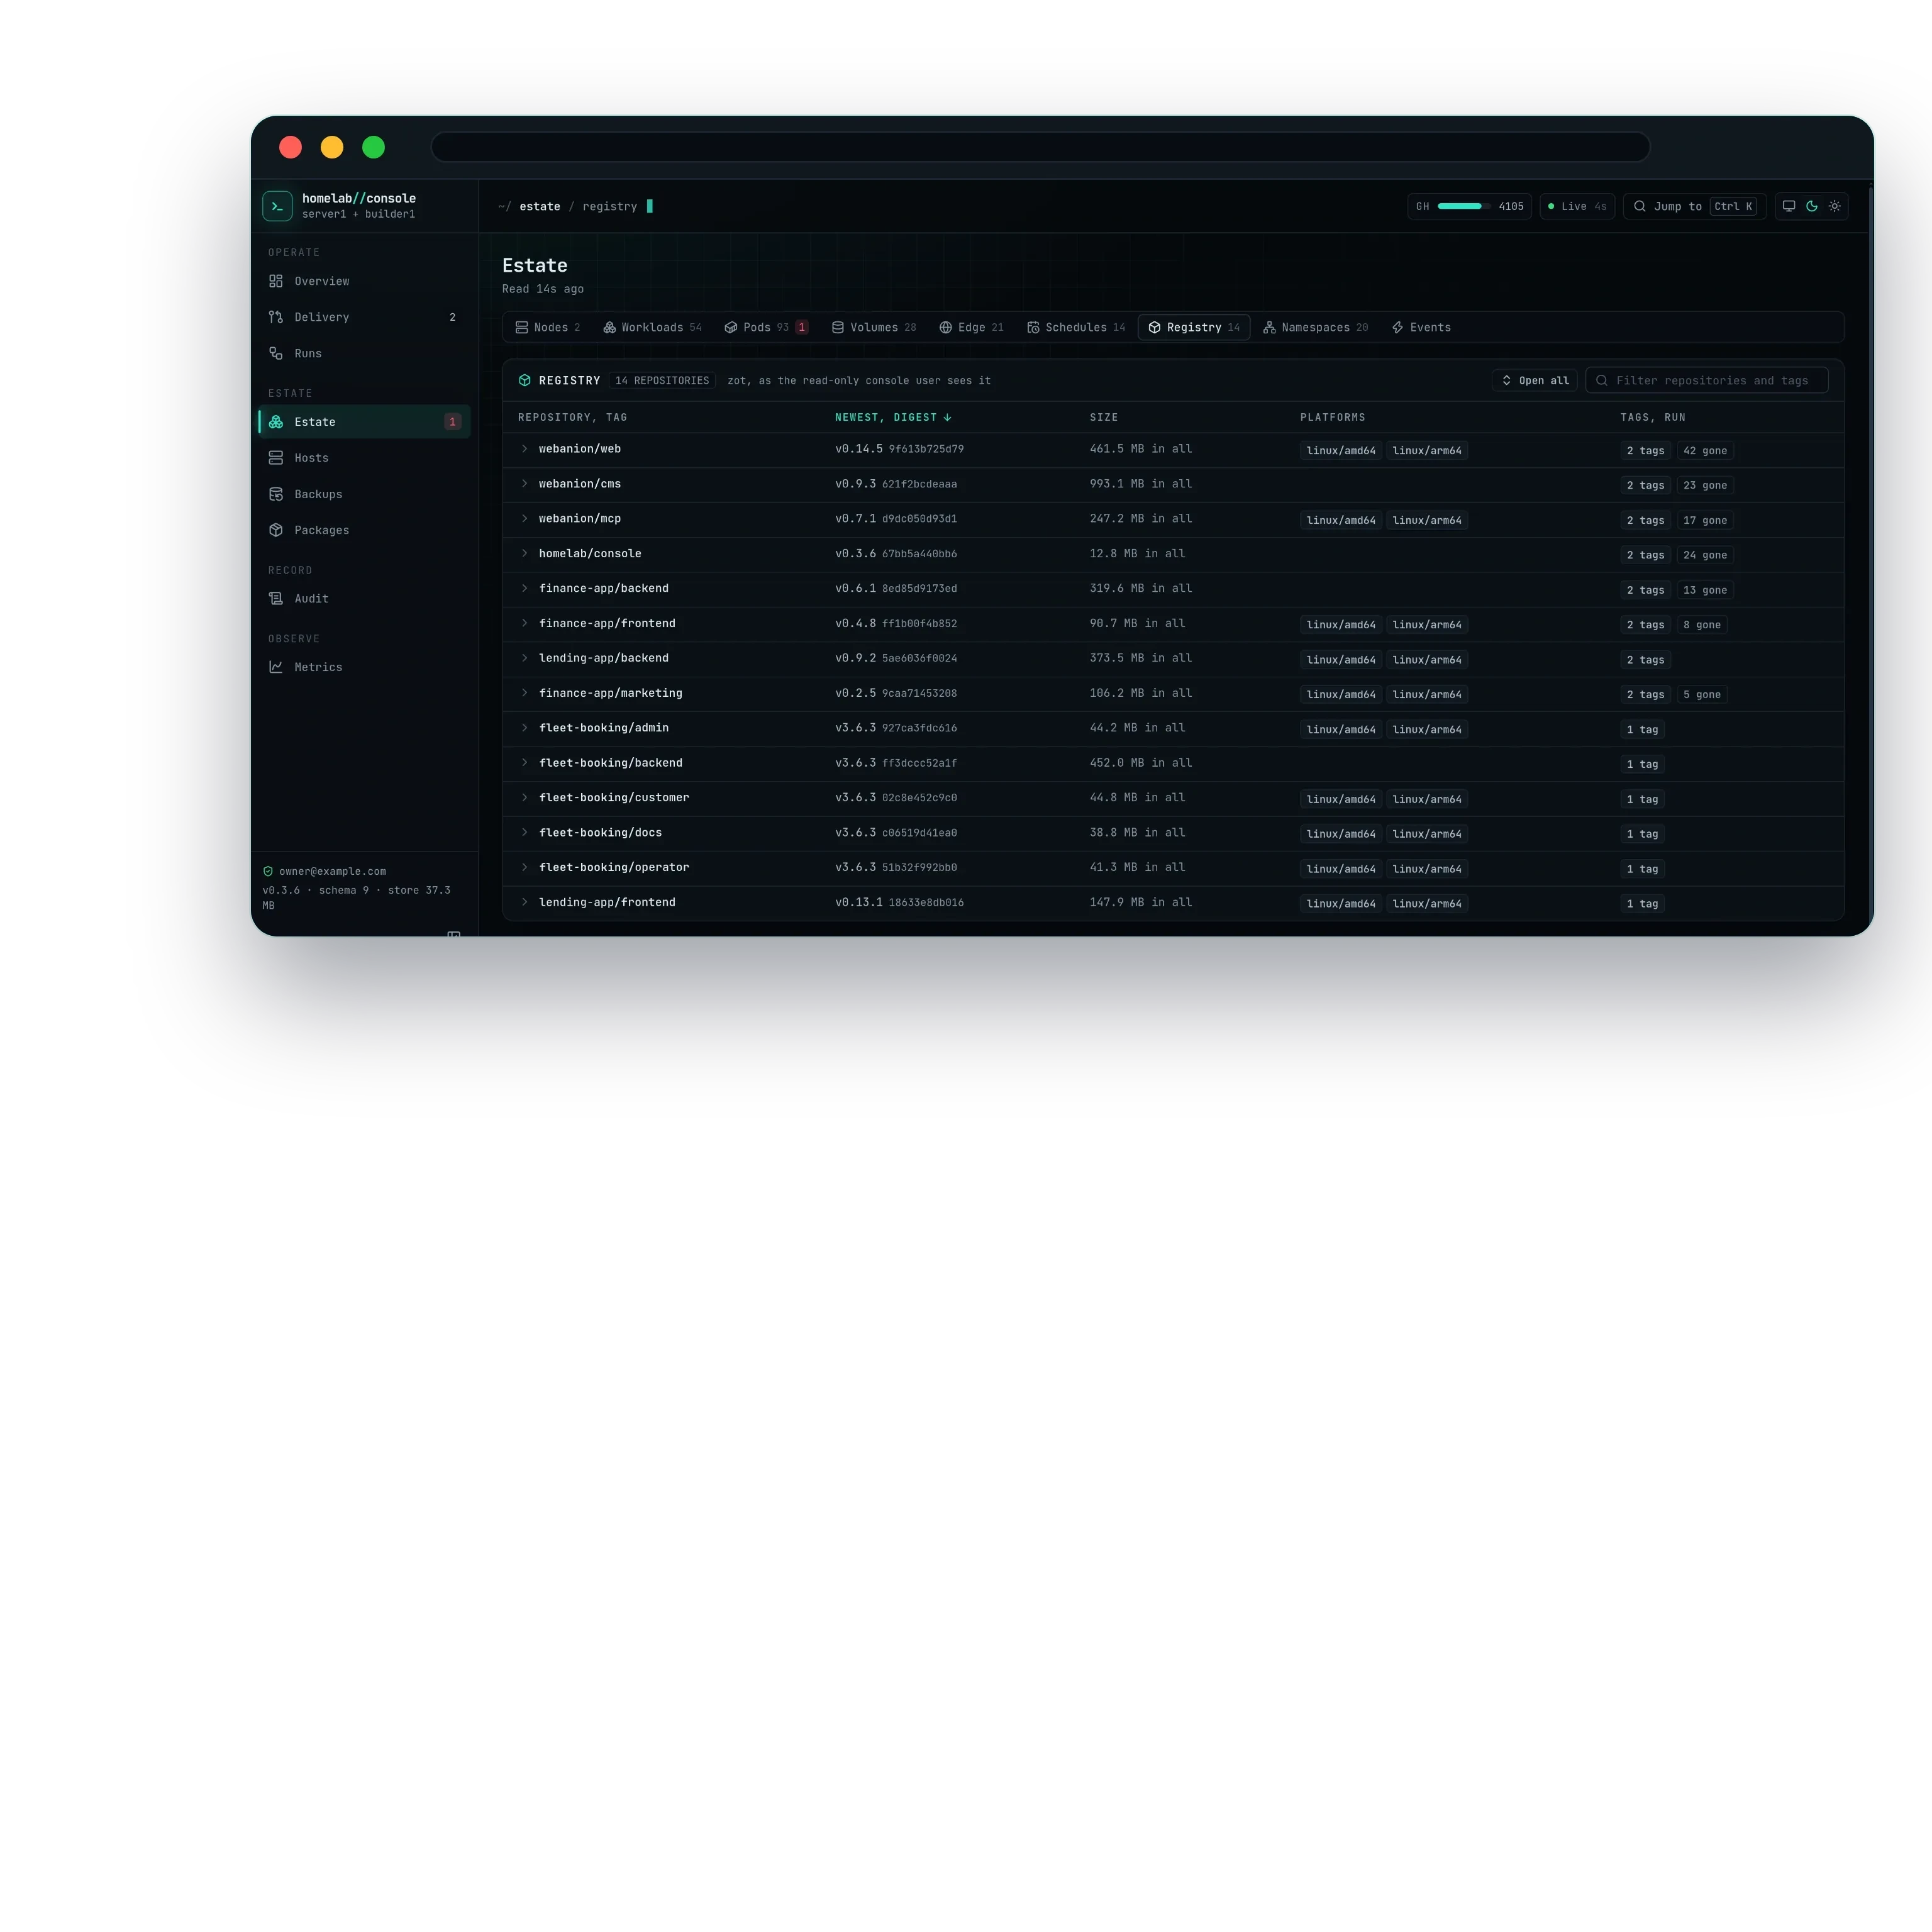
Un registro de contenedores y un registro npm funcionan uno junto al otro en el servidor siempre encendido, porque las imágenes de contenedor y los paquetes npm hablan protocolos que no comparten nada. El registro de contenedores recibe por la red local cada imagen que construye el pool, con una sola cuenta que puede subir, cuentas de solo lectura para todo lo que descarga y ningún acceso anónimo, y una misma etiqueta puede llevar las dos arquitecturas de procesador para que cada nodo descargue la compilación que le corresponde. La retención guarda las dos compilaciones más recientes de cada servicio más la última descargada, que es la ventana para volver atrás, declarada en lugar de supuesta.
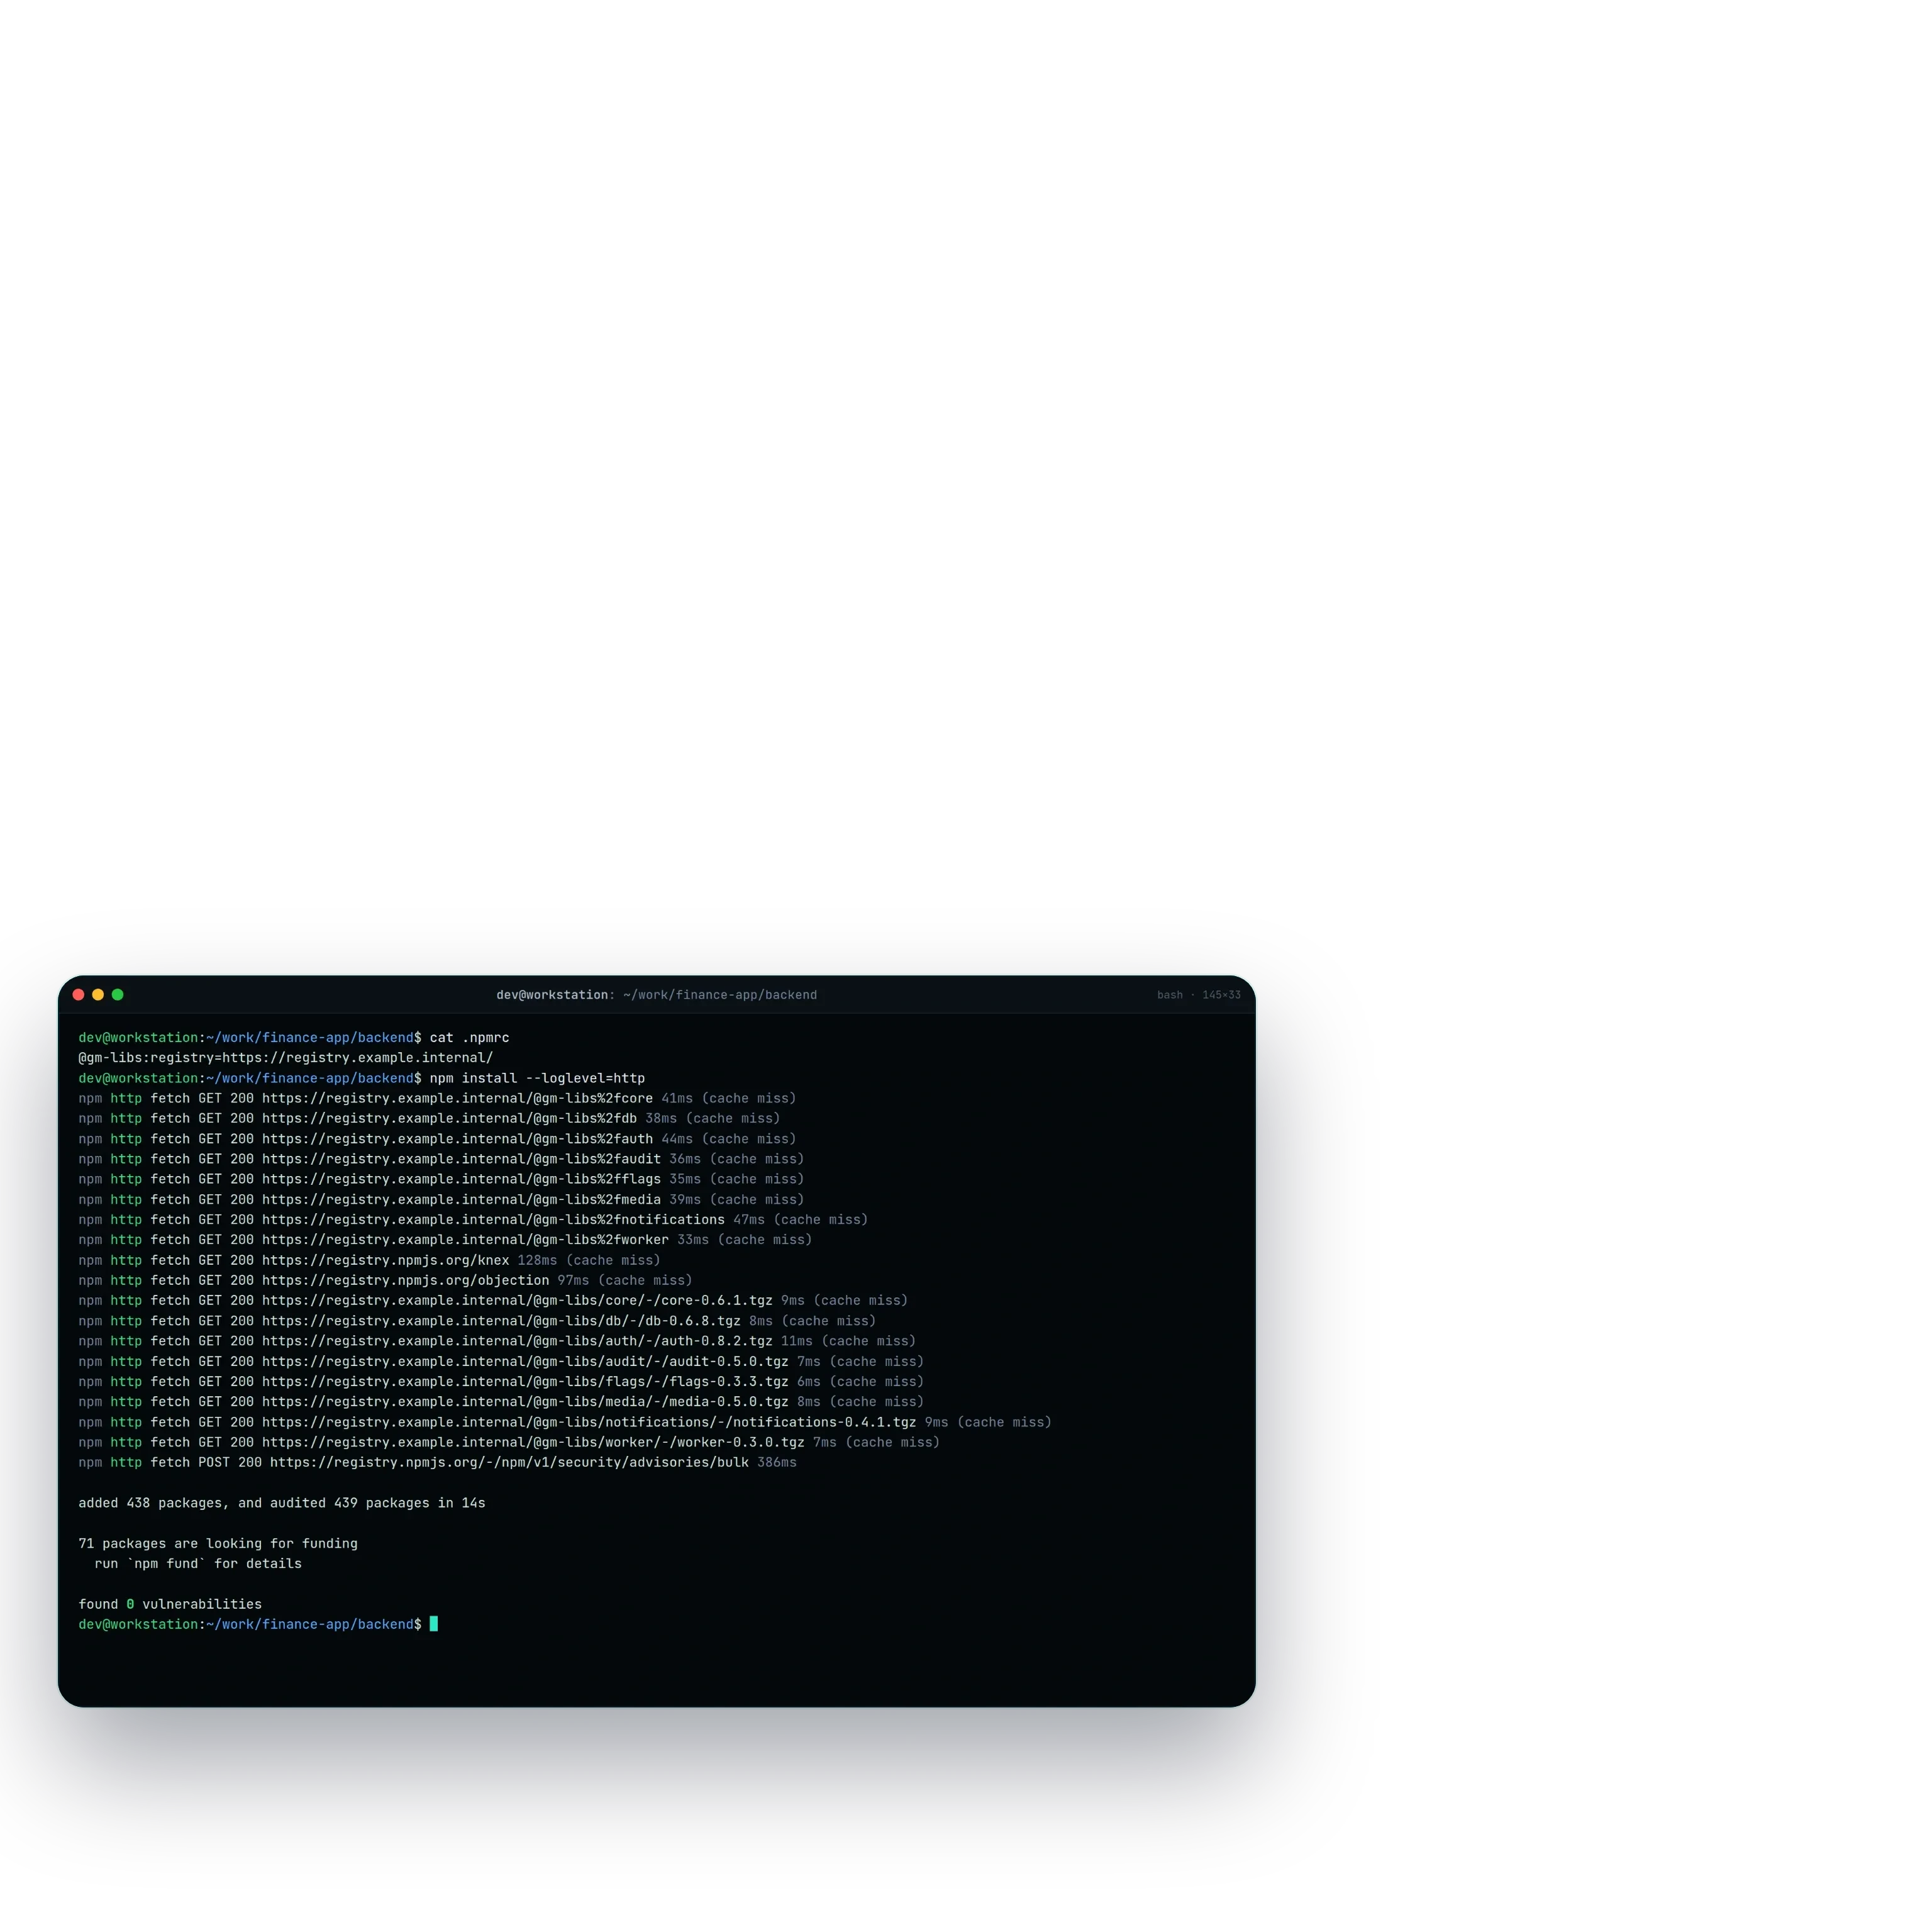
El registro npm sirve la familia de librerías propia del estudio. Cada versión de una librería se publica en él byte a byte desde su GitHub Release mediante una sincronización dentro del clúster cada cinco minutos, cada lectura exige iniciar sesión, el nombre público rechaza escrituras y un trabajo nocturno compara cada versión publicada con su release. Los registros no tienen interfaz propia, así que la consola es su pantalla: la vista Estate lista los repositorios del registro de contenedores con sus tamaños y plataformas, y una instalación en cualquier proyecto que consume las librerías se resuelve sin salir del edificio.
De un merge a un pod en marcha, y una línea para volver
Un merge encola la compilación en el pool, la imagen va al registro por la red local y el despliegue se ejecuta con una identidad limitada a un namespace, sin permiso para borrar y con un único secreto con nombre. Cada nodo descarga la compilación que le corresponde, y una variable por repositorio devuelve un servicio a los runners alojados en su siguiente push.


Lo que cambió en la semana de trabajo, y para quién tiene sentido
Los merges ya no se esperan unos a otros: con la máquina de compilación encendida, las entregas se compilan y despliegan en paralelo, y en la reserva un candado toma los pasos pesados de uno en uno para que nada choque. Un arreglo sale en unos tres minutos en lugar de ocho, el servidor siempre encendido solo compila cuando la máquina de compilación no está, y el historial de cada ejecución se queda en el edificio cuando GitHub ya lo ha borrado. Los repositorios, las revisiones y las definiciones de los workflows siguieron en GitHub; solo se movieron las máquinas, las cachés, las imágenes y los paquetes.
El límite se dice desde el principio: un corte de luz en mitad de una compilación hace fallar esa compilación, y se vuelve a ejecutar. Es la decisión correcta para un equipo cuyas entregas han empezado a hacer cola, para quien no quiere que su código y sus imágenes salgan del edificio, y para un fundador que ha visto un arreglo esperar en la cola de otro. Es la decisión equivocada para un equipo sin nadie que se haga cargo de las máquinas, y conviene decirlo claro. El clúster de debajo es la historia de un nodo que pasó a ser un clúster, la plataforma que lo rodea es el homelab que sostiene el estudio, y el mismo enfoque aplicado a la plataforma de un cliente es la migración sin tiempo de inactividad a Kubernetes autoalojado.
También te puede gustar
27 Pearls - Lanzamiento móvil y envío a tiendas
Una app de 27 Pearls terminada se convirtió en fichas aprobadas en App Store y Google Play dentro de un encargo de una semana, sin rondas de rechazos. La semana incluyó las compilaciones de publicación y la firma, textos de ficha escritos en torno al beneficio para el estudiante, capturas para cada tamaño de dispositivo exigido, declaraciones de privacidad acordes con lo que la app recoge y una cuenta de revisión que funcionaba. La app sigue hoy en Google Play.

Md Moniruzzaman
may 05, 2023

Fully Booked - Migración sin Tiempo de Inactividad a Kubernetes Autoalojado
Fully Booked funcionaba sobre infraestructura gestionada en la nube, con una factura que crecía cada mes y una pila que nadie controlaba del todo. Trasladamos toda la plataforma a un clúster de Kubernetes autoalojado sin un minuto de interrupción para quienes la usaban. El cambio abarcó DNS, ingress, bases de datos y el pipeline de despliegue, escalonado de modo que el tráfico se movía solo una vez probada cada capa en el clúster nuevo. Nadie que usara la aplicación esa semana notó nada, que era exactamente el objetivo. La factura recurrente pasó a ser hardware propio, y ese mismo clúster sostiene hoy las publicaciones semanales de la plataforma.

Md Moniruzzaman
jun 23, 2026

Un nodo pasó a ser un clúster sin cambiar ninguna aplicación
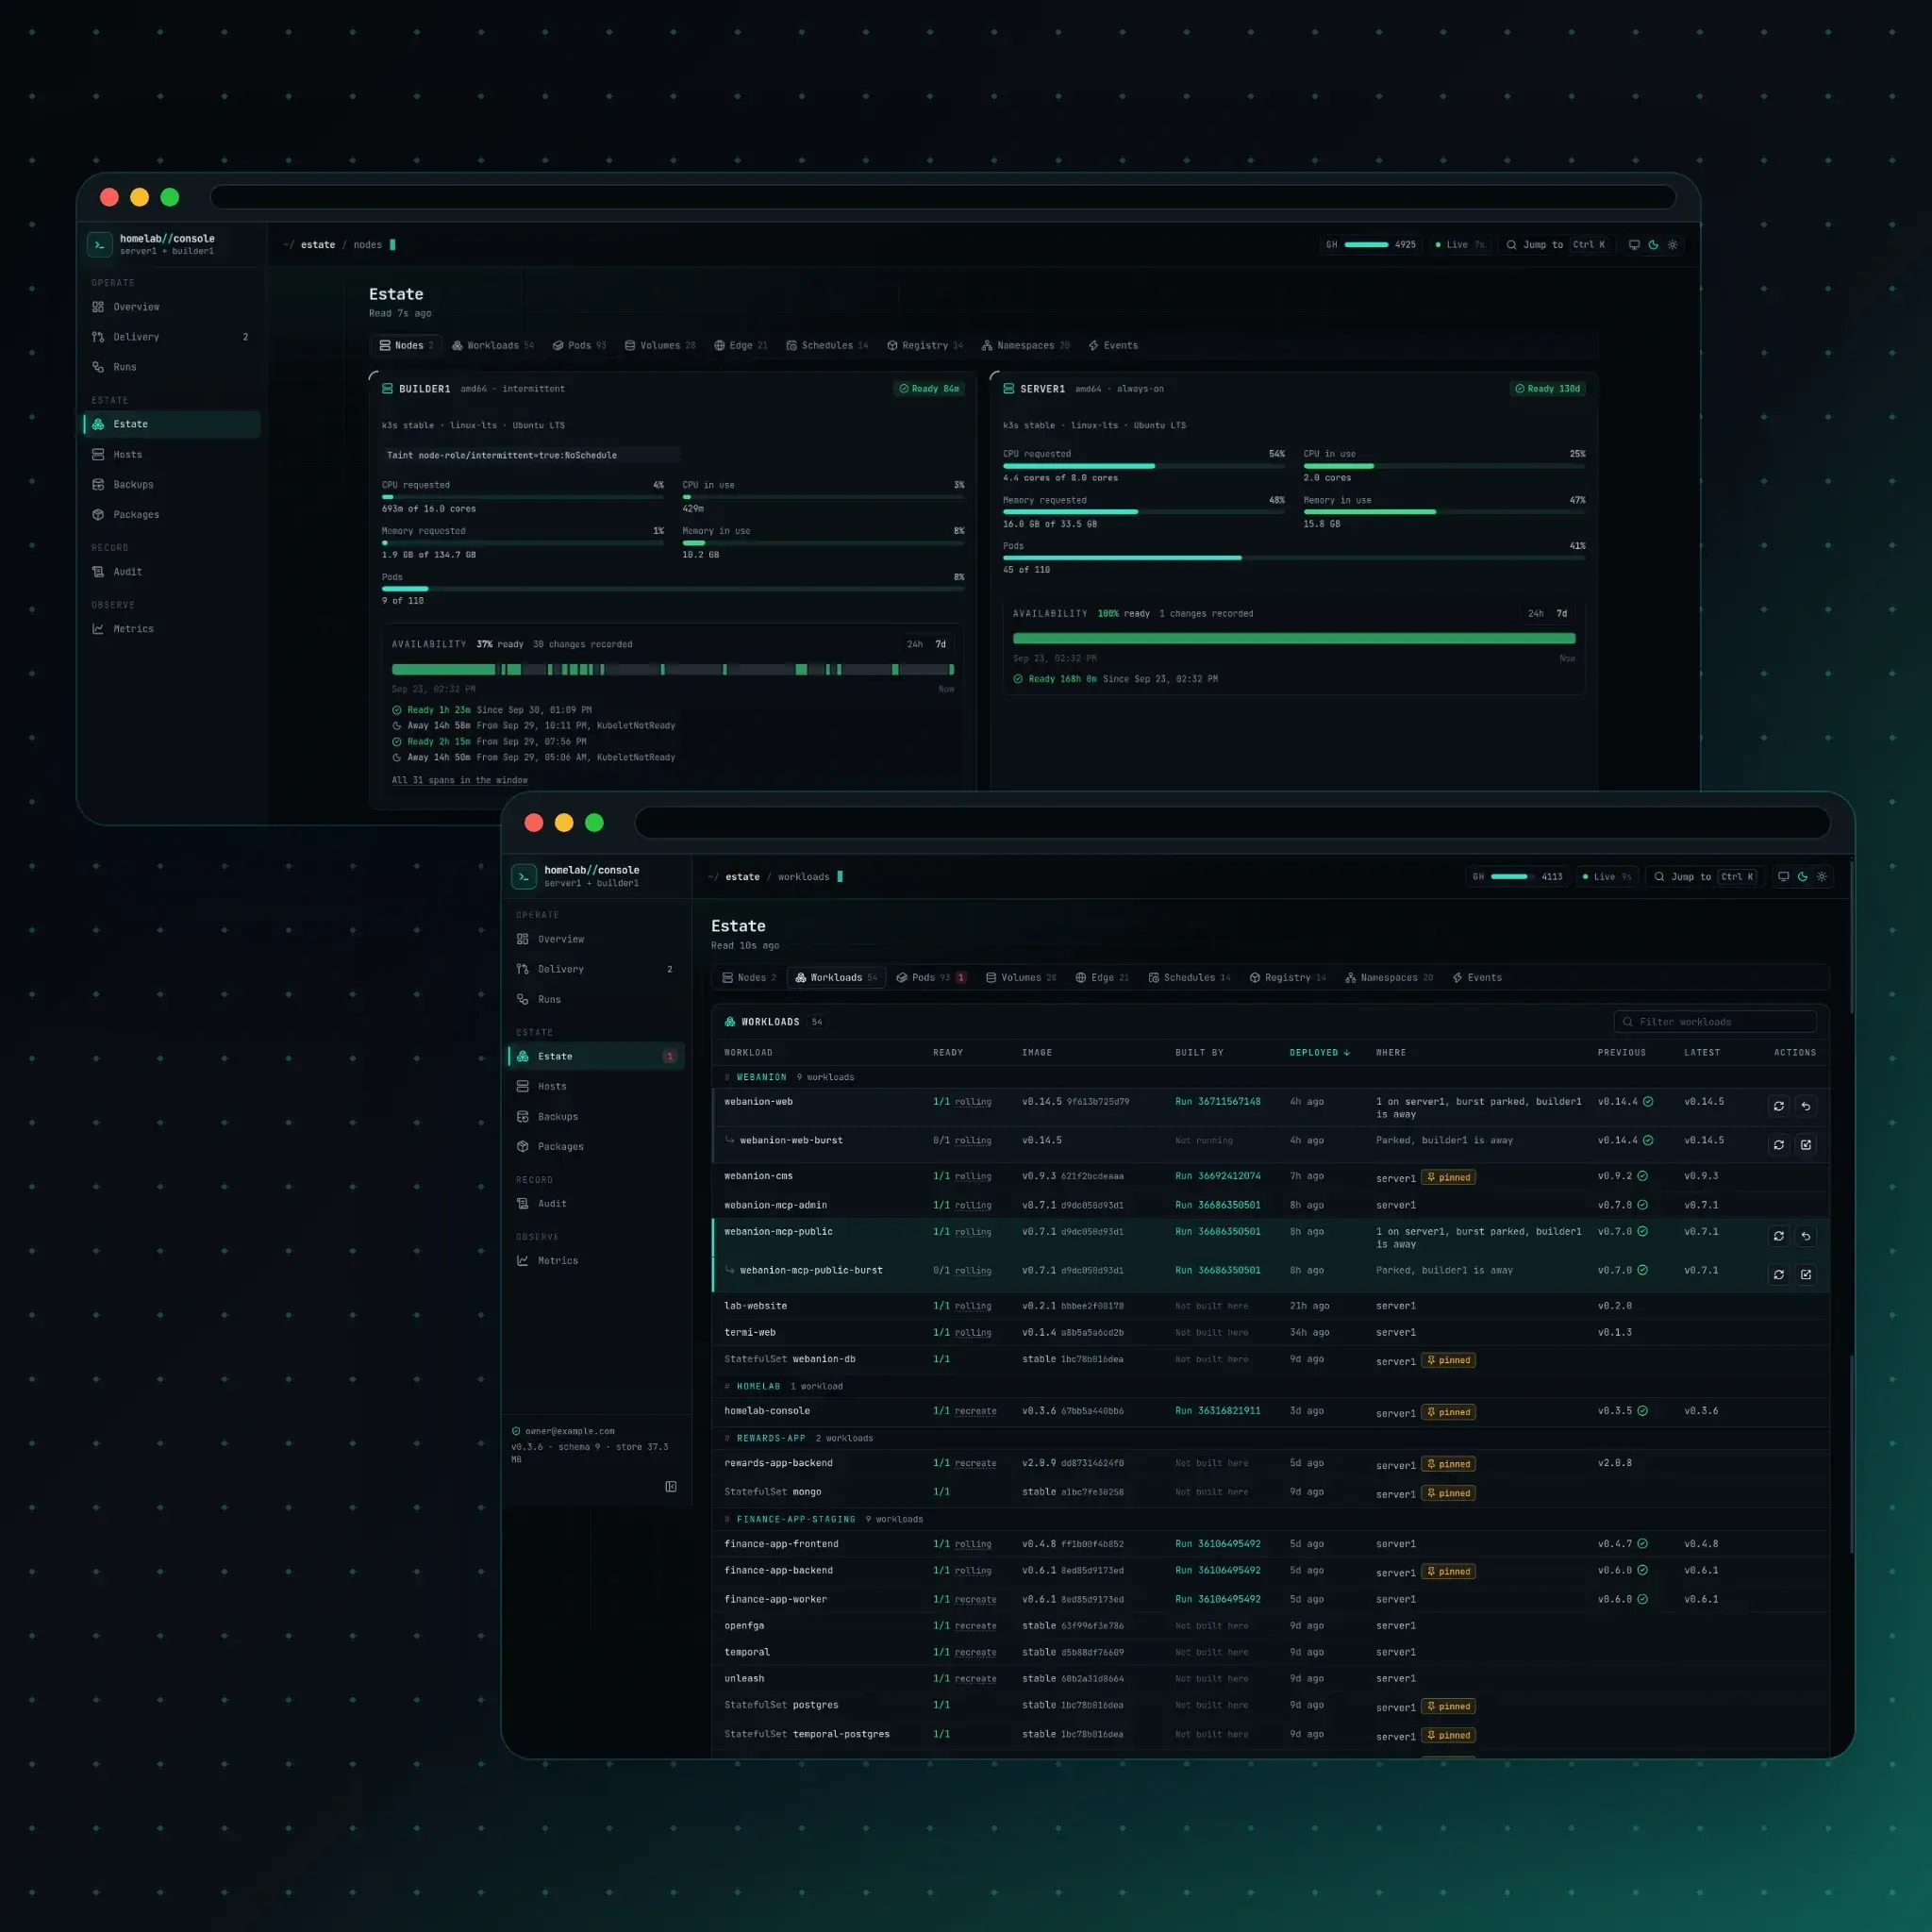
Una segunda máquina que puede apagarse en cualquier momento se unió a un clúster de un solo nodo en funcionamiento sin cambiar ninguna aplicación. Un servidor siempre encendido guarda el plano de control, cada base de datos y cada volumen y la primera copia de cada servicio; la máquina de compilación asume, detrás de un taint, las compilaciones y las segundas copias de los servicios sin estado, y esas copias esperan en lugar de volver cuando ella duerme. Se apaga sola cuando se acaba el trabajo y vuelve cuando entra un trabajo en cola, una consola muestra cada nodo, cada carga de trabajo y cada tramo de disponibilidad, y se midió cada CPU request del servidor siempre encendido, lo que llevó sus reservas del 84 % al 56 % de lo que puede asignar.
Md Moniruzzaman
sep 22, 2026
El blog son notas de campo desde producción: decisiones de arquitectura, sistemas de AI que sobrevivieron al contacto con usuarios reales e infraestructura que se paga sola. Escrito desde el trabajo, no sobre él.