
Un nodo pasó a ser un clúster sin cambiar ninguna aplicación
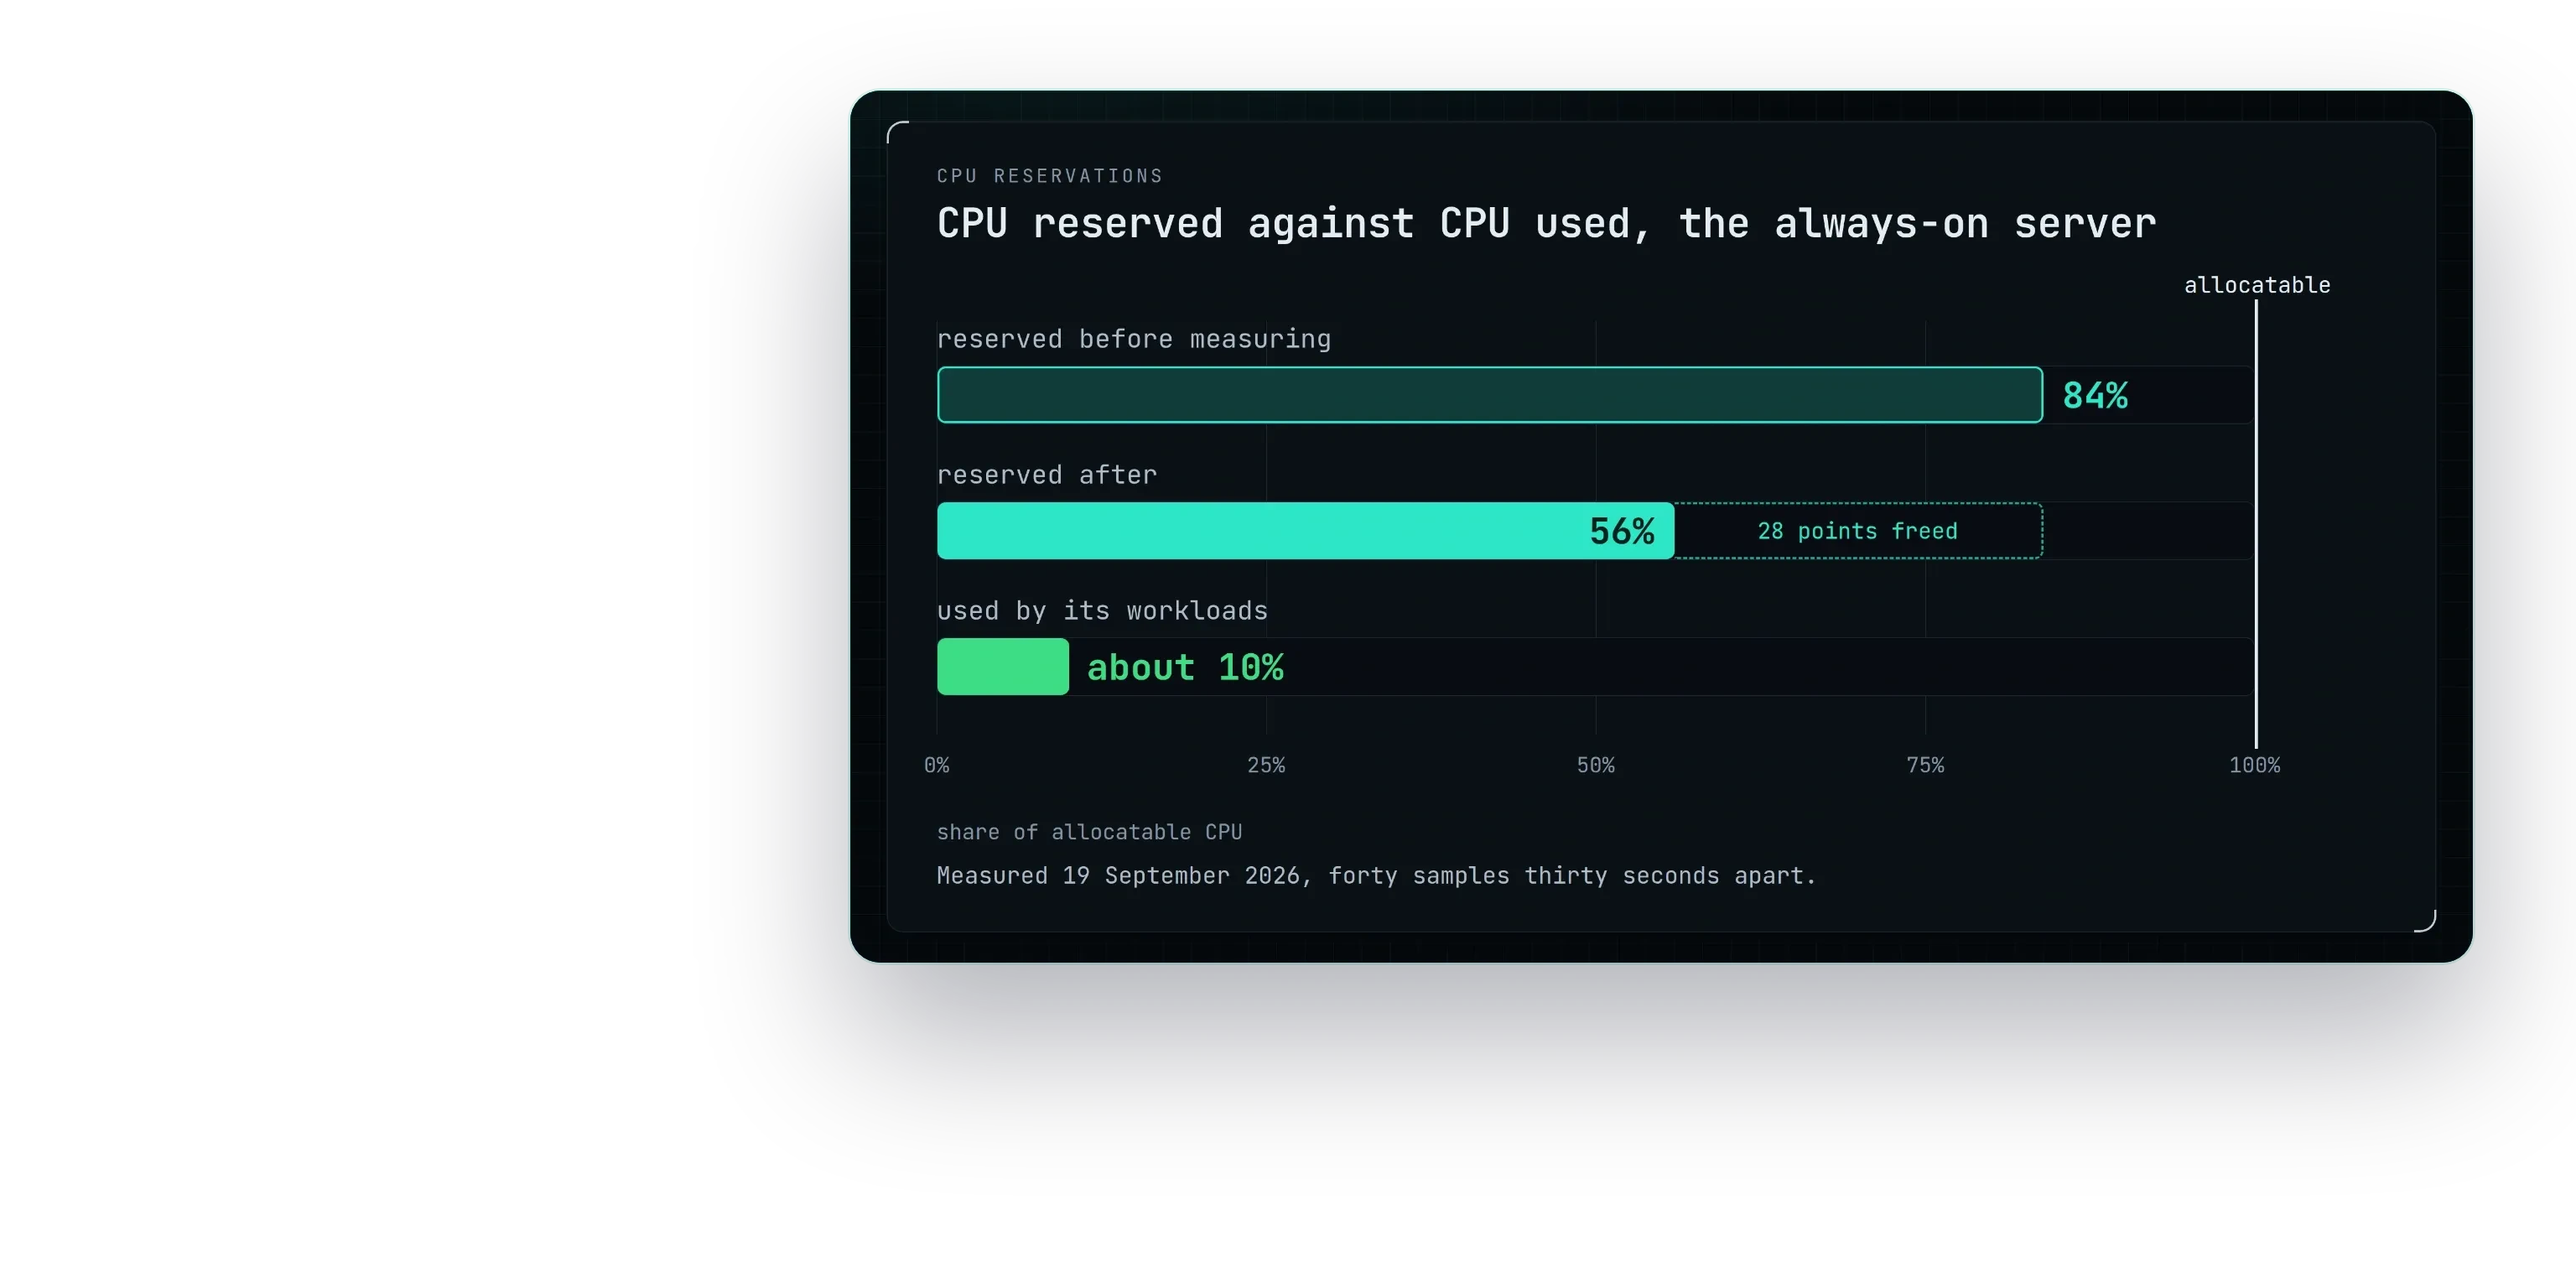
Una segunda máquina que puede apagarse en cualquier momento se unió a un clúster de un solo nodo en funcionamiento sin cambiar ninguna aplicación. Un servidor siempre encendido guarda el plano de control, cada base de datos y cada volumen y la primera copia de cada servicio; la máquina de compilación asume, detrás de un taint, las compilaciones y las segundas copias de los servicios sin estado, y esas copias esperan en lugar de volver cuando ella duerme. Se apaga sola cuando se acaba el trabajo y vuelve cuando entra un trabajo en cola, una consola muestra cada nodo, cada carga de trabajo y cada tramo de disponibilidad, y se midió cada CPU request del servidor siempre encendido, lo que llevó sus reservas del 84 % al 56 % de lo que puede asignar.
Md Moniruzzaman
La historia completa
Cómo se añadió capacidad a una infraestructura en marcha sin migrarla, y qué demuestra sobre operar la infraestructura en lugar de alquilarla.
Una máquina lo hacía todo y se quedó sin reservas
Durante sus primeros meses, el clúster era un único servidor siempre encendido que lo sostenía todo: el plano de control, cada base de datos y cada volumen, cada sitio público, el registro de imágenes y, en cada despliegue, la propia compilación. En cualquier nodo, una CPU request es una reserva que el planificador aparta tanto si el trabajo la usa como si no, y un nodo ocupado se queda sin reservas mucho antes de quedarse sin trabajo. El servidor siempre encendido había llegado al 84 % de la CPU que podía asignar, así que la siguiente carga de trabajo ya no cabía, por tranquila que pareciera la máquina.
Añadir capacidad es sencillo cuando la máquina nueva nunca desaparece. Lo difícil es una segunda máquina que puede apagarse en cualquier momento, y eso solo es seguro si el clúster sabe exactamente qué puede ejecutarse en ella y qué no debe depender nunca de ella. La regla que lo hizo seguro cabe en una línea: nada que guarde datos se ejecuta jamás en una máquina que pueda desaparecer.
Máquinas con tareas opuestas
Un servidor nunca se apaga y aloja el plano de control, cada base de datos y cada volumen, los registros y la primera copia de cada servicio. La máquina de compilación puede estar apagada en cualquier momento y, mientras está encendida, se encarga de las compilaciones y de las segundas copias. Una etiqueta de rol y un taint deciden qué puede ir a cada sitio, y nada llega a la máquina de compilación a menos que lo pida.

El estado de cada nodo en una pantalla, incluidos los que duermen
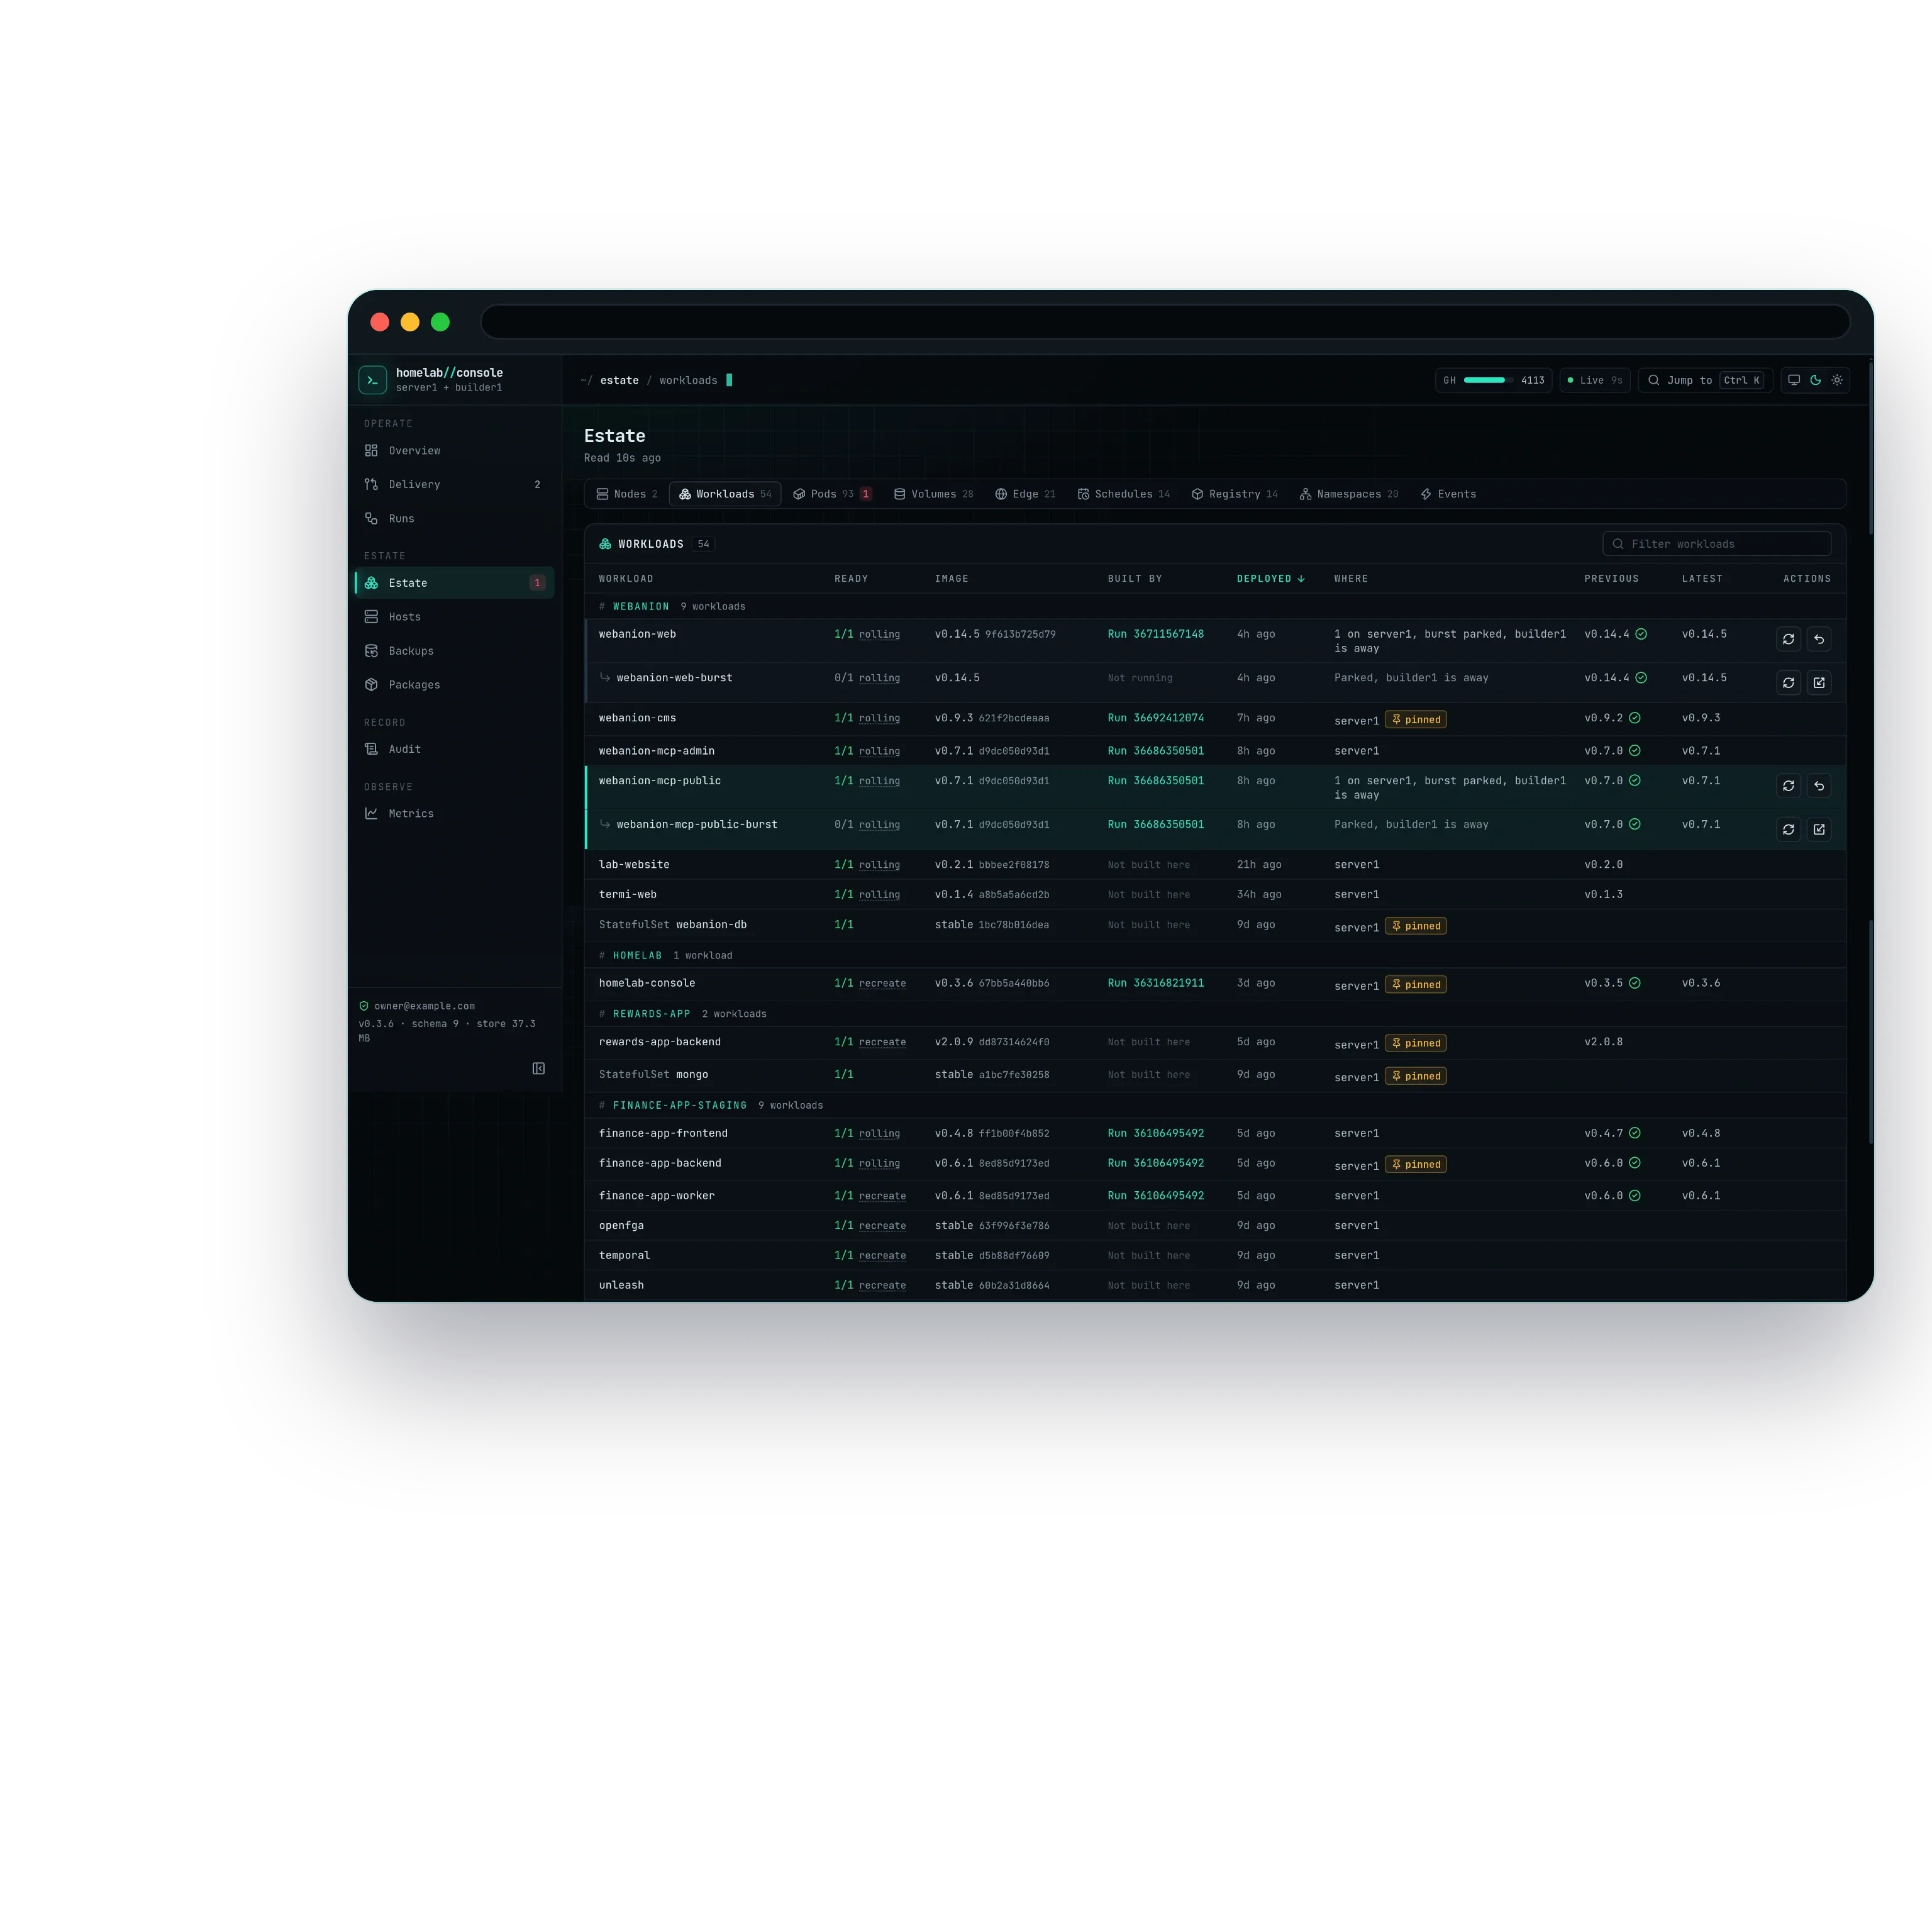
La vista Estate de la consola da a cada nodo una tarjeta: su rol, lo que sus cargas de trabajo han solicitado frente a lo que usan, cuántos pods lleva y una franja de disponibilidad del último día o de la última semana con cada tramo de Ready y Away. Las tarjetas se leen como opuestas a propósito. El día de la captura, el servidor siempre encendido llevaba Ready los siete días anteriores completos, y la máquina de compilación el 37 % de ellos, con 30 cambios registrados, porque duerme siempre que no hay trabajo.
Son los roles y un taint, no la suerte, lo que mantiene cada carga de trabajo en su sitio. El servidor siempre encendido lleva su rol y ningún taint, así que las cargas de trabajo normales van allí. La máquina de compilación lleva un taint que rechaza todo pod que no haya declarado que puede vivir en un nodo que desaparece, así que nada acaba en ella por accidente, y las cargas de trabajo que guardan datos en un disco están fijadas al servidor donde está ese disco.


Nada cae en el nodo equivocado y nadie espera a ninguno
Un servicio sin estado que se beneficia de más capacidad recibe una segunda copia en lugar de mudarse. Su original se queda en el servidor siempre encendido y atiende solo cuando la máquina de compilación está apagada. La segunda copia puede ejecutarse en la máquina de compilación y en ningún otro sitio: mientras esa máquina duerme, la copia espera aparcada y nunca vuelve al servidor siempre encendido, cuyas reservas son el recurso escaso. Cuando la máquina vuelve, las copias arrancan solas y se reincorporan al tráfico.
La capa de entrada está ajustada para un nodo que desaparece sin avisar. Una copia en una máquina que se ha quedado sin corriente no rechaza conexiones, simplemente deja de responder, así que el enrutador se rinde con ella en pocos segundos en lugar de medio minuto y reintenta una vez, solo en peticiones de página, y el visitante recibe la página un momento más tarde en lugar de un indicador de carga girando. El 22 de septiembre, ocho servicios tenían una segunda copia, entre ellos el sitio web y el servidor MCP público; las bases de datos, el CMS y todos los backends siguen con una sola copia en el servidor siempre encendido. Las capturas muestran los dos estados: las copias aparcadas mientras la máquina de compilación dormía, y el sitio web y el servidor MCP atendidos desde cada nodo mientras estaba encendida.

Capacidad que duerme hasta que hay trabajo
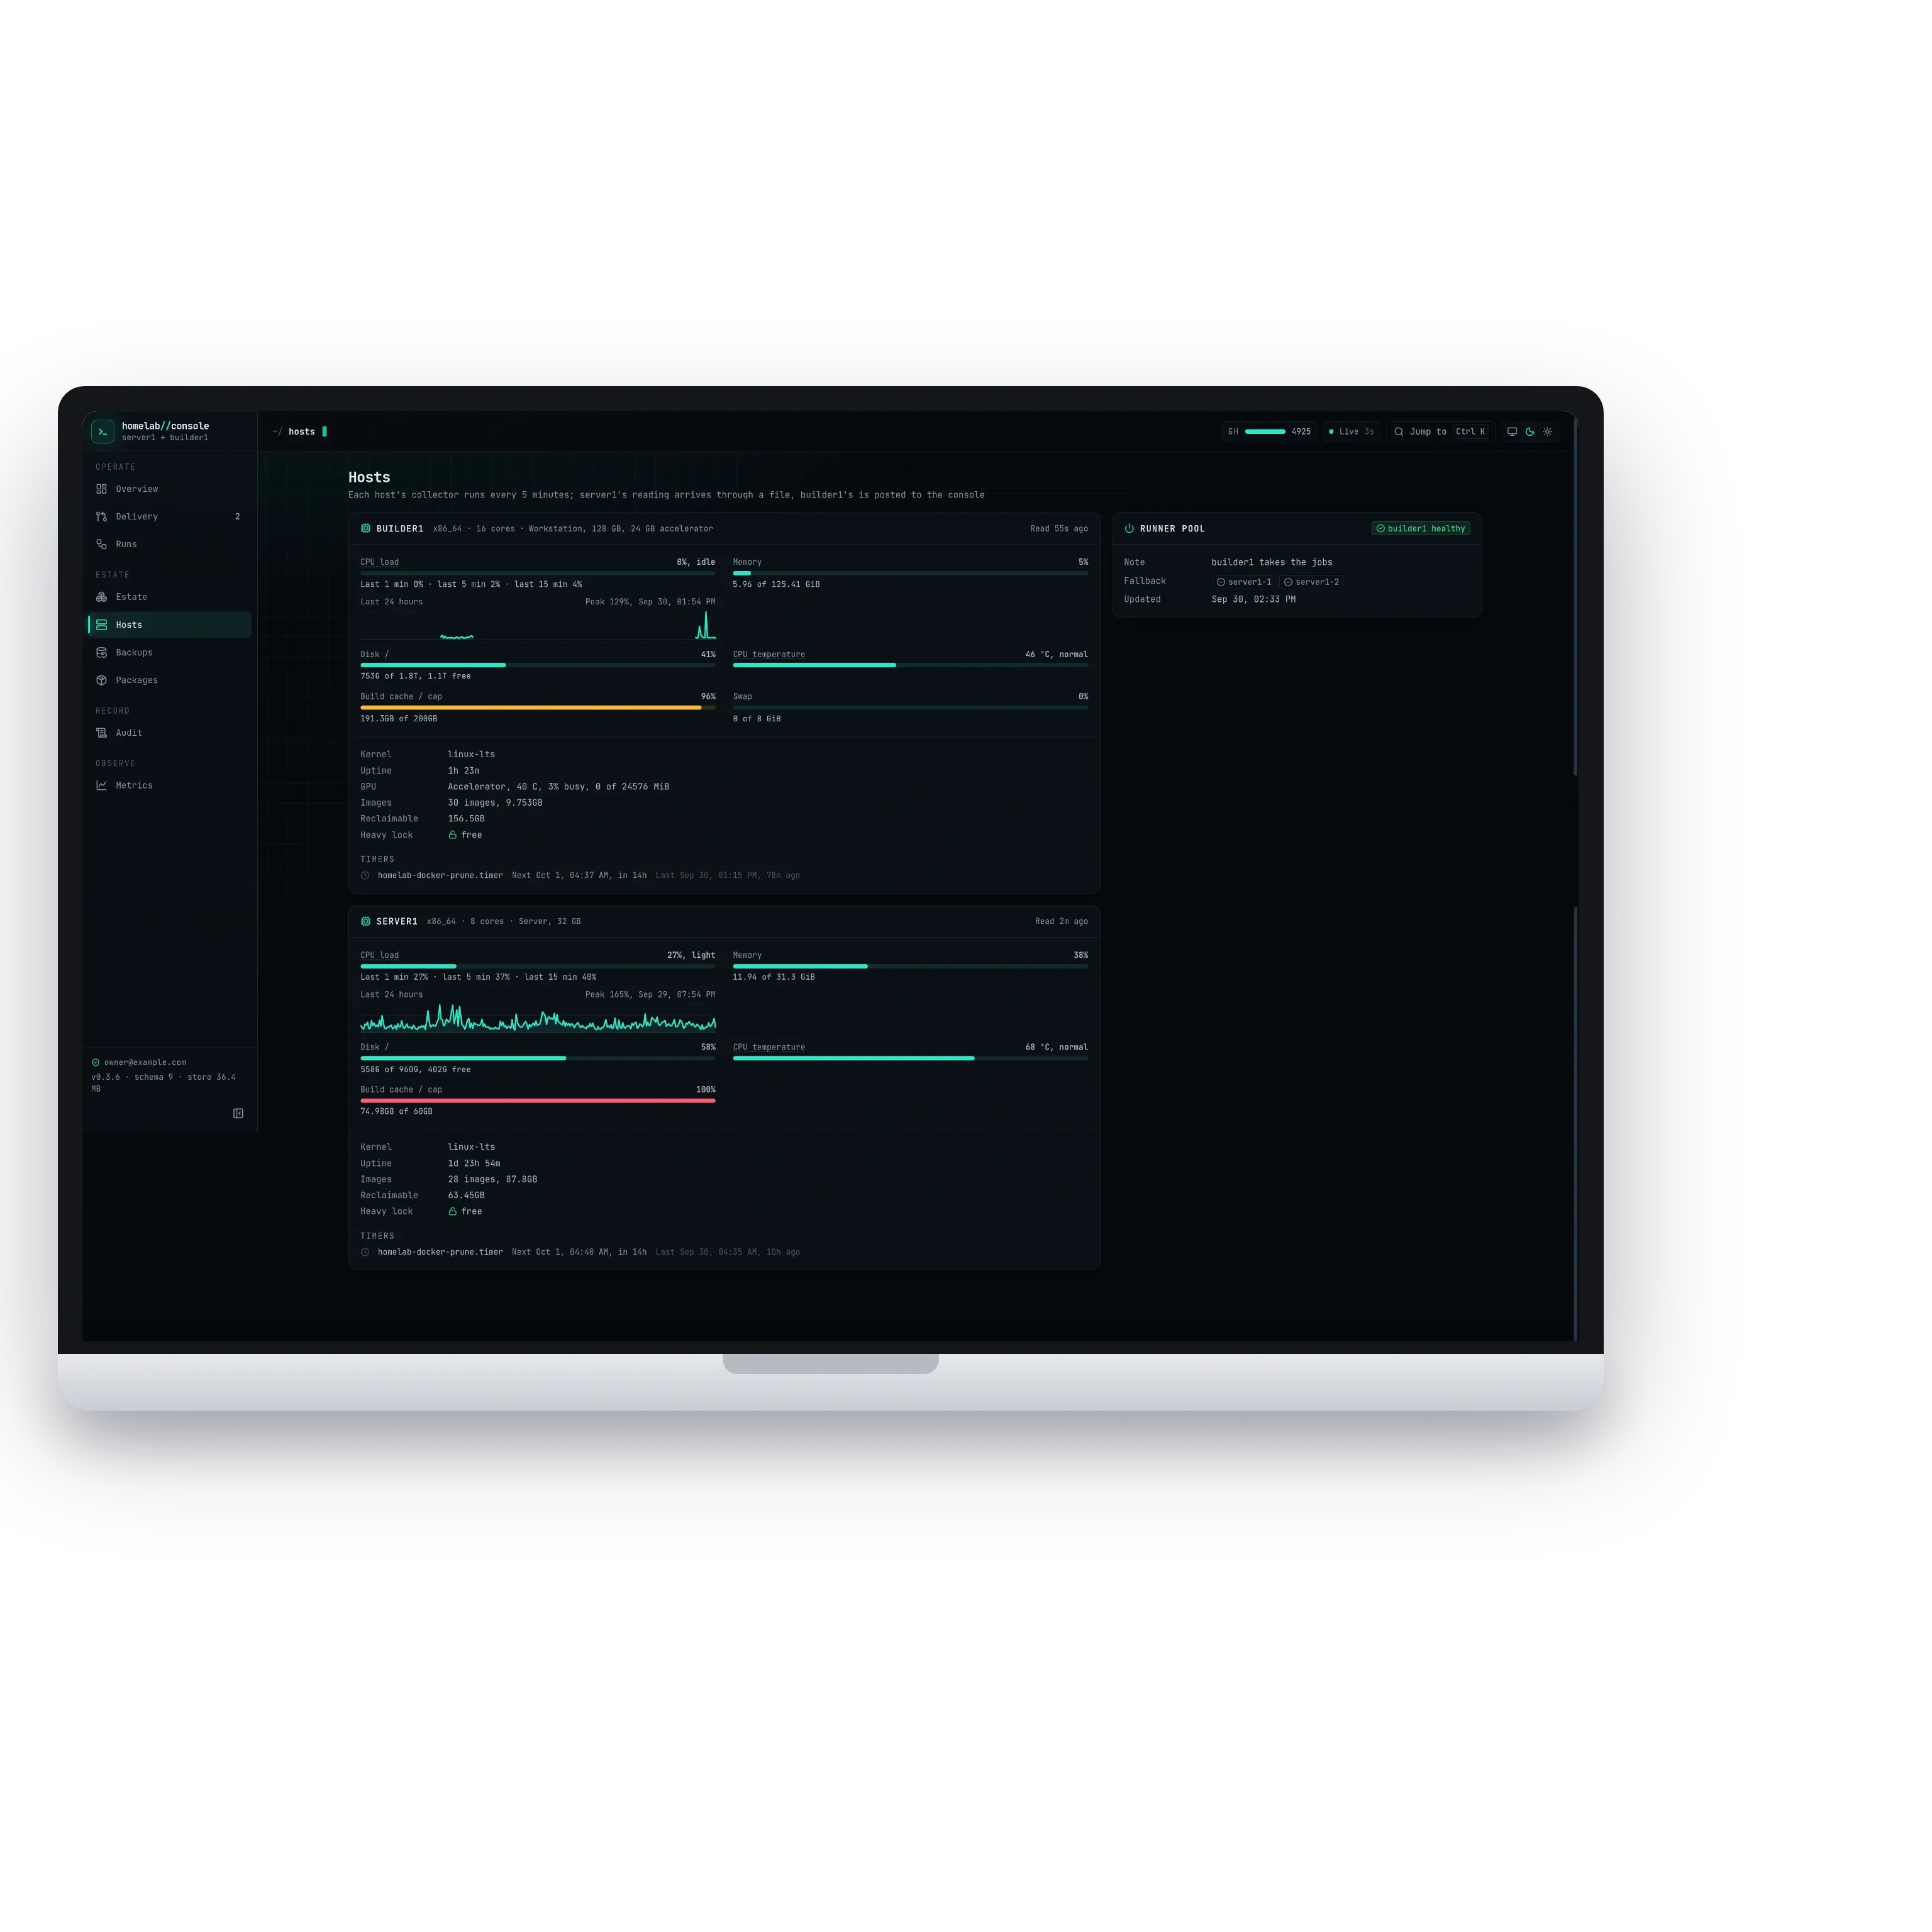
La máquina de compilación consume entre sesenta y setenta vatios sin hacer nada, así que no se queda ahí sin hacer nada. Cuando se acaba el trabajo, se apaga sola, y cuando entra un trabajo en cola vuelve al clúster en un par de minutos, sin que nadie tenga que acordarse de encenderla. La vista Hosts pone las máquinas una junto a otra: la carga con un día de historial, la memoria, el disco, la temperatura y la caché de compilación frente a su límite.
La vista en el teléfono muestra la otra mitad del diseño. Mientras la máquina de compilación está fuera, sus últimas lecturas siguen en pantalla, marcadas con su antigüedad, de modo que un hueco vacío se lee como una máquina en reposo y no como una avería. Lo que se gana es capacidad disponible cuando llega el trabajo y apagada cuando no lo hay.

Las requests eran el recurso escaso, así que se midieron todas
Cada request del servidor siempre encendido se midió con cuarenta muestras tomadas cada treinta segundos y se ajustó al pico de cada carga de trabajo más un margen. El servidor estaba reservando casi nueve veces lo que usaban sus cargas de trabajo; después, sus reservas bajaron del 84 % al 56 % de lo que puede asignar, sitio de sobra para el siguiente servicio sin otra máquina.

La próxima máquina es un rol, no un proyecto
Ninguna aplicación cambió por el camino. La ubicación vive en una etiqueta de rol, un taint, las affinities y el overlay propio de cada servicio, así que los servicios nunca supieron cuántas máquinas hay. Eso es también lo que convierte el siguiente paso en rutina: la próxima máquina se une recibiendo un rol y una parte de los runners de compilación, un servicio activa una segunda copia desde su propio repositorio, y otro clúster con el mismo patrón repite los mismos pasos en lugar de necesitar un diseño nuevo. Escala en ambas direcciones, porque apagar la máquina de compilación no pierde nada ni necesita un drain; solo se va la velocidad extra.
El límite se declara en lugar de descubrirse: un corte de luz en mitad de una compilación hace fallar esa compilación, y se vuelve a ejecutar. Esto encaja con una empresa que tiene hardware propio y necesita más capacidad sin una migración, y responde a la pregunta que se hace un CTO antes de entregar su infraestructura: si la persona que tiene delante sabe operarla además de escribir código para ella. La plataforma de debajo es la historia del homelab autoalojado que sostiene el estudio, y lo que la máquina de compilación hizo por las entregas es la historia de sustituir la CI alojada por un grupo de runners propio.
También te puede gustar

La CI alojada era lo más lento y las compilaciones volvieron a casa
Las compilaciones y los despliegues pasaron de los runners alojados de GitHub, donde cada ejecución empezaba en una máquina nueva y las entregas esperaban colas e incidentes, a un pool de runners en casa: una máquina de compilación que toma cada trabajo mientras está encendida y runners de reserva en un servidor siempre encendido, detrás de un watchdog que, ante la duda, se inclina por seguir entregando. Las imágenes van a un registro de contenedores privado y las librerías del estudio a un registro npm privado, ambos dentro del edificio, y cada ejecución se archiva más allá de la retención de GitHub. El despliegue más lento pasó de ocho minutos y veinticuatro segundos a tres minutos y cinco, y la CI fue un tercio más rápida.
Md Moniruzzaman
sep 24, 2026
27 Pearls - Lanzamiento móvil y envío a tiendas
Una app de 27 Pearls terminada se convirtió en fichas aprobadas en App Store y Google Play dentro de un encargo de una semana, sin rondas de rechazos. La semana incluyó las compilaciones de publicación y la firma, textos de ficha escritos en torno al beneficio para el estudiante, capturas para cada tamaño de dispositivo exigido, declaraciones de privacidad acordes con lo que la app recoge y una cuenta de revisión que funcionaba. La app sigue hoy en Google Play.

Md Moniruzzaman
may 05, 2023

Fully Booked - Migración sin Tiempo de Inactividad a Kubernetes Autoalojado
Fully Booked funcionaba sobre infraestructura gestionada en la nube, con una factura que crecía cada mes y una pila que nadie controlaba del todo. Trasladamos toda la plataforma a un clúster de Kubernetes autoalojado sin un minuto de interrupción para quienes la usaban. El cambio abarcó DNS, ingress, bases de datos y el pipeline de despliegue, escalonado de modo que el tráfico se movía solo una vez probada cada capa en el clúster nuevo. Nadie que usara la aplicación esa semana notó nada, que era exactamente el objetivo. La factura recurrente pasó a ser hardware propio, y ese mismo clúster sostiene hoy las publicaciones semanales de la plataforma.

Md Moniruzzaman
jun 23, 2026

El blog son notas de campo desde producción: decisiones de arquitectura, sistemas de AI que sobrevivieron al contacto con usuarios reales e infraestructura que se paga sola. Escrito desde el trabajo, no sobre él.