Un homelab autoalojado que sostiene el estudio, mantenido a diario
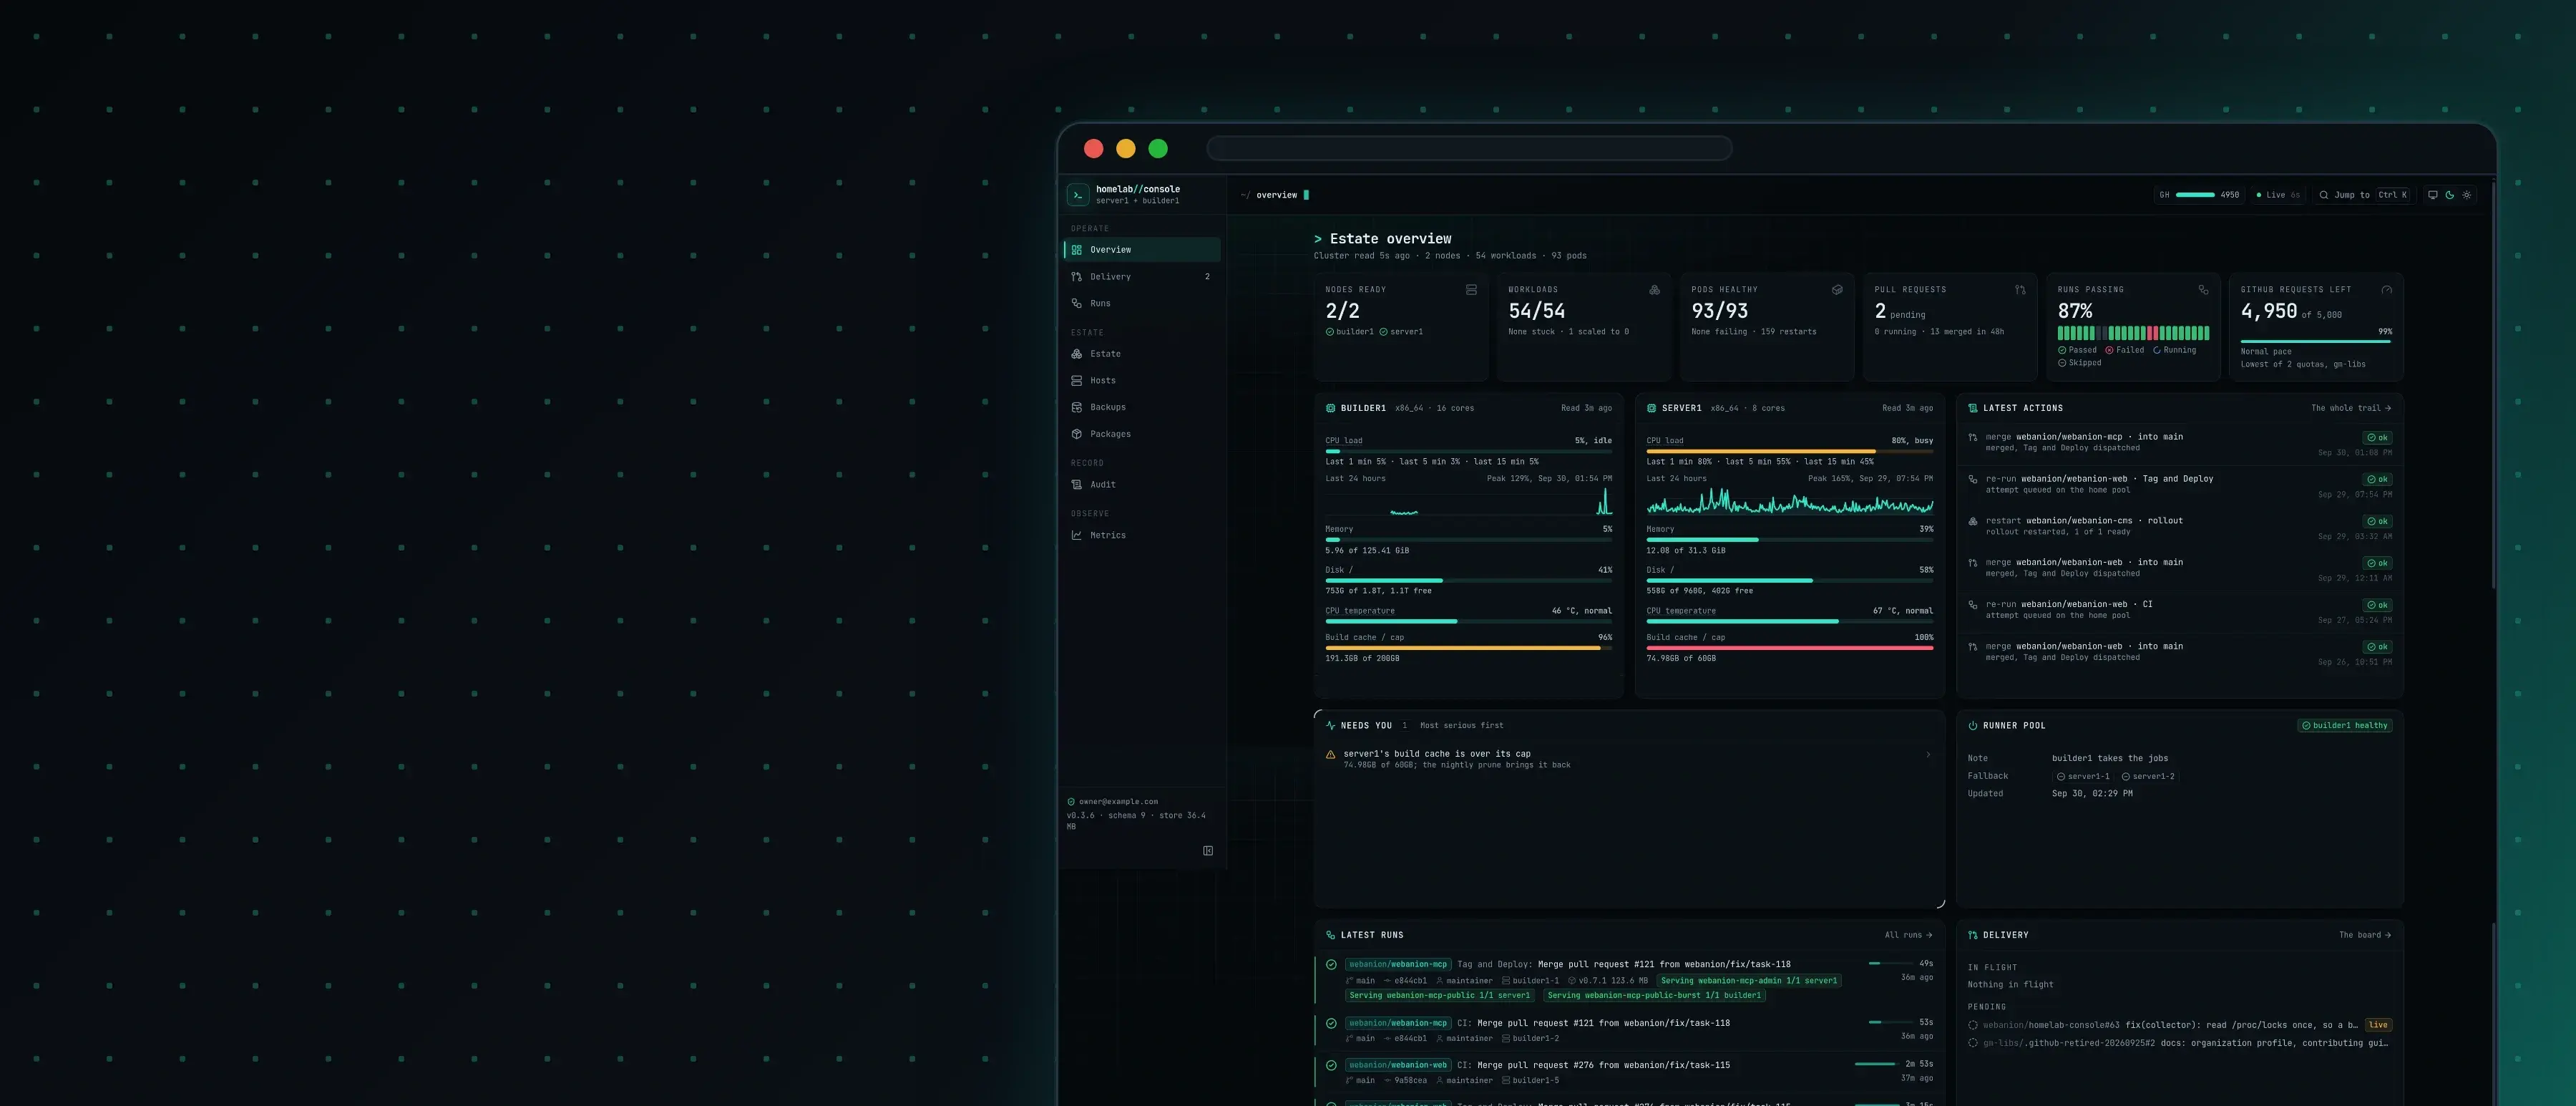
La infraestructura propia del estudio sobre un clúster de Kubernetes autoalojado, planificada en febrero de 2026 y mantenida cada día desde entonces: su sitio web, su CMS, sus servidores MCP y las plataformas de clientes que cuida, servidos a través de túneles de Cloudflare, con cada base de datos volcada y verificada cada noche, métricas y reglas de alerta que llegan a un teléfono, un monitor de caídas fuera de casa, un registro de contenedores y un registro npm, y una única consola privada que une merges, ejecuciones, imágenes, pods y nodos en una sola página.
Md Moniruzzaman
La historia completa
Lo que cuesta ser dueño de toda la infraestructura en lugar de alquilar un panel por proveedor, y lo que un estudio gana al cuidarla cada día.
Todo lo que el estudio publica corre en servidores propios
Un estudio que crea productos para sus clientes también mantiene en marcha una cantidad sorprendente de sistemas propios. Webanion sirve su sitio web en todos sus idiomas, el CMS que hay detrás, servidores MCP públicos y privados que permiten a los asistentes de IA leer y gestionar ese contenido, y las plataformas que construye y cuida para sus clientes, entre ellas una plataforma financiera, una plataforma de reservas, una app de contabilidad y el sitio de un grupo de investigación. Cada una necesita un lugar donde ejecutarse, una base de datos con copia de seguridad, un certificado que se renueve y alguien que se entere cuando algo falla. Alquilar cada pieza a su propio proveedor supone una factura, un panel y un punto ciego por proveedor, y ningún sitio único que responda a las tres preguntas que deciden una jornada: qué está en marcha, si está sano y qué necesita atención hoy.
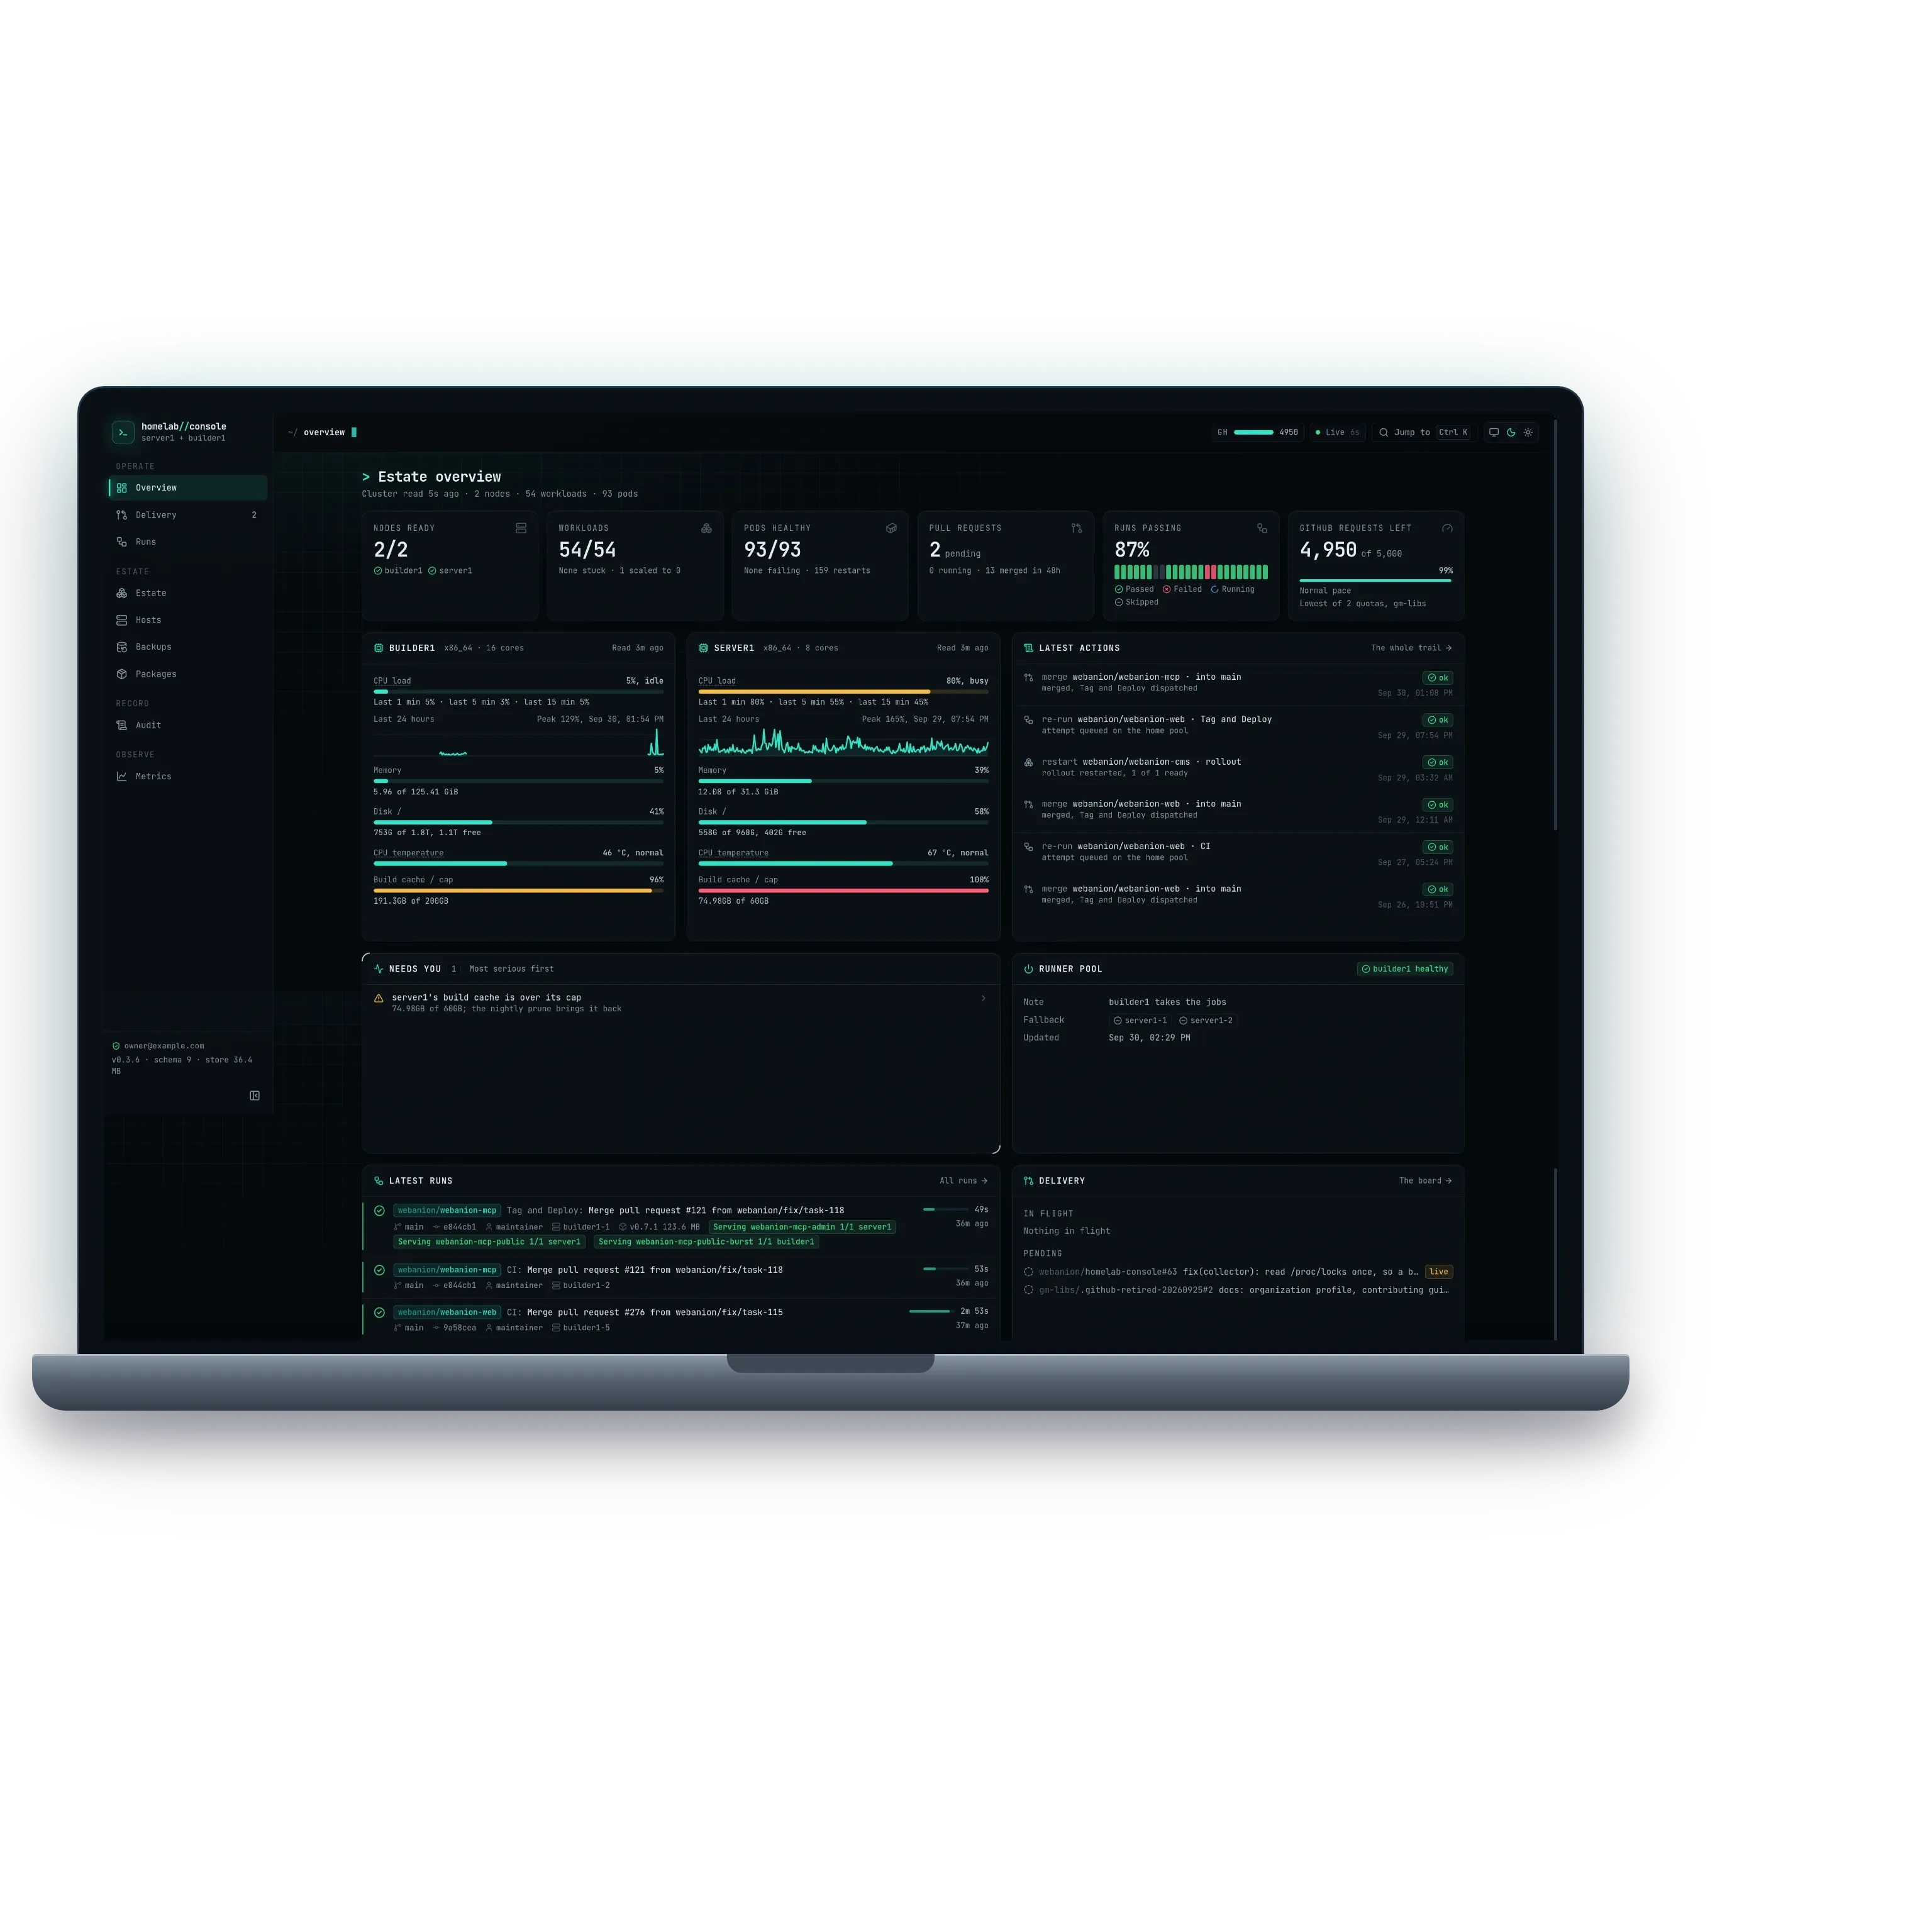
La respuesta aquí es un clúster de Kubernetes sobre servidores propiedad del estudio, planificado en febrero de 2026 y mantenido cada día desde entonces. Todos los sitios y plataformas se sirven desde él a través de túneles de Cloudflare, todas las bases de datos se vuelcan cada noche, las métricas y las reglas de alerta vigilan el clúster desde dentro y un monitor de caídas lo vigila desde fuera de casa, un registro de contenedores y un registro npm guardan las imágenes y los paquetes propios del estudio, y una única consola privada lo abarca todo. El día de las capturas, el 30 de septiembre de 2026, la consola contaba dos nodos, cincuenta y cuatro cargas de trabajo y noventa y tres pods.
Una página que dice qué está en marcha y qué necesita atención
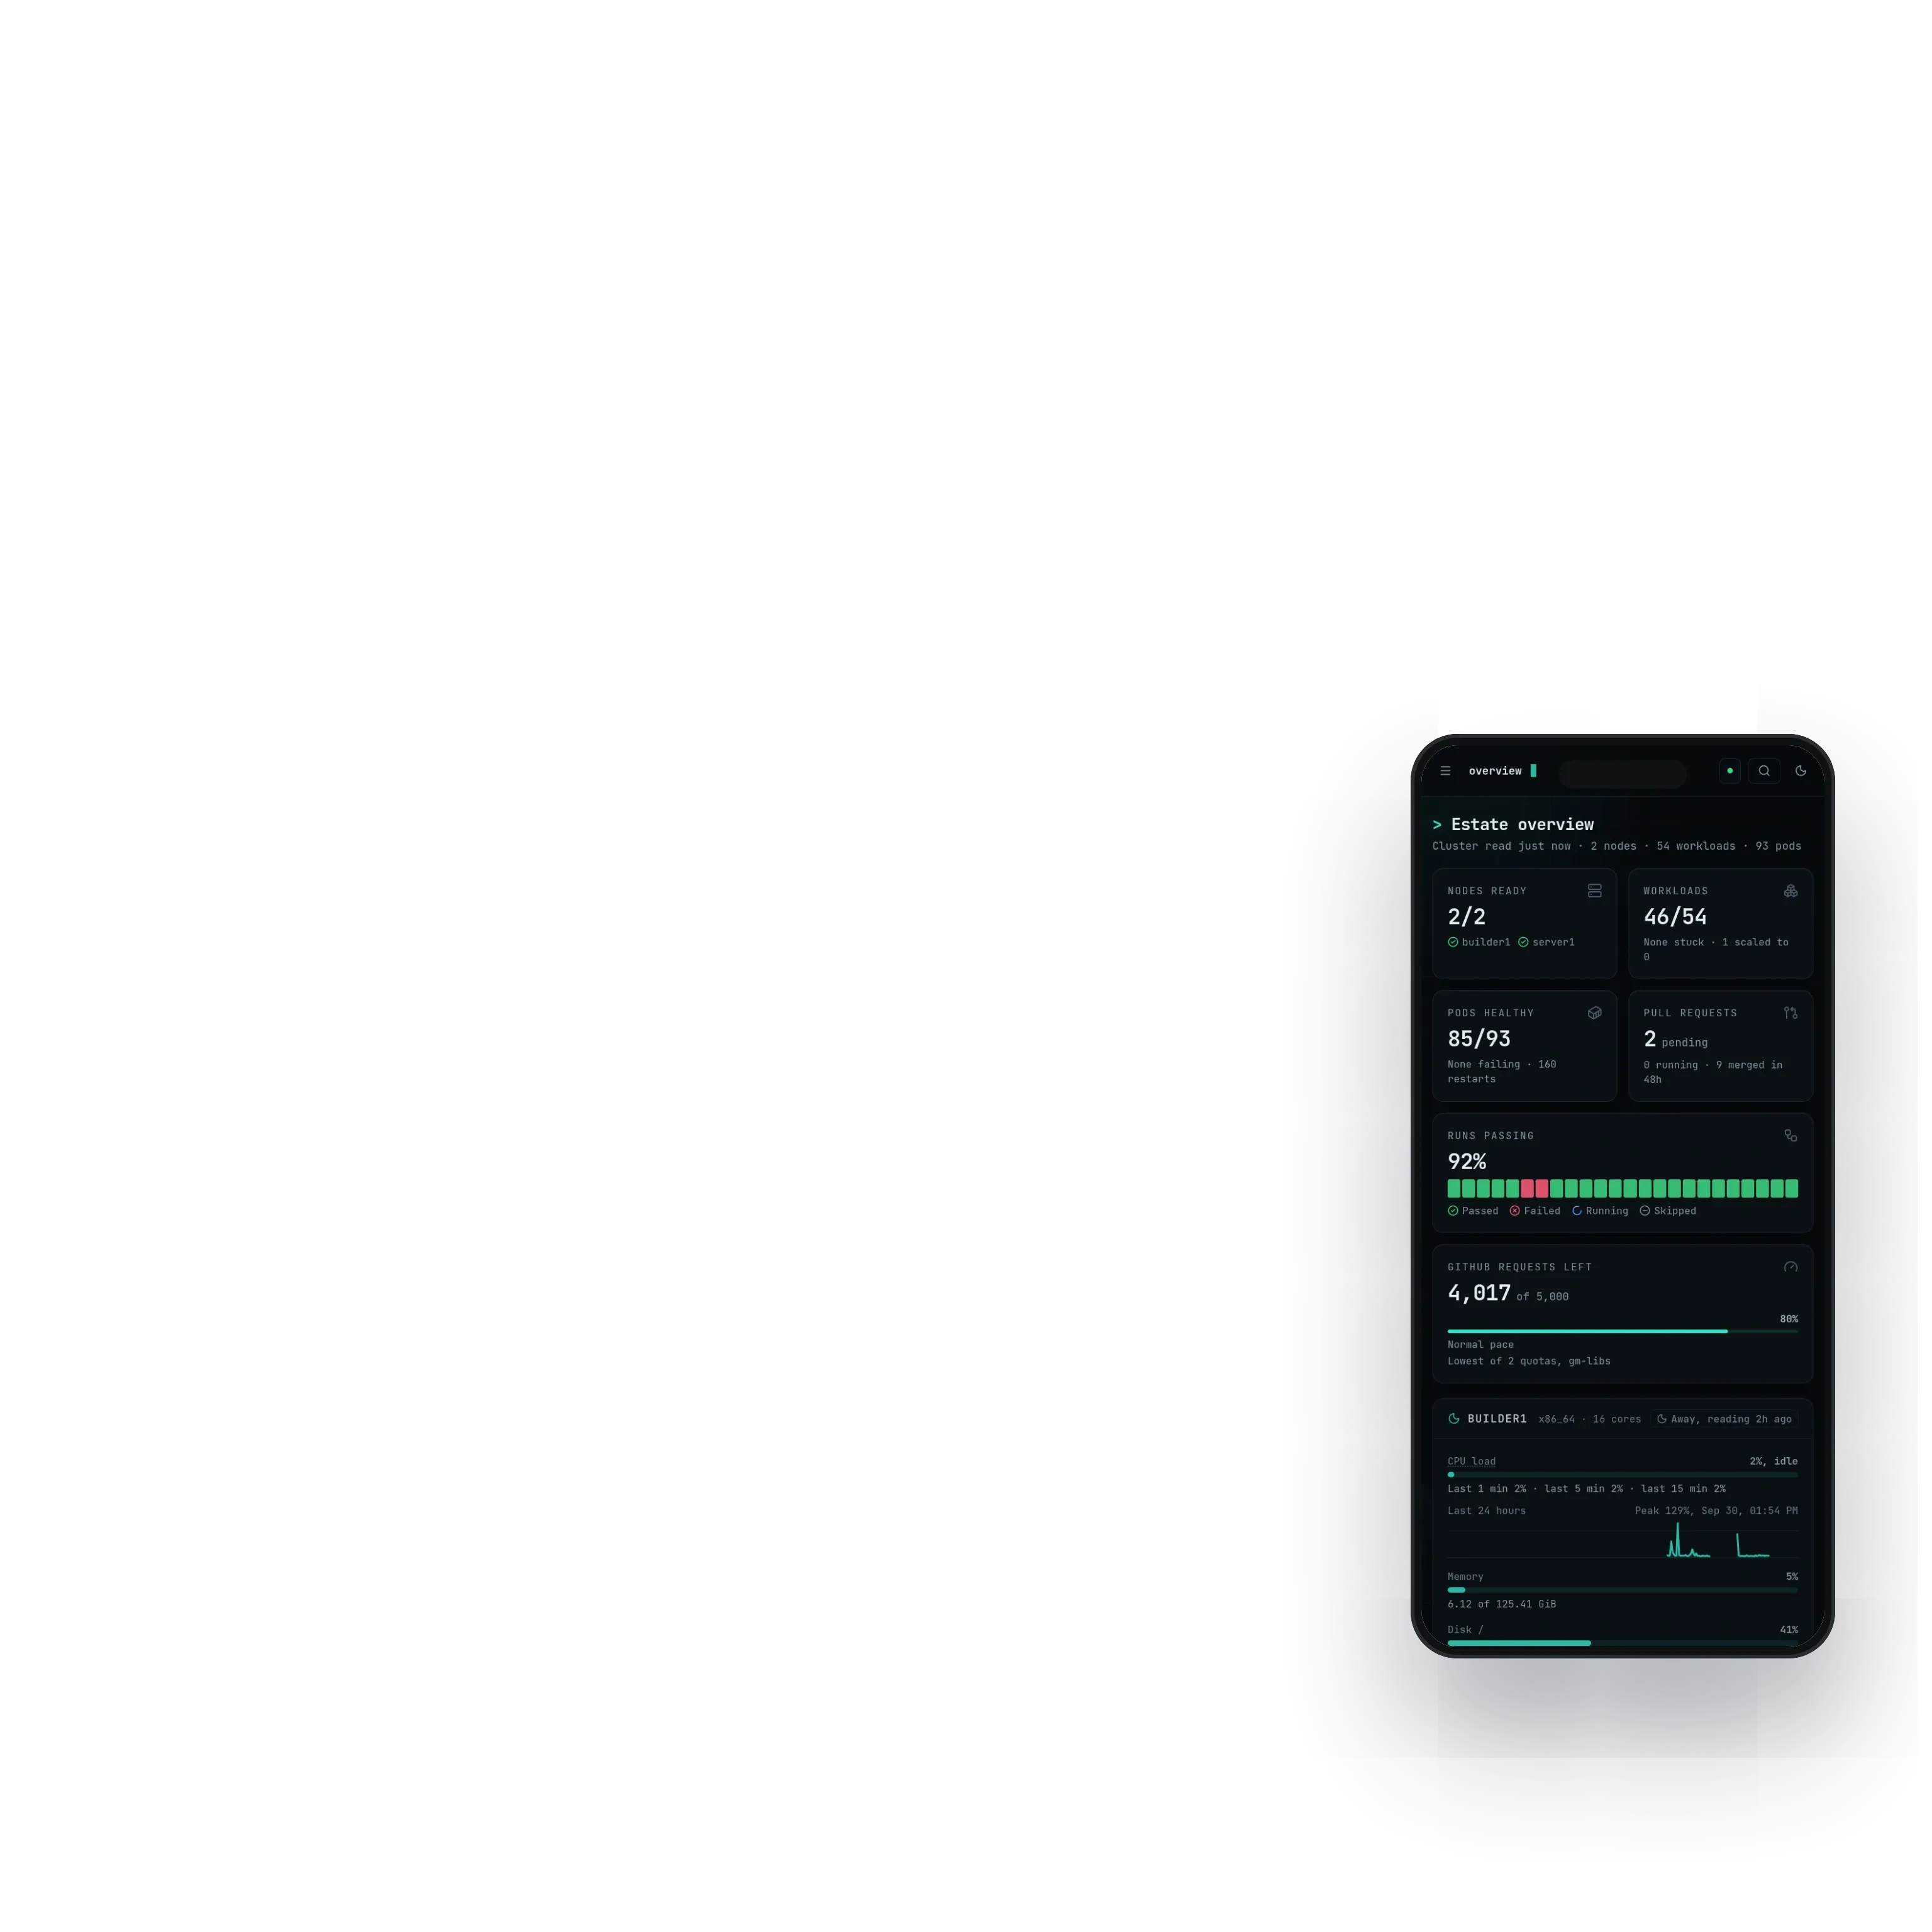
La consola es la primera página que se abre por la mañana y la que queda abierta durante un merge. Su vista general lee a la vez el clúster, GitHub, los registros y los hosts: nodos listos, cargas de trabajo y pods sanos, pull requests pendientes y fusionados, la proporción de ejecuciones recientes que pasaron, lo que queda del cupo de peticiones a GitHub, la carga, la memoria, el disco, la temperatura y la caché de compilación de cada host, las últimas acciones realizadas y una lista corta de lo que necesita una mano hoy, lo más grave primero.
Lo que aporta es la conexión: este merge, la ejecución que lanzó, la imagen que esa ejecución publicó, el pod que ejecuta esa imagen y el nodo en el que está el pod, en una sola página en lugar de cinco pestañas. Está detrás de Cloudflare Access y funciona con el ancho de un teléfono, porque el momento en que algo necesita revisión rara vez coincide con tener el portátil abierto. El día de las capturas marcaba dos de dos nodos listos, cincuenta y cuatro de cincuenta y cuatro cargas de trabajo, noventa y tres de noventa y tres pods sanos y trece merges en los dos días anteriores.
Cada merge sale de un solo tablero
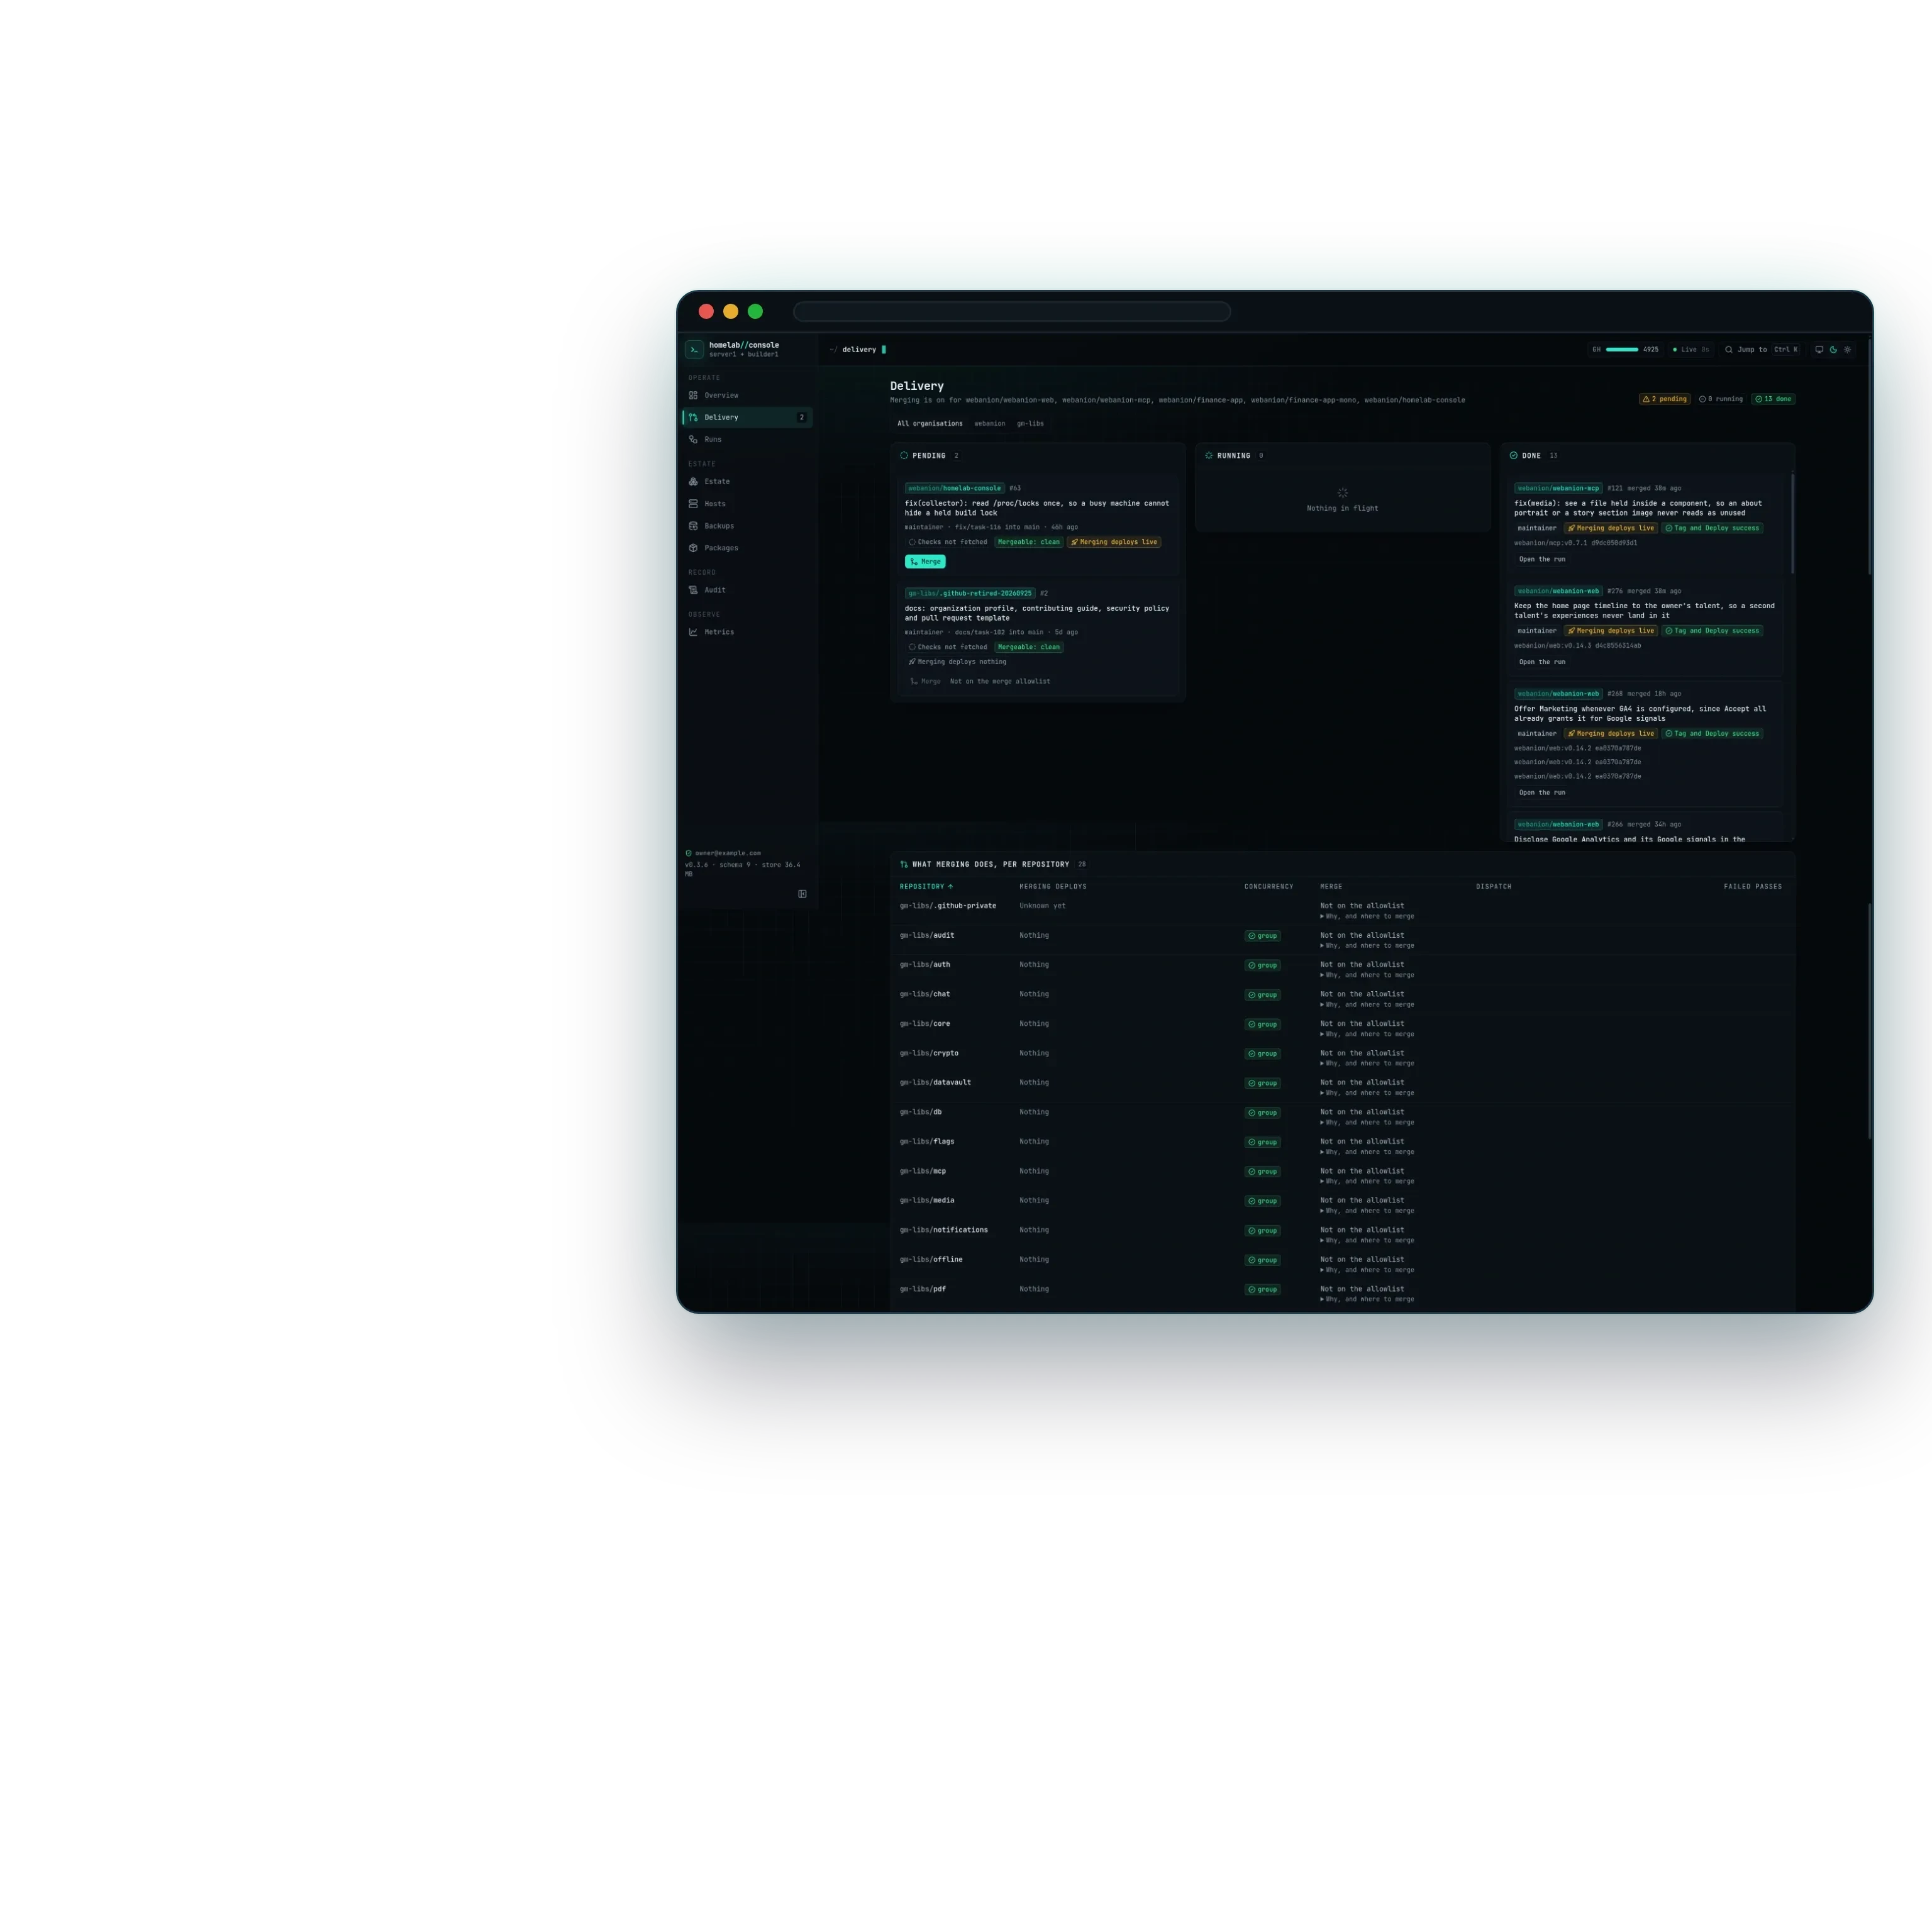
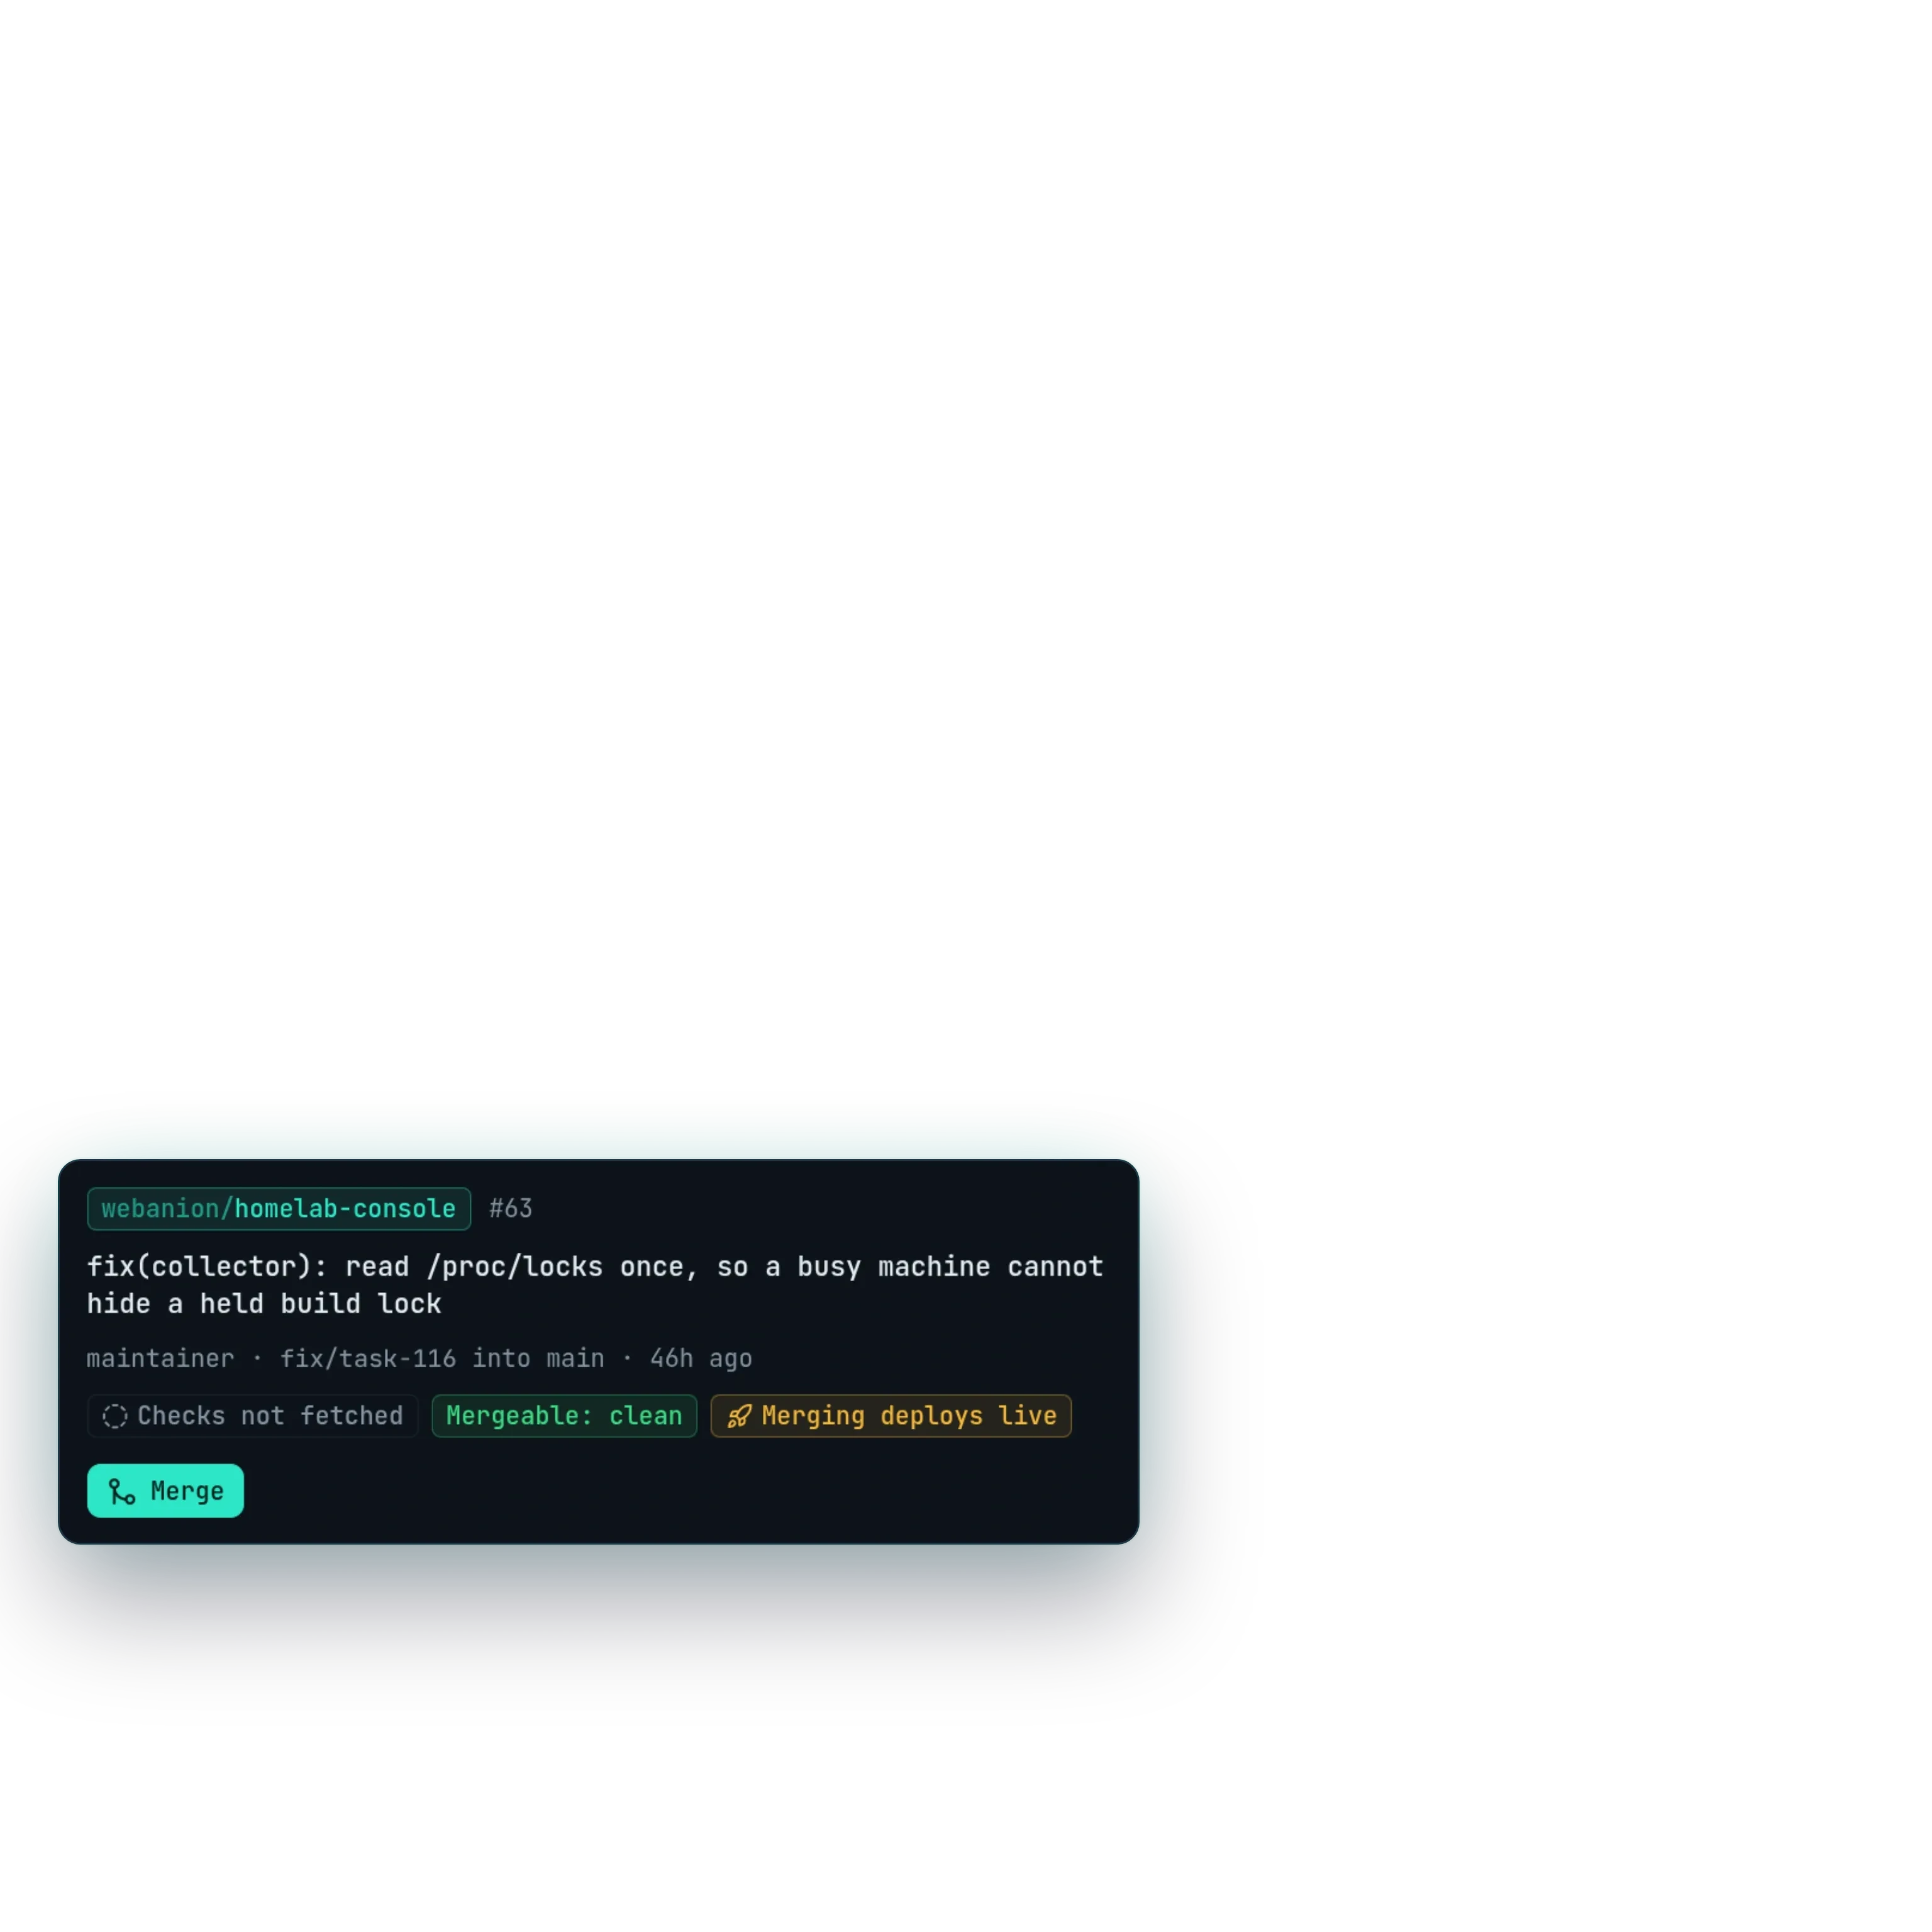
Los pull requests de las organizaciones de GitHub del estudio están en un solo tablero, pendientes, en curso y terminados, y cada tarjeta dice qué hará su merge: desplegar en producción, desplegar en staging o nada. Debajo del tablero, una tabla recorre repositorio por repositorio si se puede fusionar desde aquí, por qué no cuando no se puede, su grupo de concurrencia y si su workflow se puede lanzar a mano.
Un merge desde el tablero está protegido, no se da por bueno. El servidor vuelve a leer el pull request en el momento de pulsar, nunca fusiona con una comprobación en rojo ni con un borrador, siempre fusiona con un commit de merge y pide escribir el nombre completo del repositorio antes de cualquier cosa que despliegue en producción. Para un estudio que entrega varios productos en una semana, esa es la diferencia entre saber qué hará un merge y descubrirlo después. El día de las capturas el tablero tenía dos pull requests pendientes y trece terminados, cada tarjeta terminada con la imagen que desplegó.
Copias de seguridad que se reportan cada noche
Cada base de datos del clúster se vuelca cada noche, con un cuarto de hora de separación para que no empiecen dos a la vez, y cada volcado escribe a su lado el número de filas de cada tabla, que es lo que comprueba una prueba de restauración cuando restaura una copia en un namespace desechable. El archivo propio de la consola, el único almacén que nada más podría reconstruir, se copia con la copia de seguridad en línea de SQLite y se verifican su integridad y su número de filas antes de conservarlo. Tras una ejecución verificada, cada tarea avisa a un interruptor de hombre muerto fuera de casa, así que una tarea que falla, se cuelga o deja de programarse se detecta a la mañana siguiente y no el día en que hace falta restaurar.
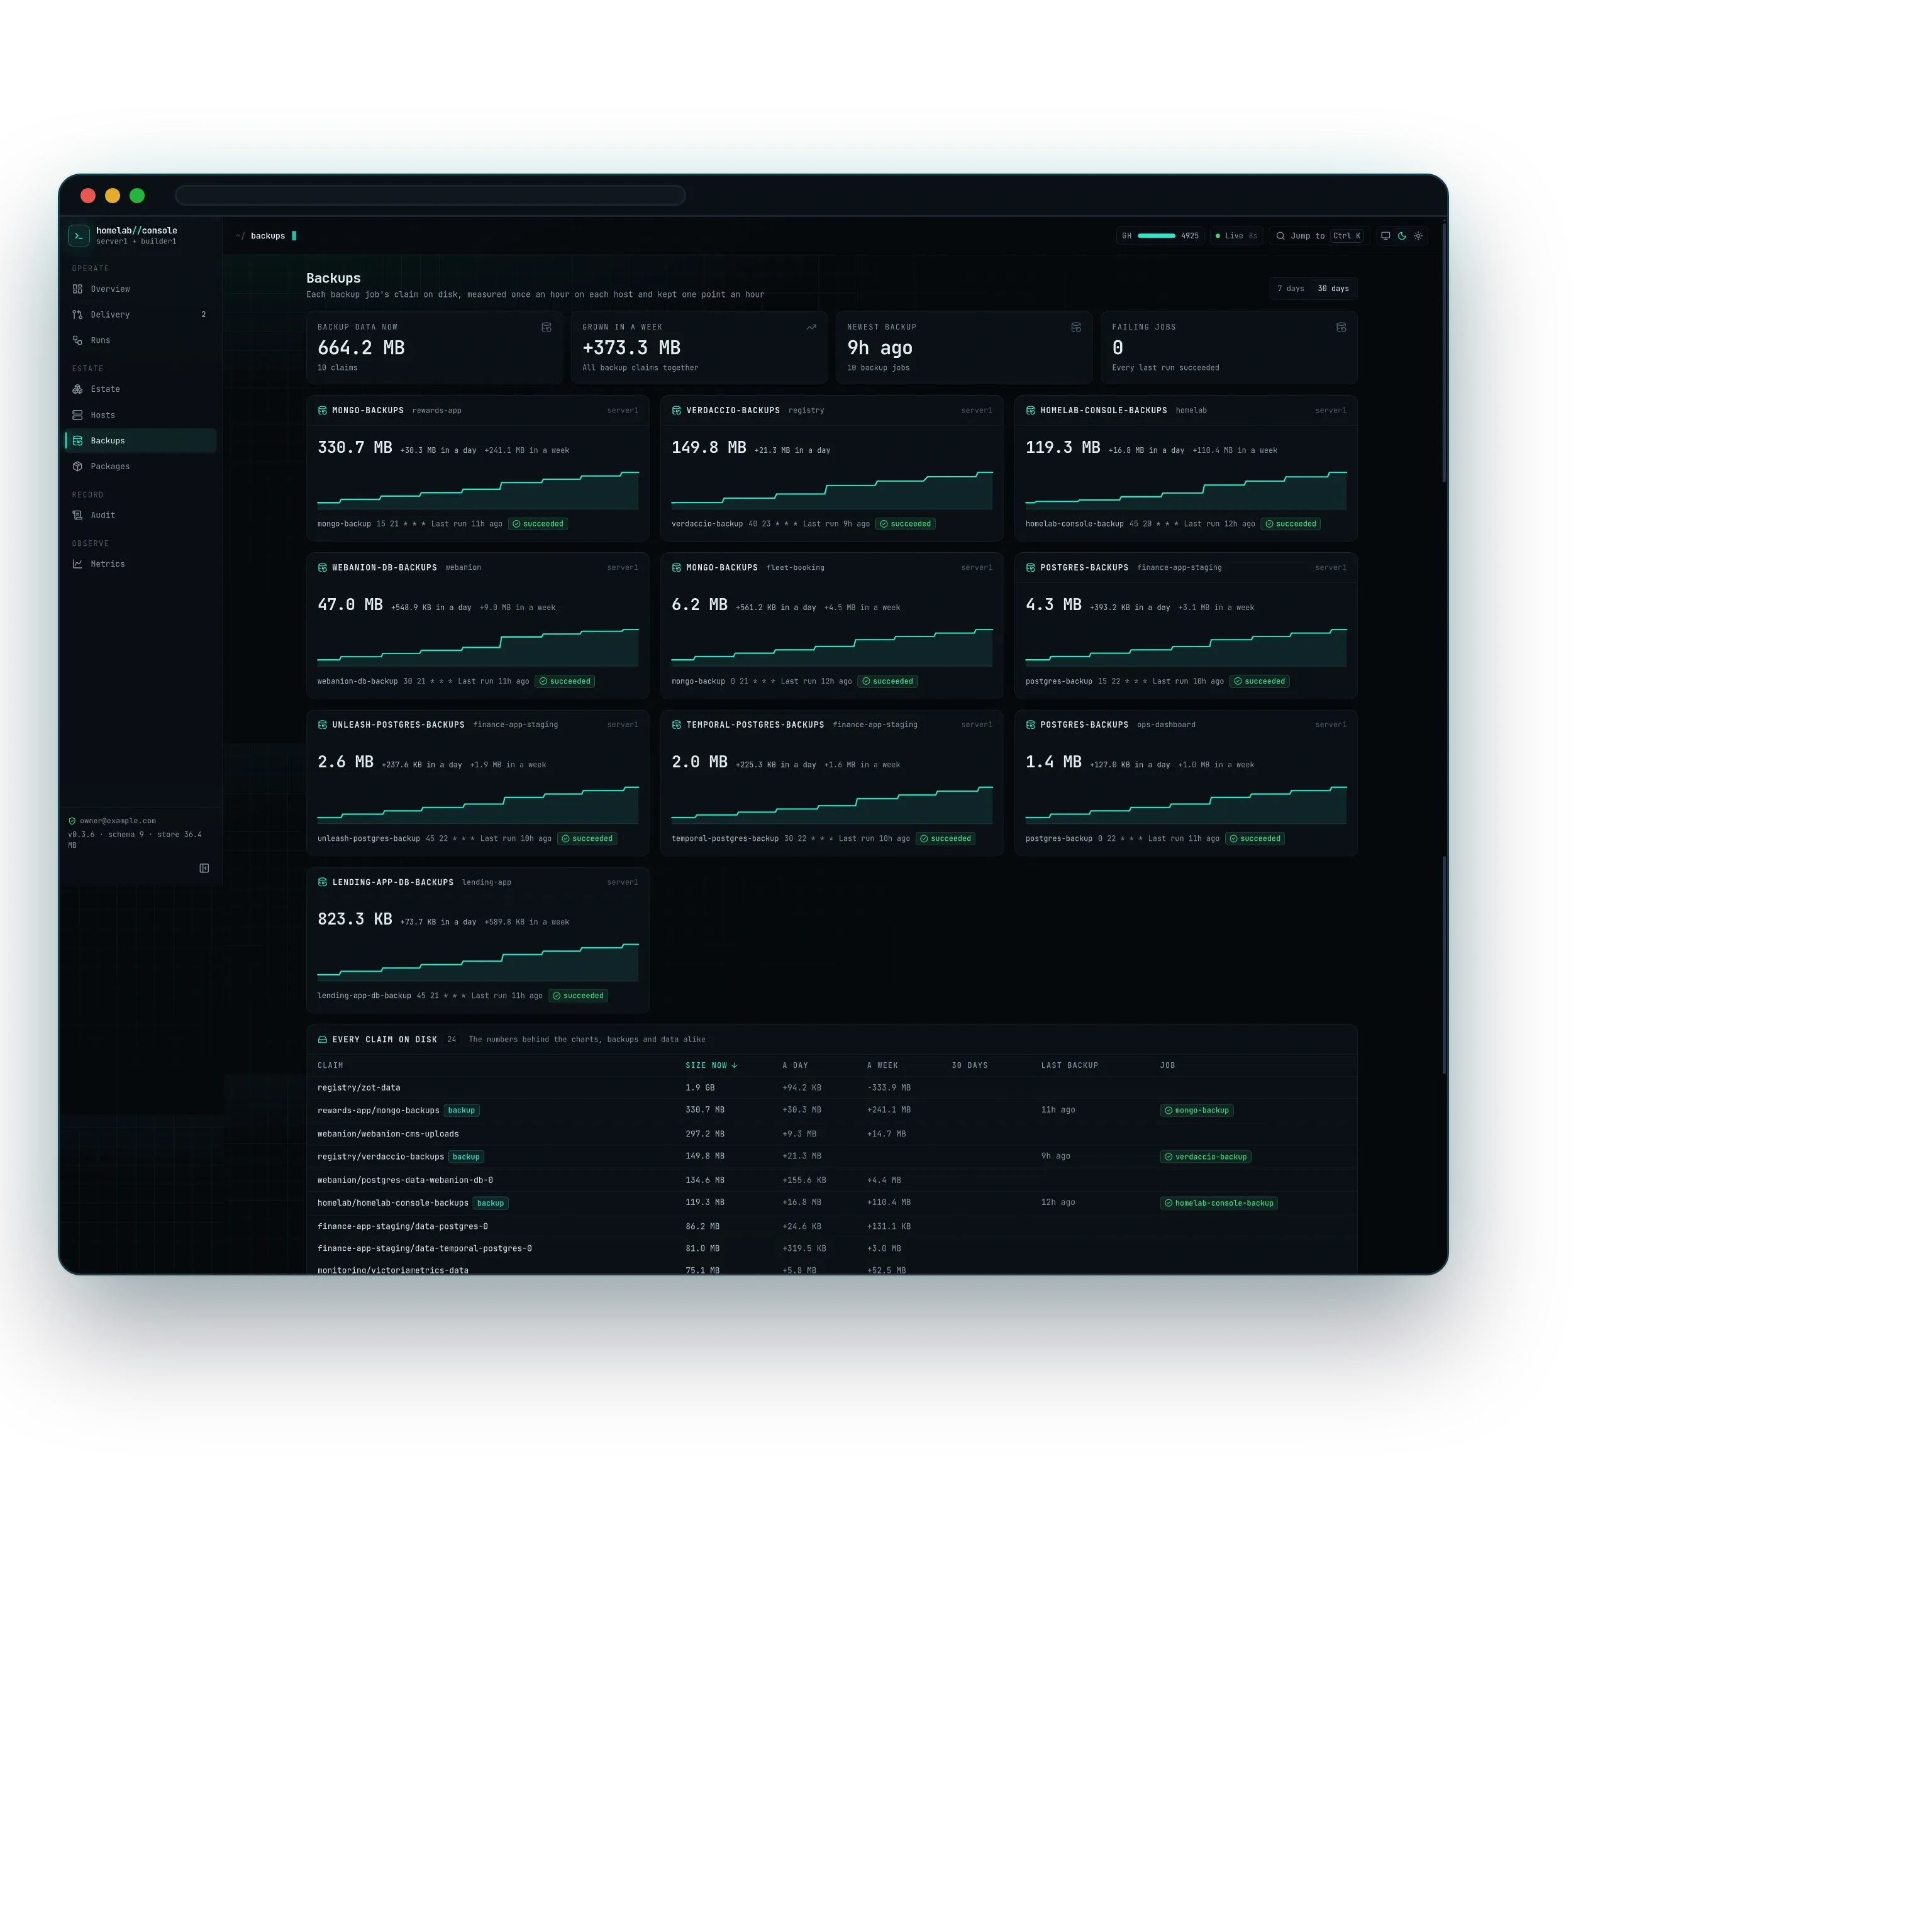
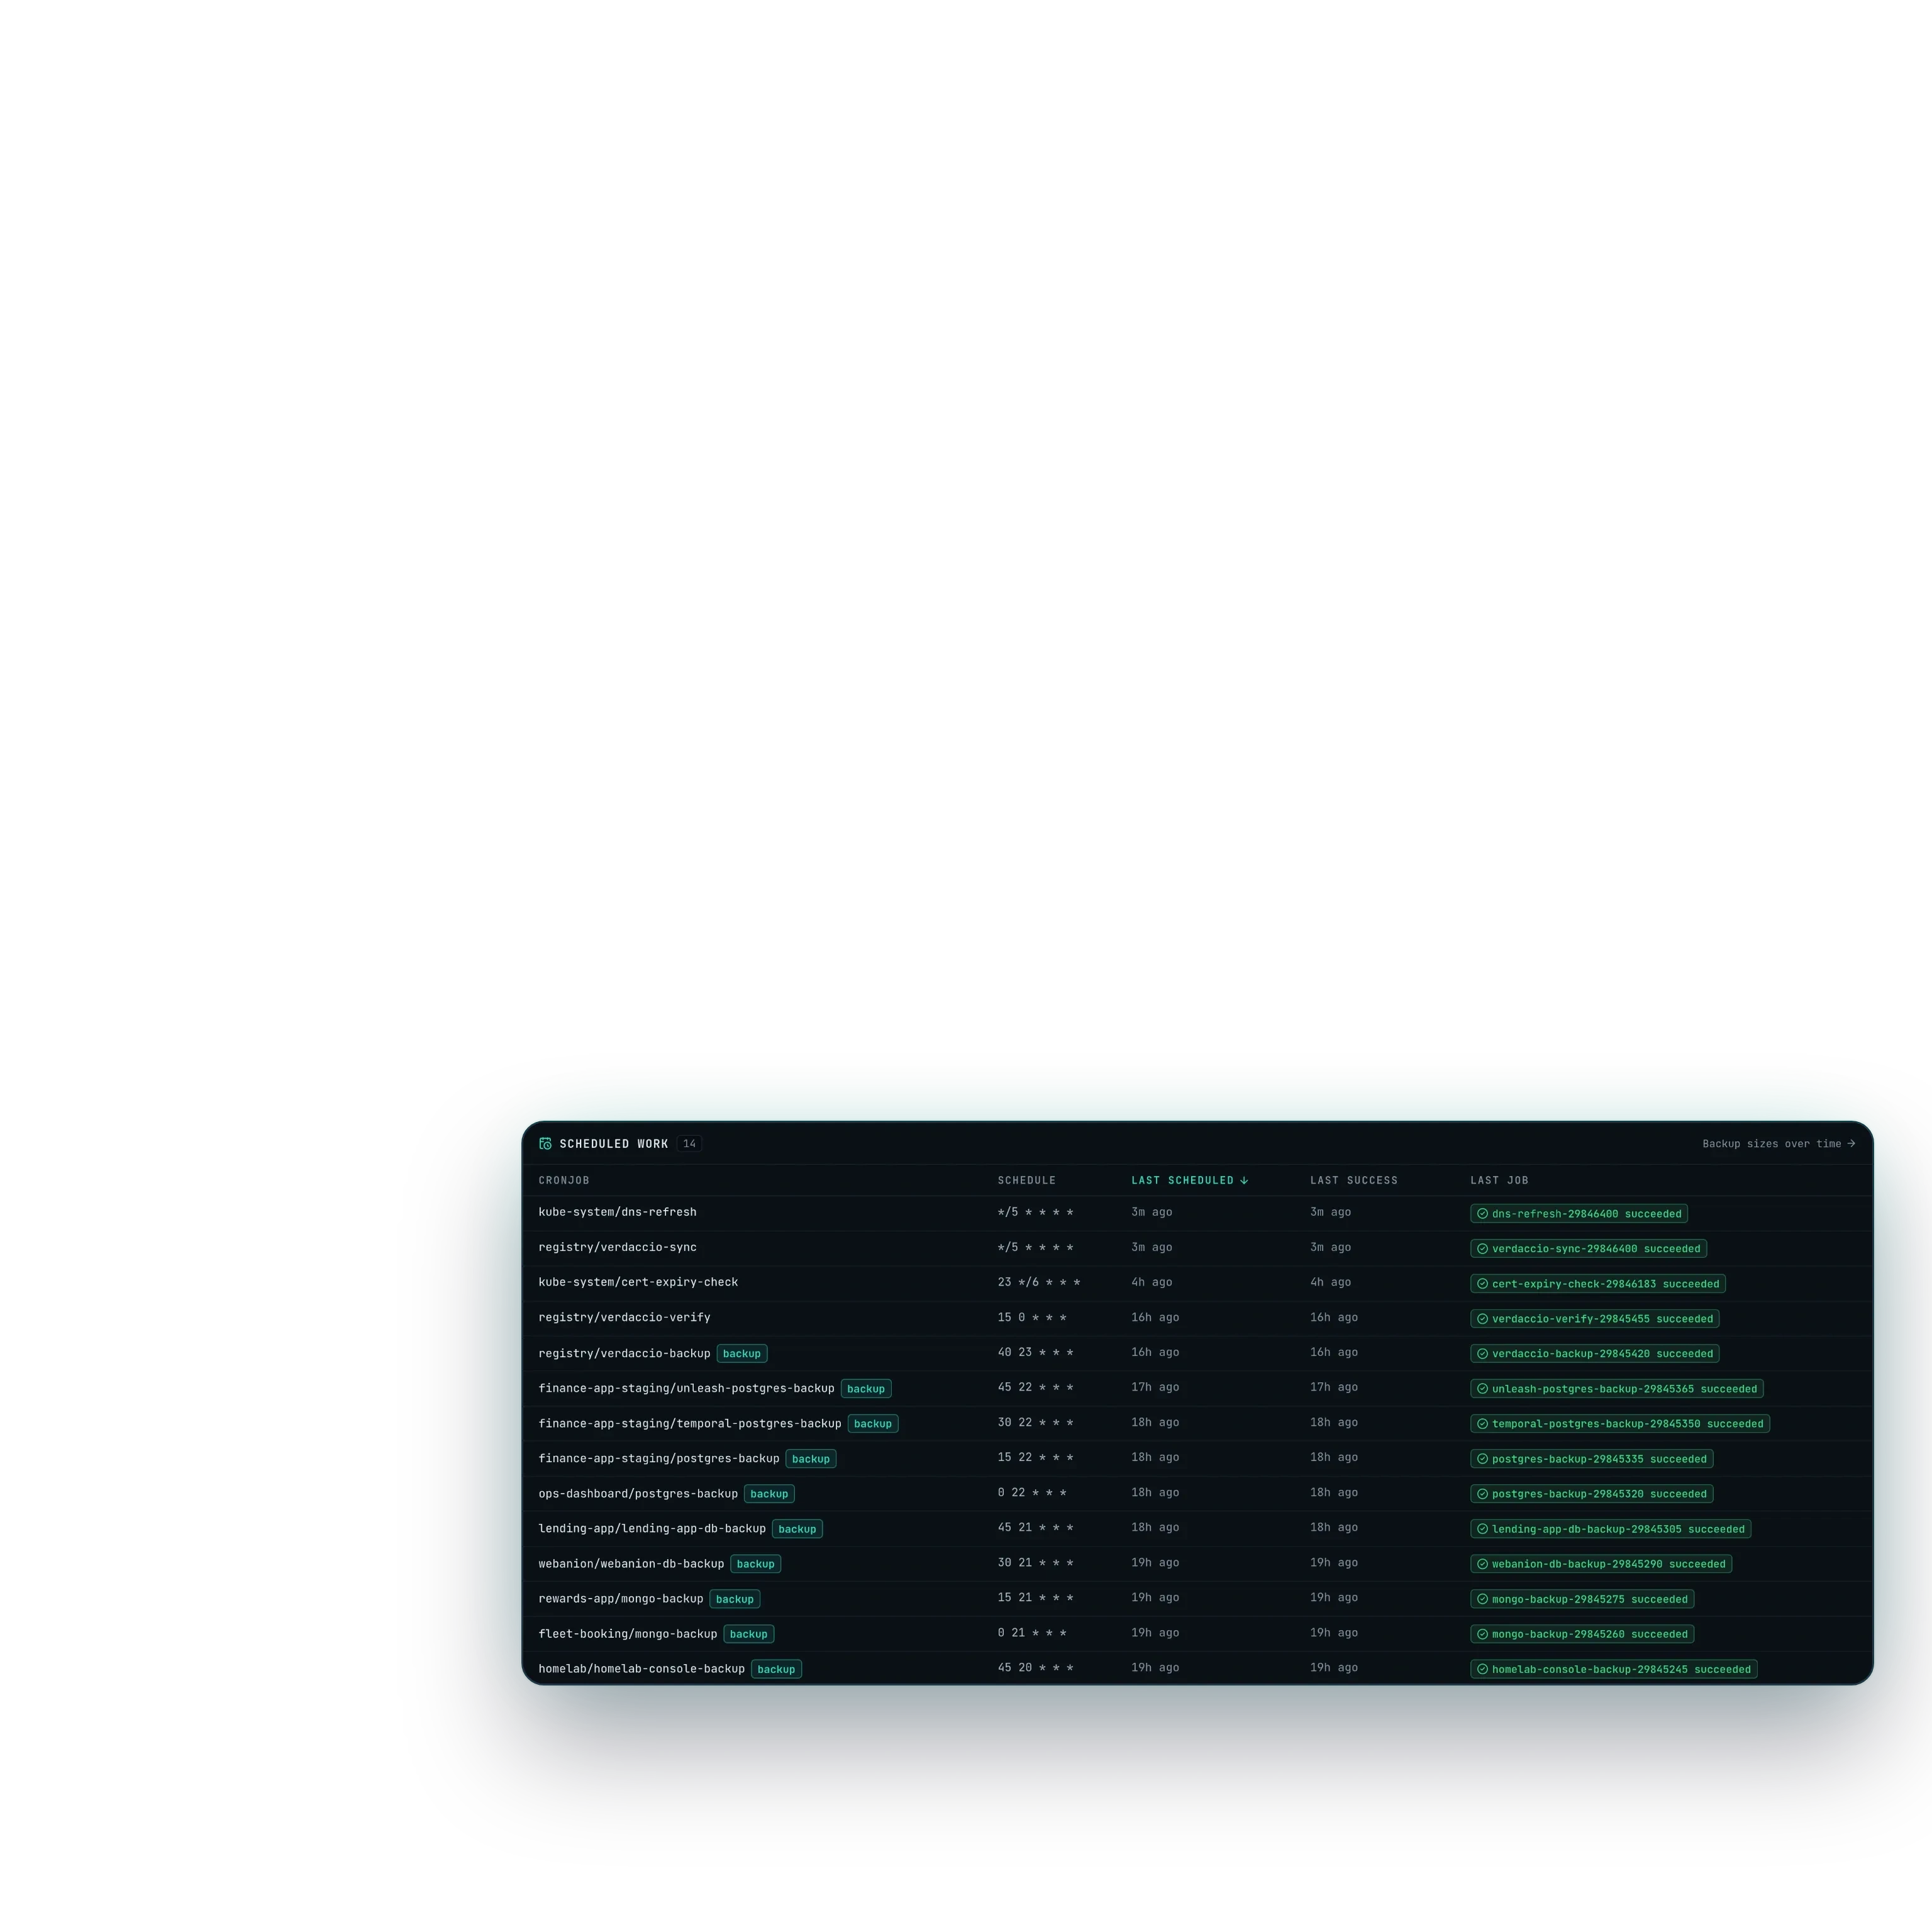
La vista Backups dibuja el crecimiento de cada volumen a partir de mediciones cada hora. El día de las capturas mostraba 664,2 MB de datos de copia repartidos en diez volúmenes, diez tareas de copia, la más reciente de hace nueve horas y ninguna fallida, y la pestaña Schedules listaba las catorce tareas programadas con su última ejecución correcta.
Los hosts, las métricas y una alarma fuera de casa
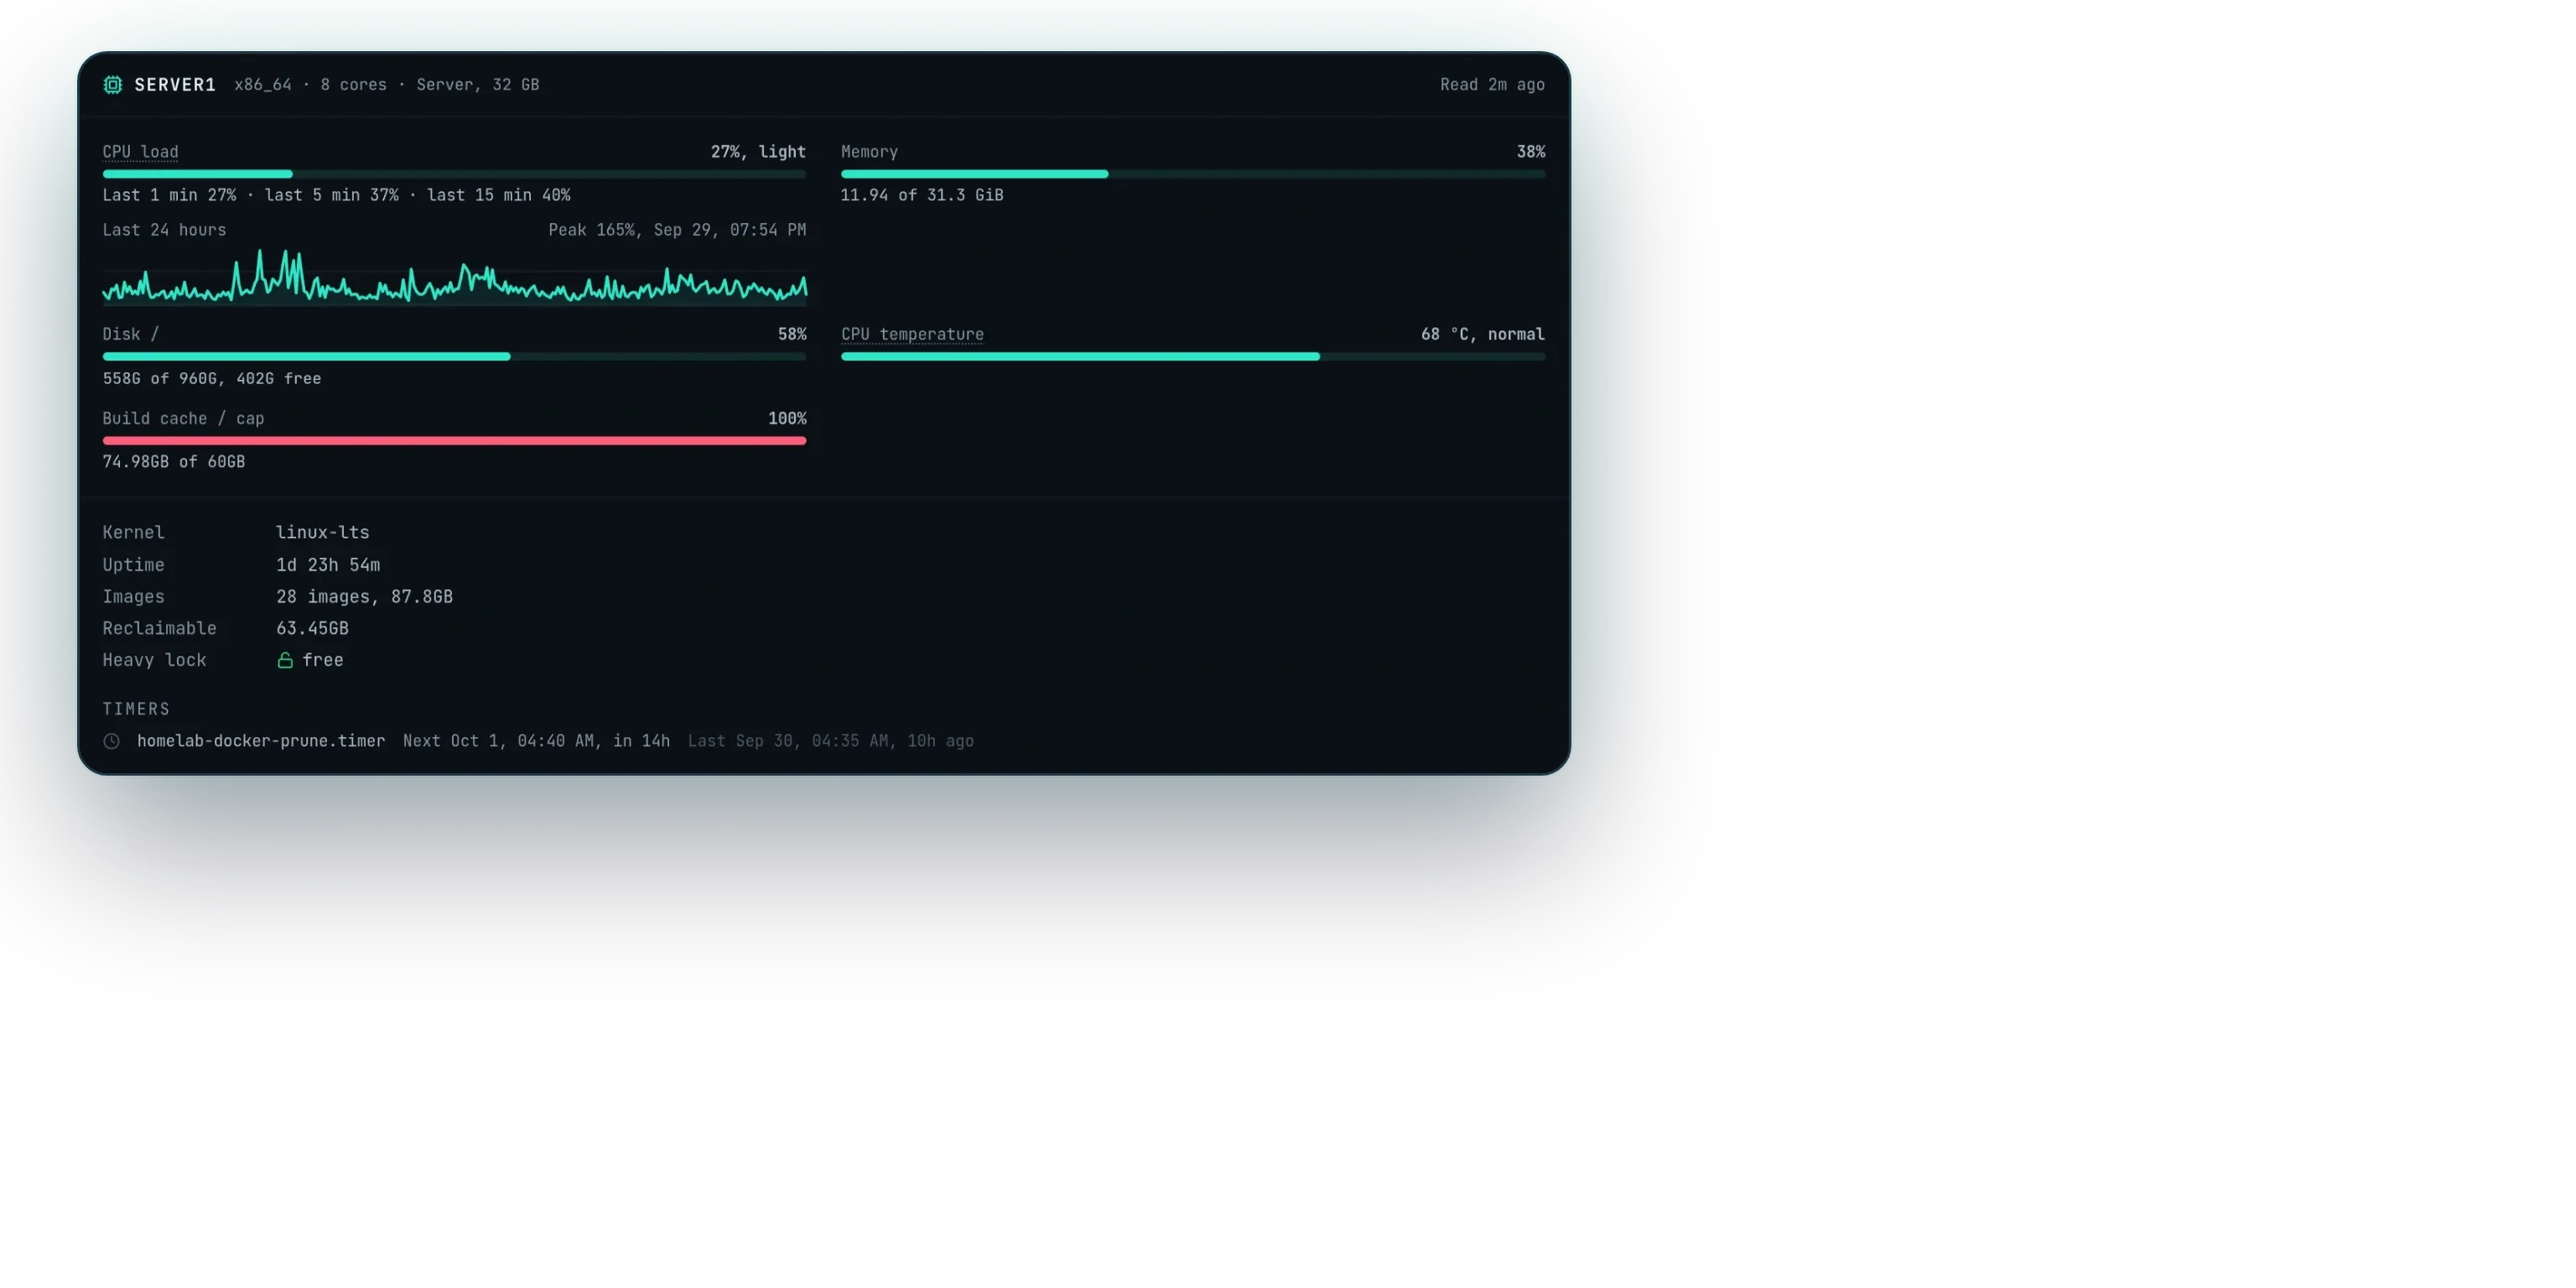
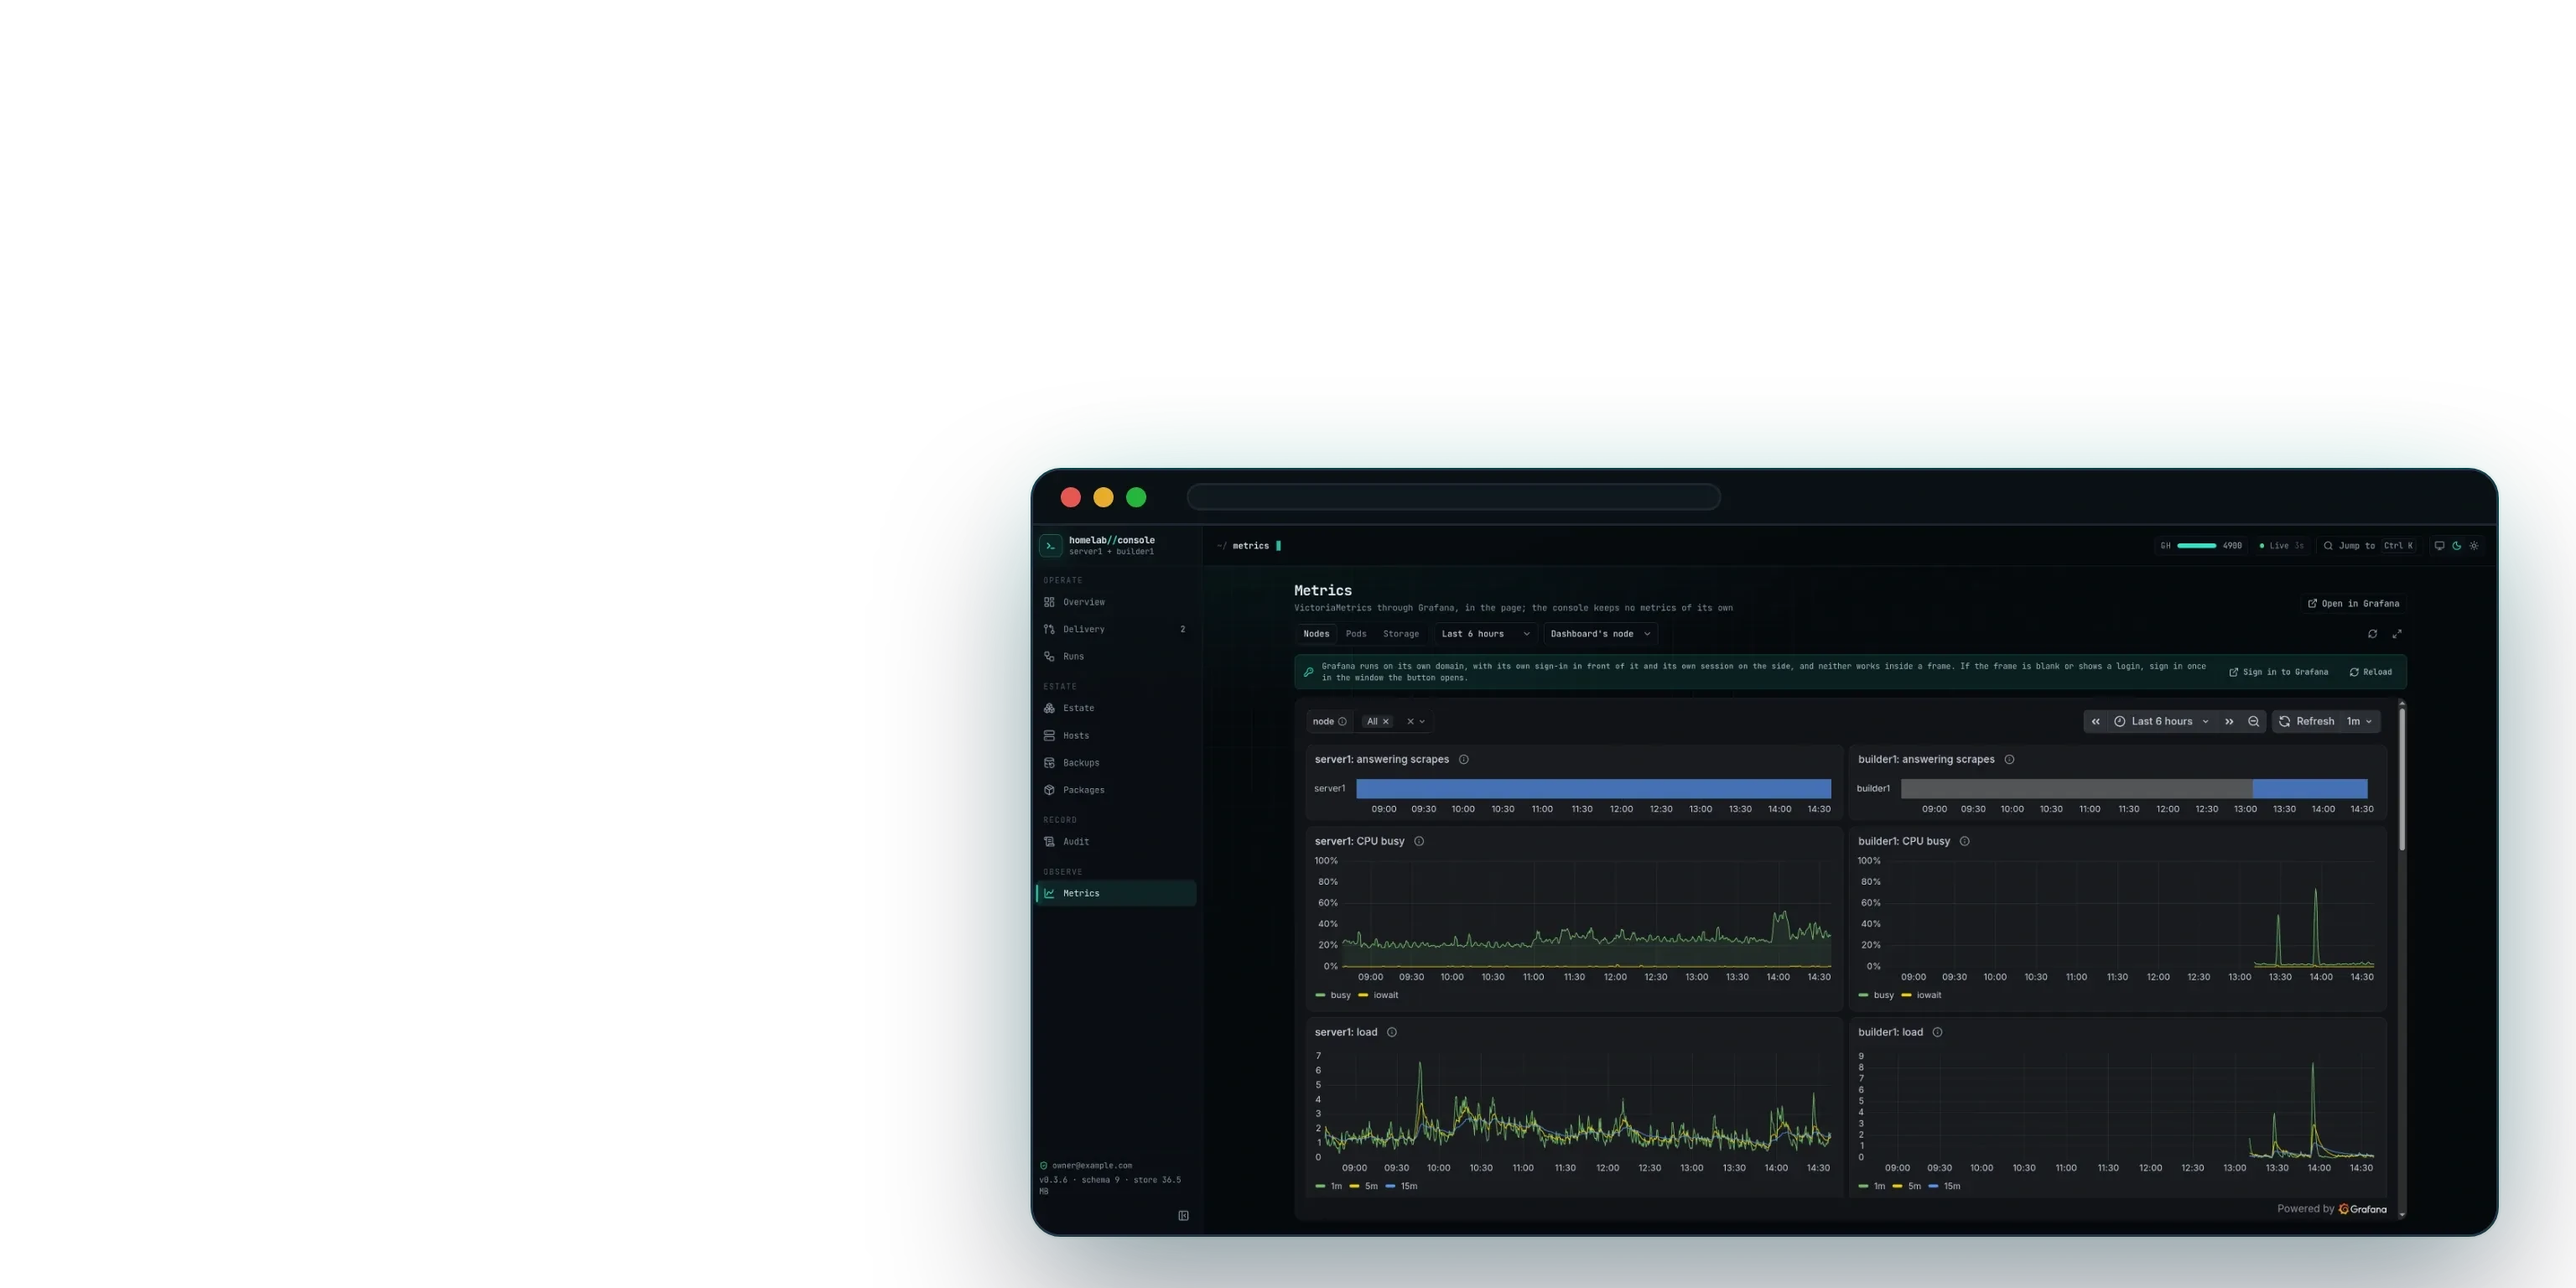
Cada host informa de carga, memoria, disco, temperatura y caché de compilación cada cinco minutos, y las métricas se consultan con Grafana dentro de la página. Las reglas de alerta del clúster llegan a un teléfono, una comprobación horaria señala los manifiestos fusionados que nadie aplicó y un monitor de caídas en el borde de Cloudflare revisa cada sitio público cada minuto, porque un monitor dentro del clúster no puede avisar de su propia caída.
Cada servicio, en un solo mapa
Lo que ofrece el homelab, dibujado por función y no por máquina: los túneles y el router en el borde, el clúster, las bases de datos y sus volúmenes, los registros de contenedores y de npm, el pool de runners, las copias nocturnas y sus interruptores, el almacén de métricas y sus alertas, el monitor de caídas fuera de casa y la consola que lo lee todo.

Cada acción queda escrita, también las rechazadas
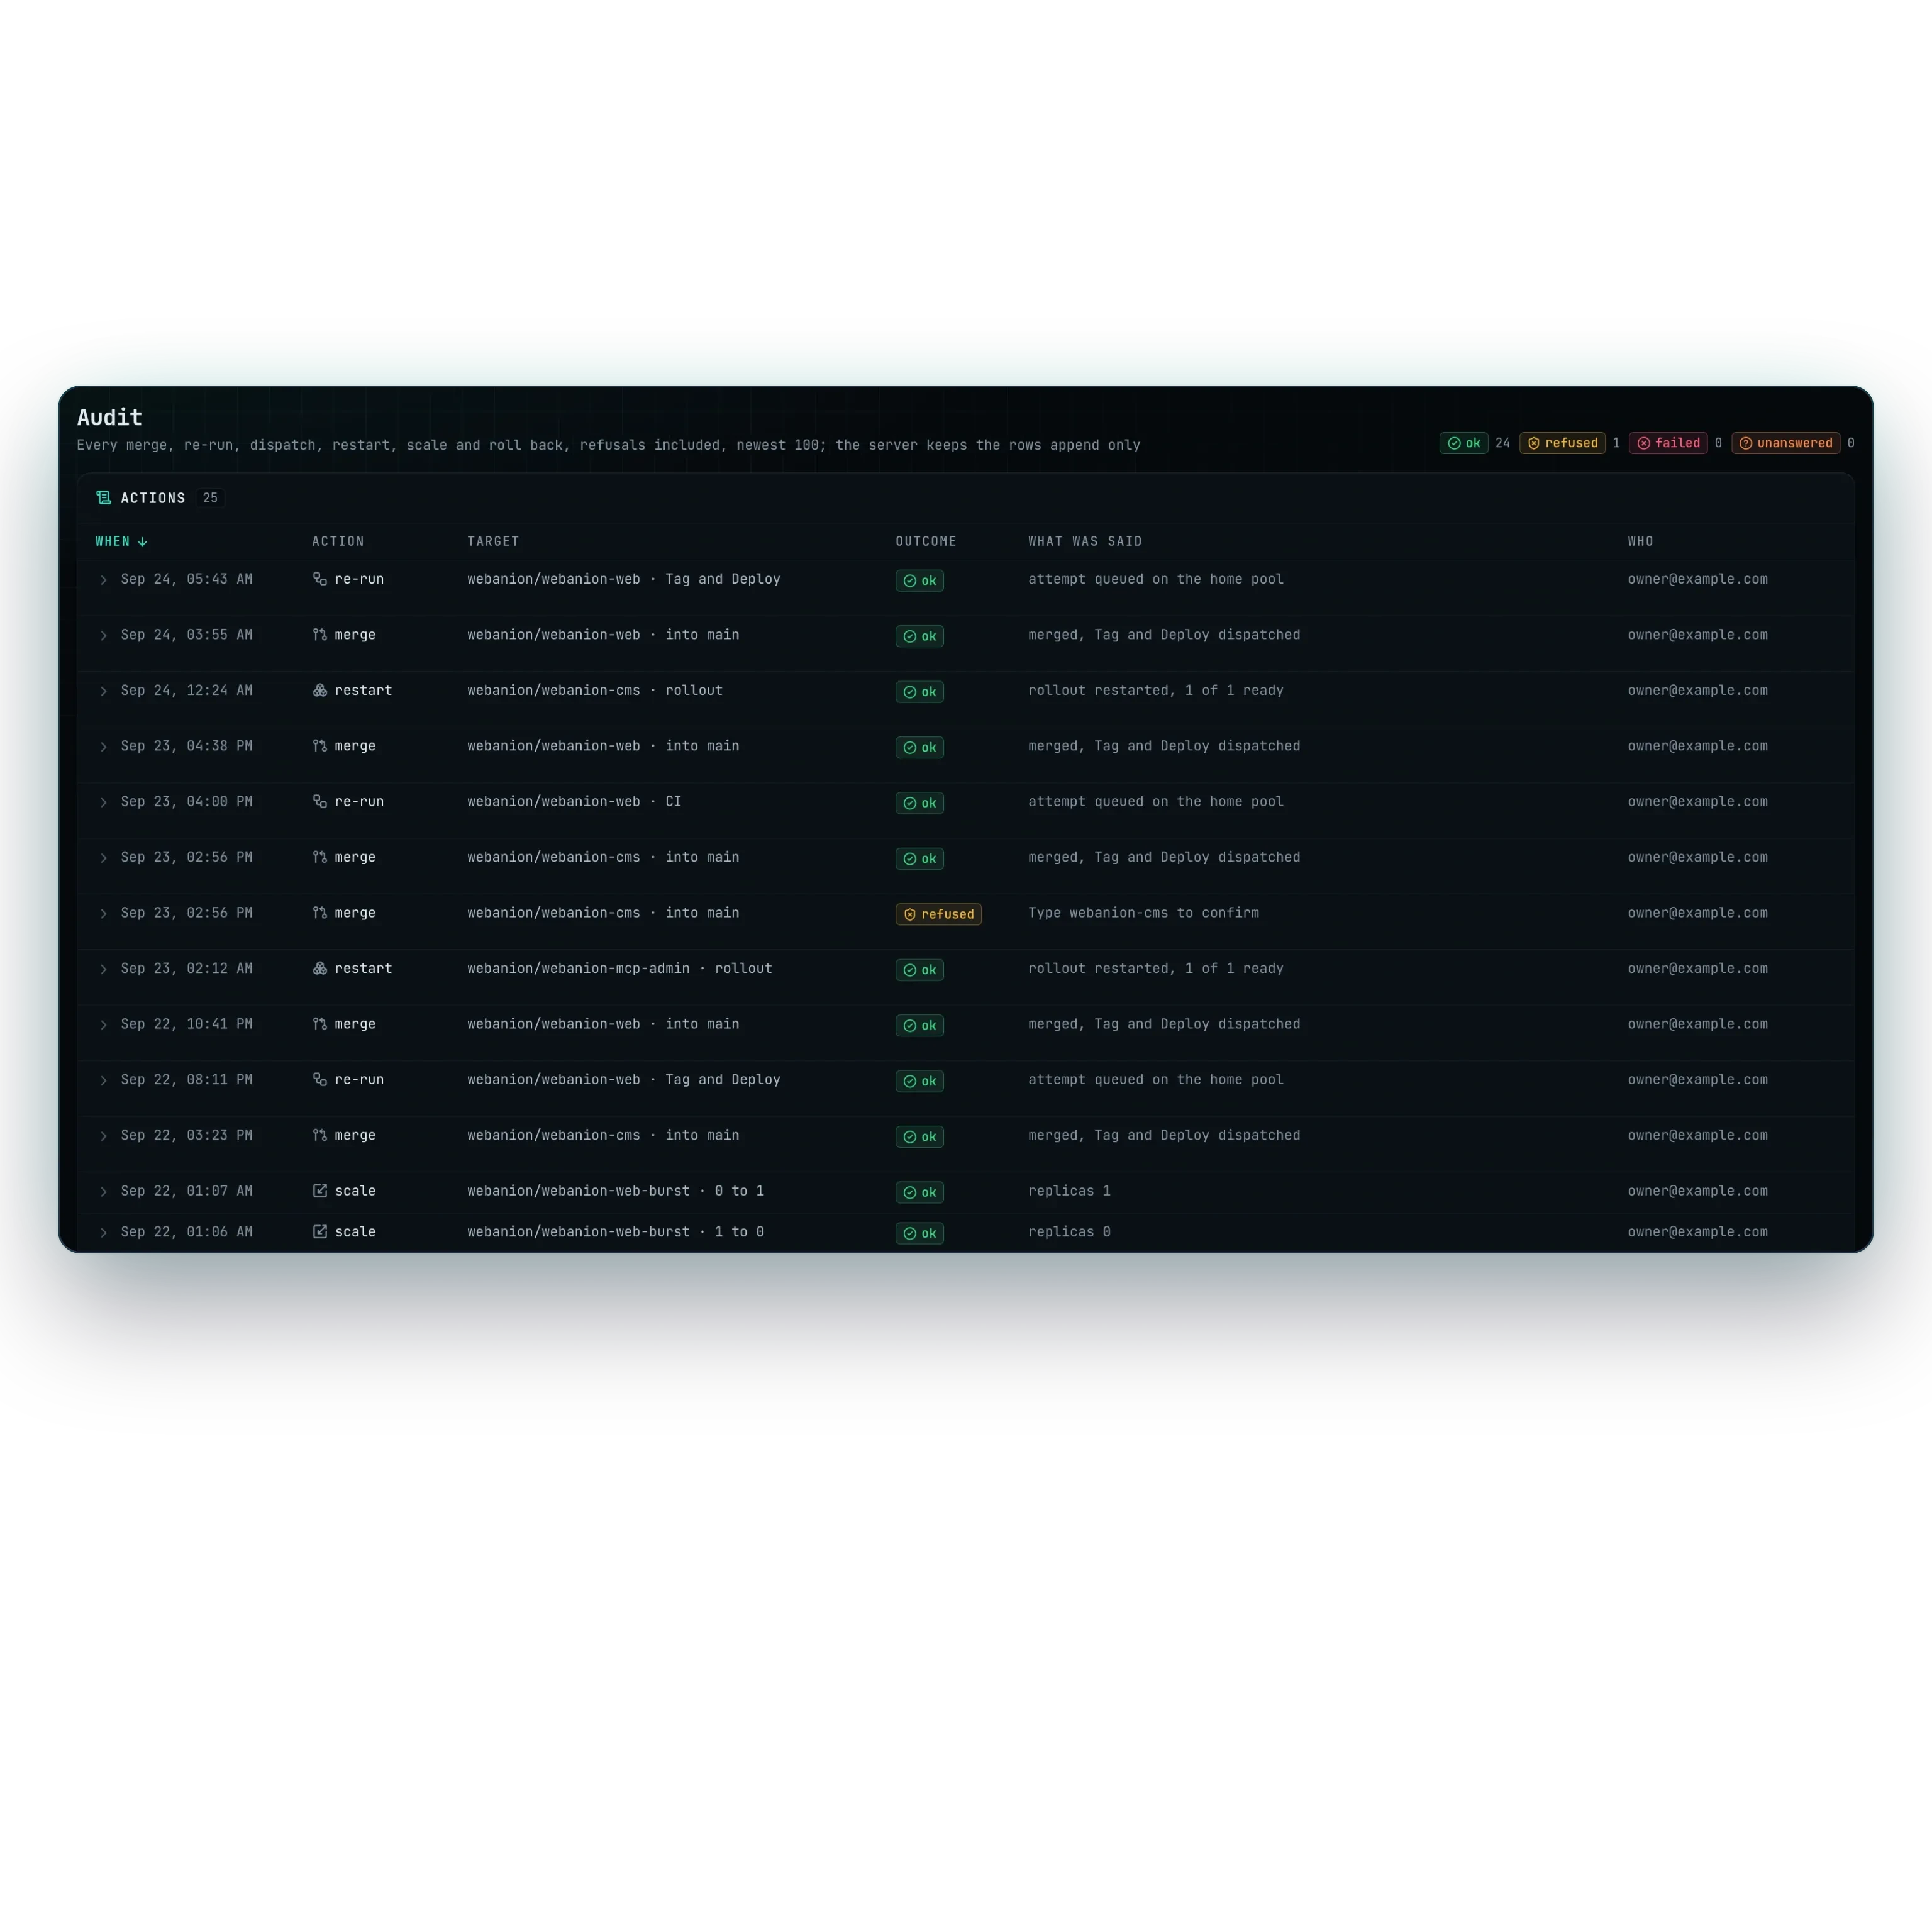
La consola hace algo más que leer. Merges, reejecuciones, lanzamientos de workflows, reinicios, subir o bajar una segunda copia y reversiones se pulsan desde la página, y cada una se escribe a través de una segunda identidad cuyos permisos nombran cada objeto que puede tocar, con un token pedido para esa sola acción y descartado después. Antes de que ocurra nada, la consola vuelve a leer el estado real y enumera cada condición previa como superada, advertencia o rechazo, y todo lo que despliega en producción pide escribir su nombre para confirmar.
Cada pulsación se convierte en una fila que solo se añade y nunca se modifica: cuándo, la acción, el objetivo, el resultado y lo que se dijo, rechazos incluidos, de modo que el registro de una acción rechazada es tan completo como el de una que salió adelante. El mismo archivo guarda lo que GitHub borra: cada ejecución se archiva al terminar, con un año de registros completos y las filas para siempre, más allá de la retención predeterminada de noventa días de GitHub.
Mantenido cada día, y lo que eso vale
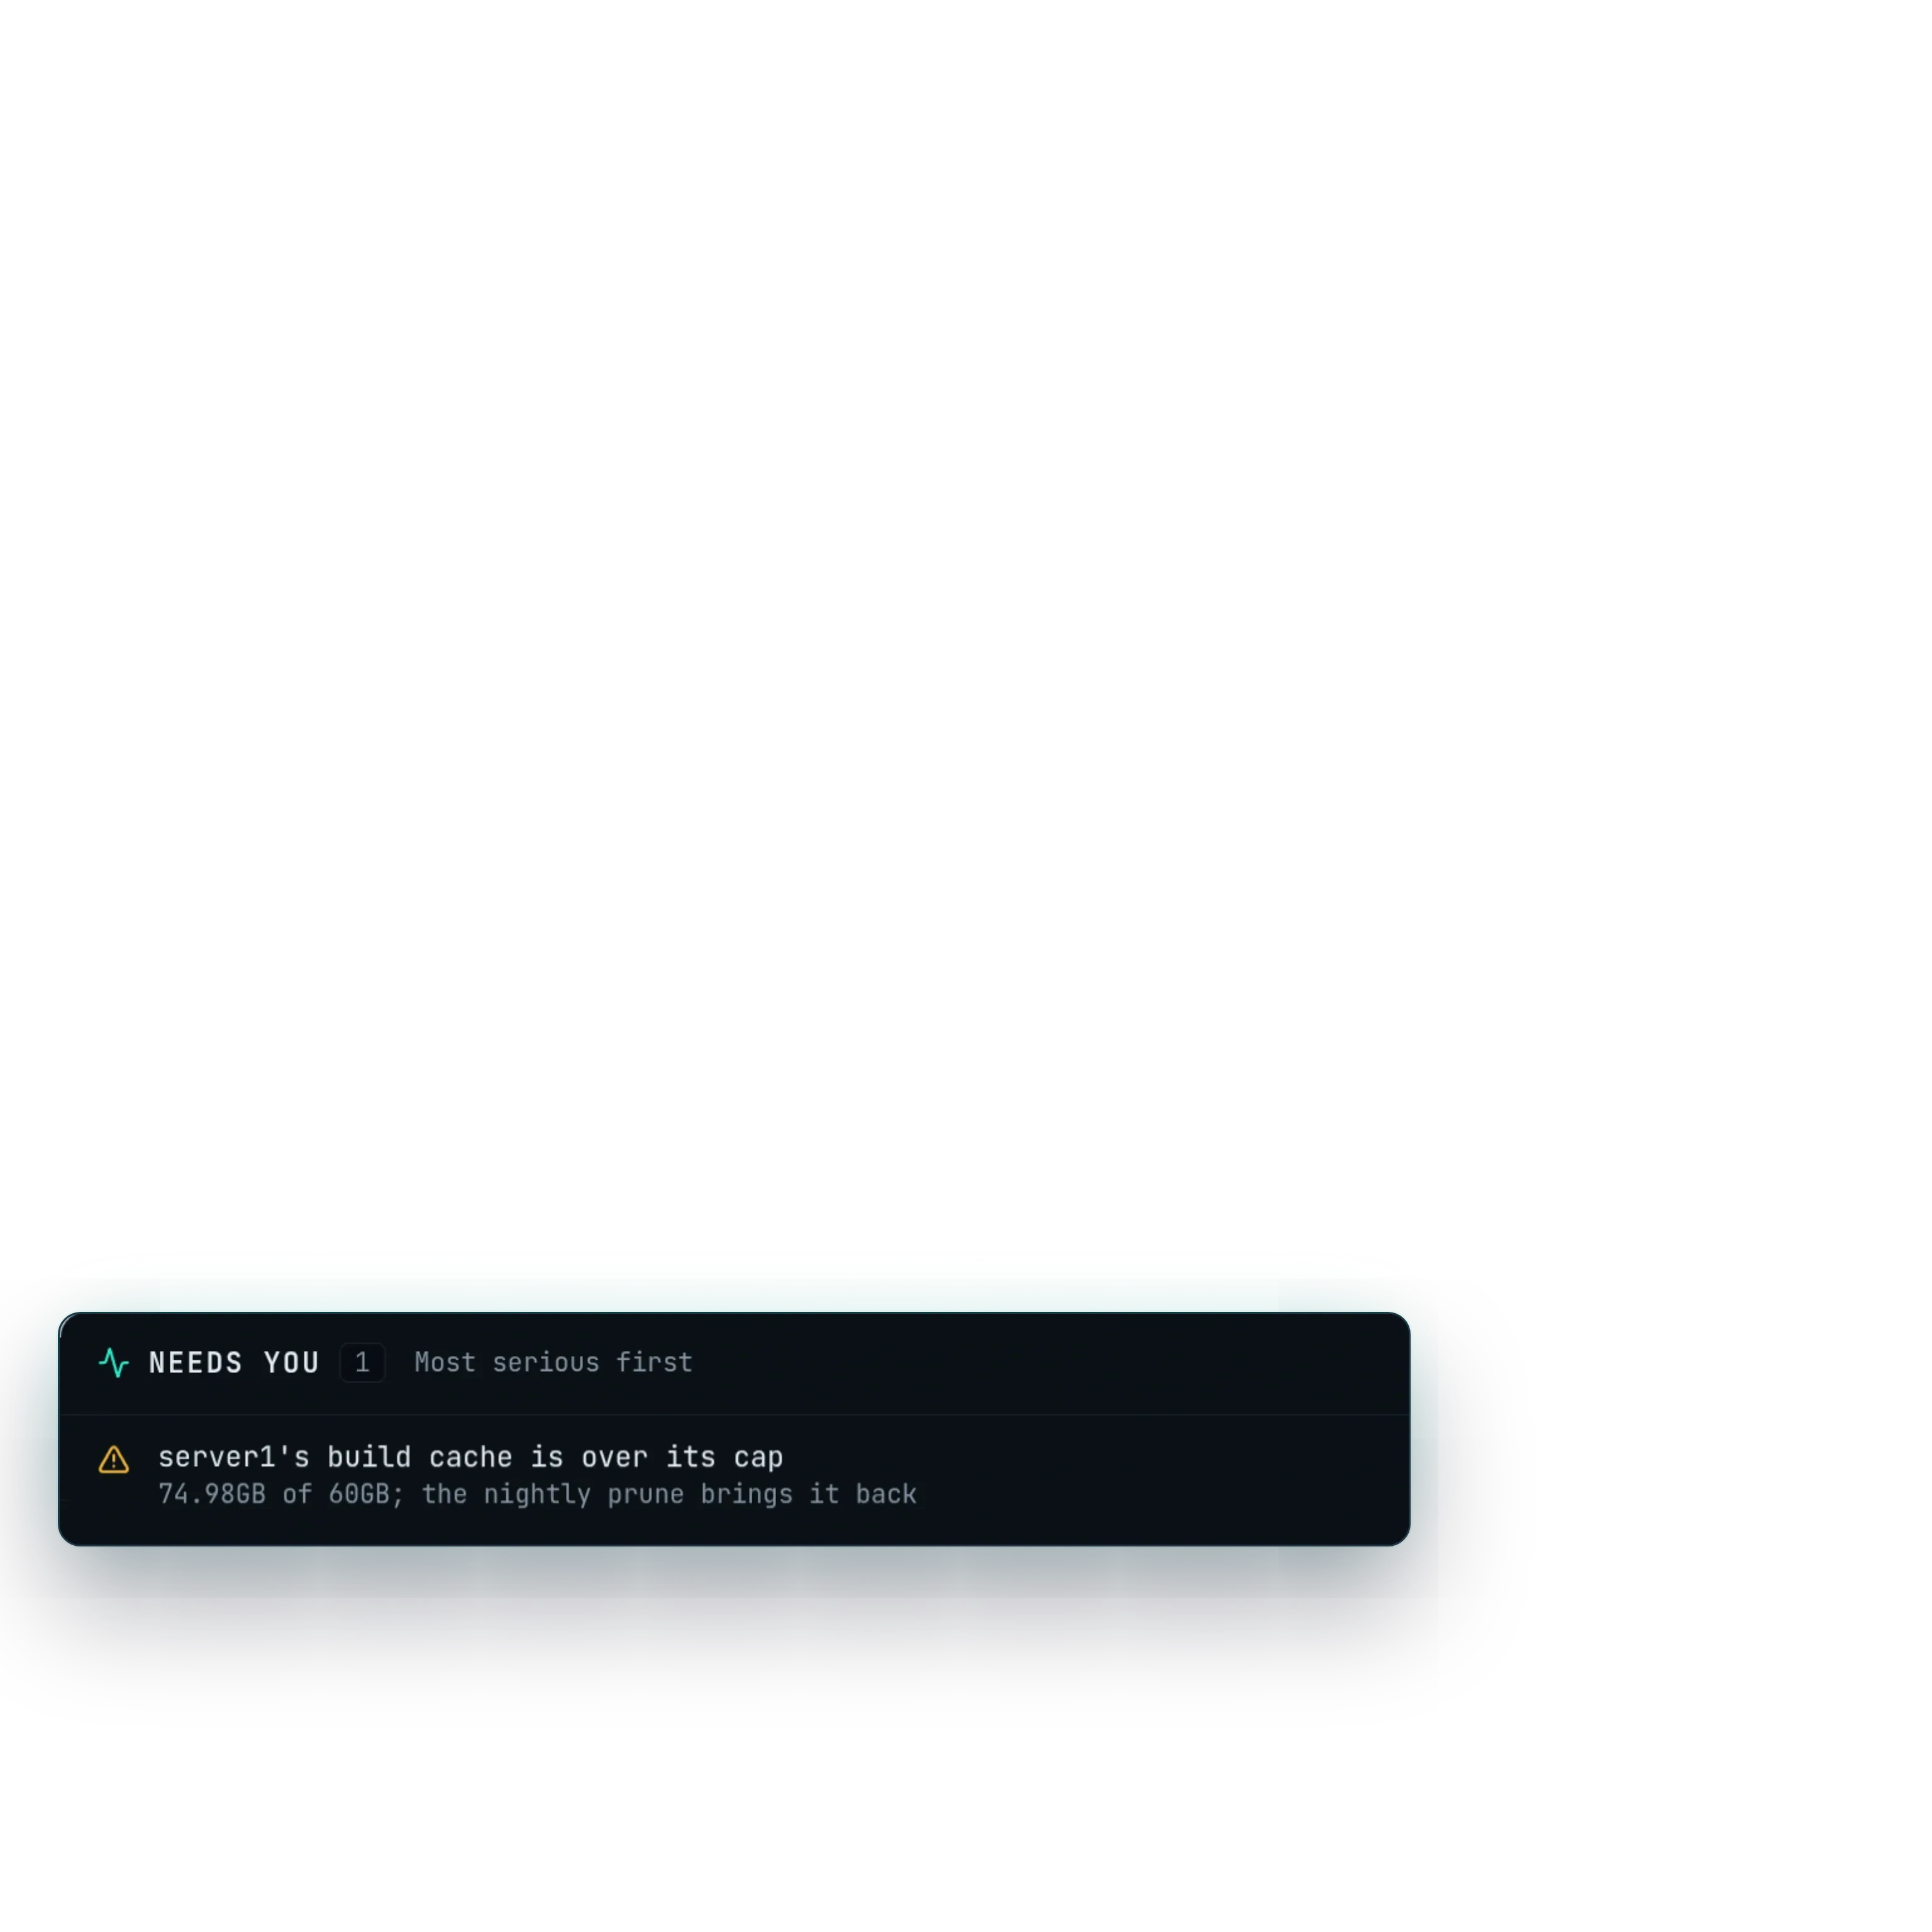
La rutina diaria es corta porque las herramientas cargan con casi todo: la lista de la consola con lo que necesita una mano por la mañana, una comprobación de desviaciones cada hora que detecta un manifiesto fusionado que nadie aplicó, el teléfono para cualquier fallo de noche, interruptores de copias que se quedan en silencio mientras cada tarea se reporta y comprobaciones de certificados que avisan semanas antes de que uno caduque. El día de las capturas esa lista tenía un solo elemento, una caché de compilación por encima de su límite que la limpieza nocturna devuelve a su sitio, el tipo de pequeña desviación que cuesta poco arreglar en el día y mucho descubrir un mes después.
El coste honesto es que alguien tiene que hacerse cargo. Ser dueño de toda la infraestructura significa que los certificados, los discos y las actualizaciones son problema del estudio y no de un proveedor, y un equipo sin nadie que cuide su infraestructura hace mejor en alquilarla. Para un fundador o un equipo pequeño que quiere que su infraestructura sea algo que entiende y no un montón de facturas, y para un cliente que quiere pruebas de que la plataforma por la que paga se cuida cada día, así es como se ve en la práctica. La plataforma de Webanion funciona sobre ella, y las cosas que hizo posibles tienen su propia historia, entre ellas convertir un nodo en un clúster sin cambiar ninguna aplicación y pasar las compilaciones del CI alojado a un pool de runners en casa y a registros privados.
La alarma llega al teléfono, y la alarma también está vigilada
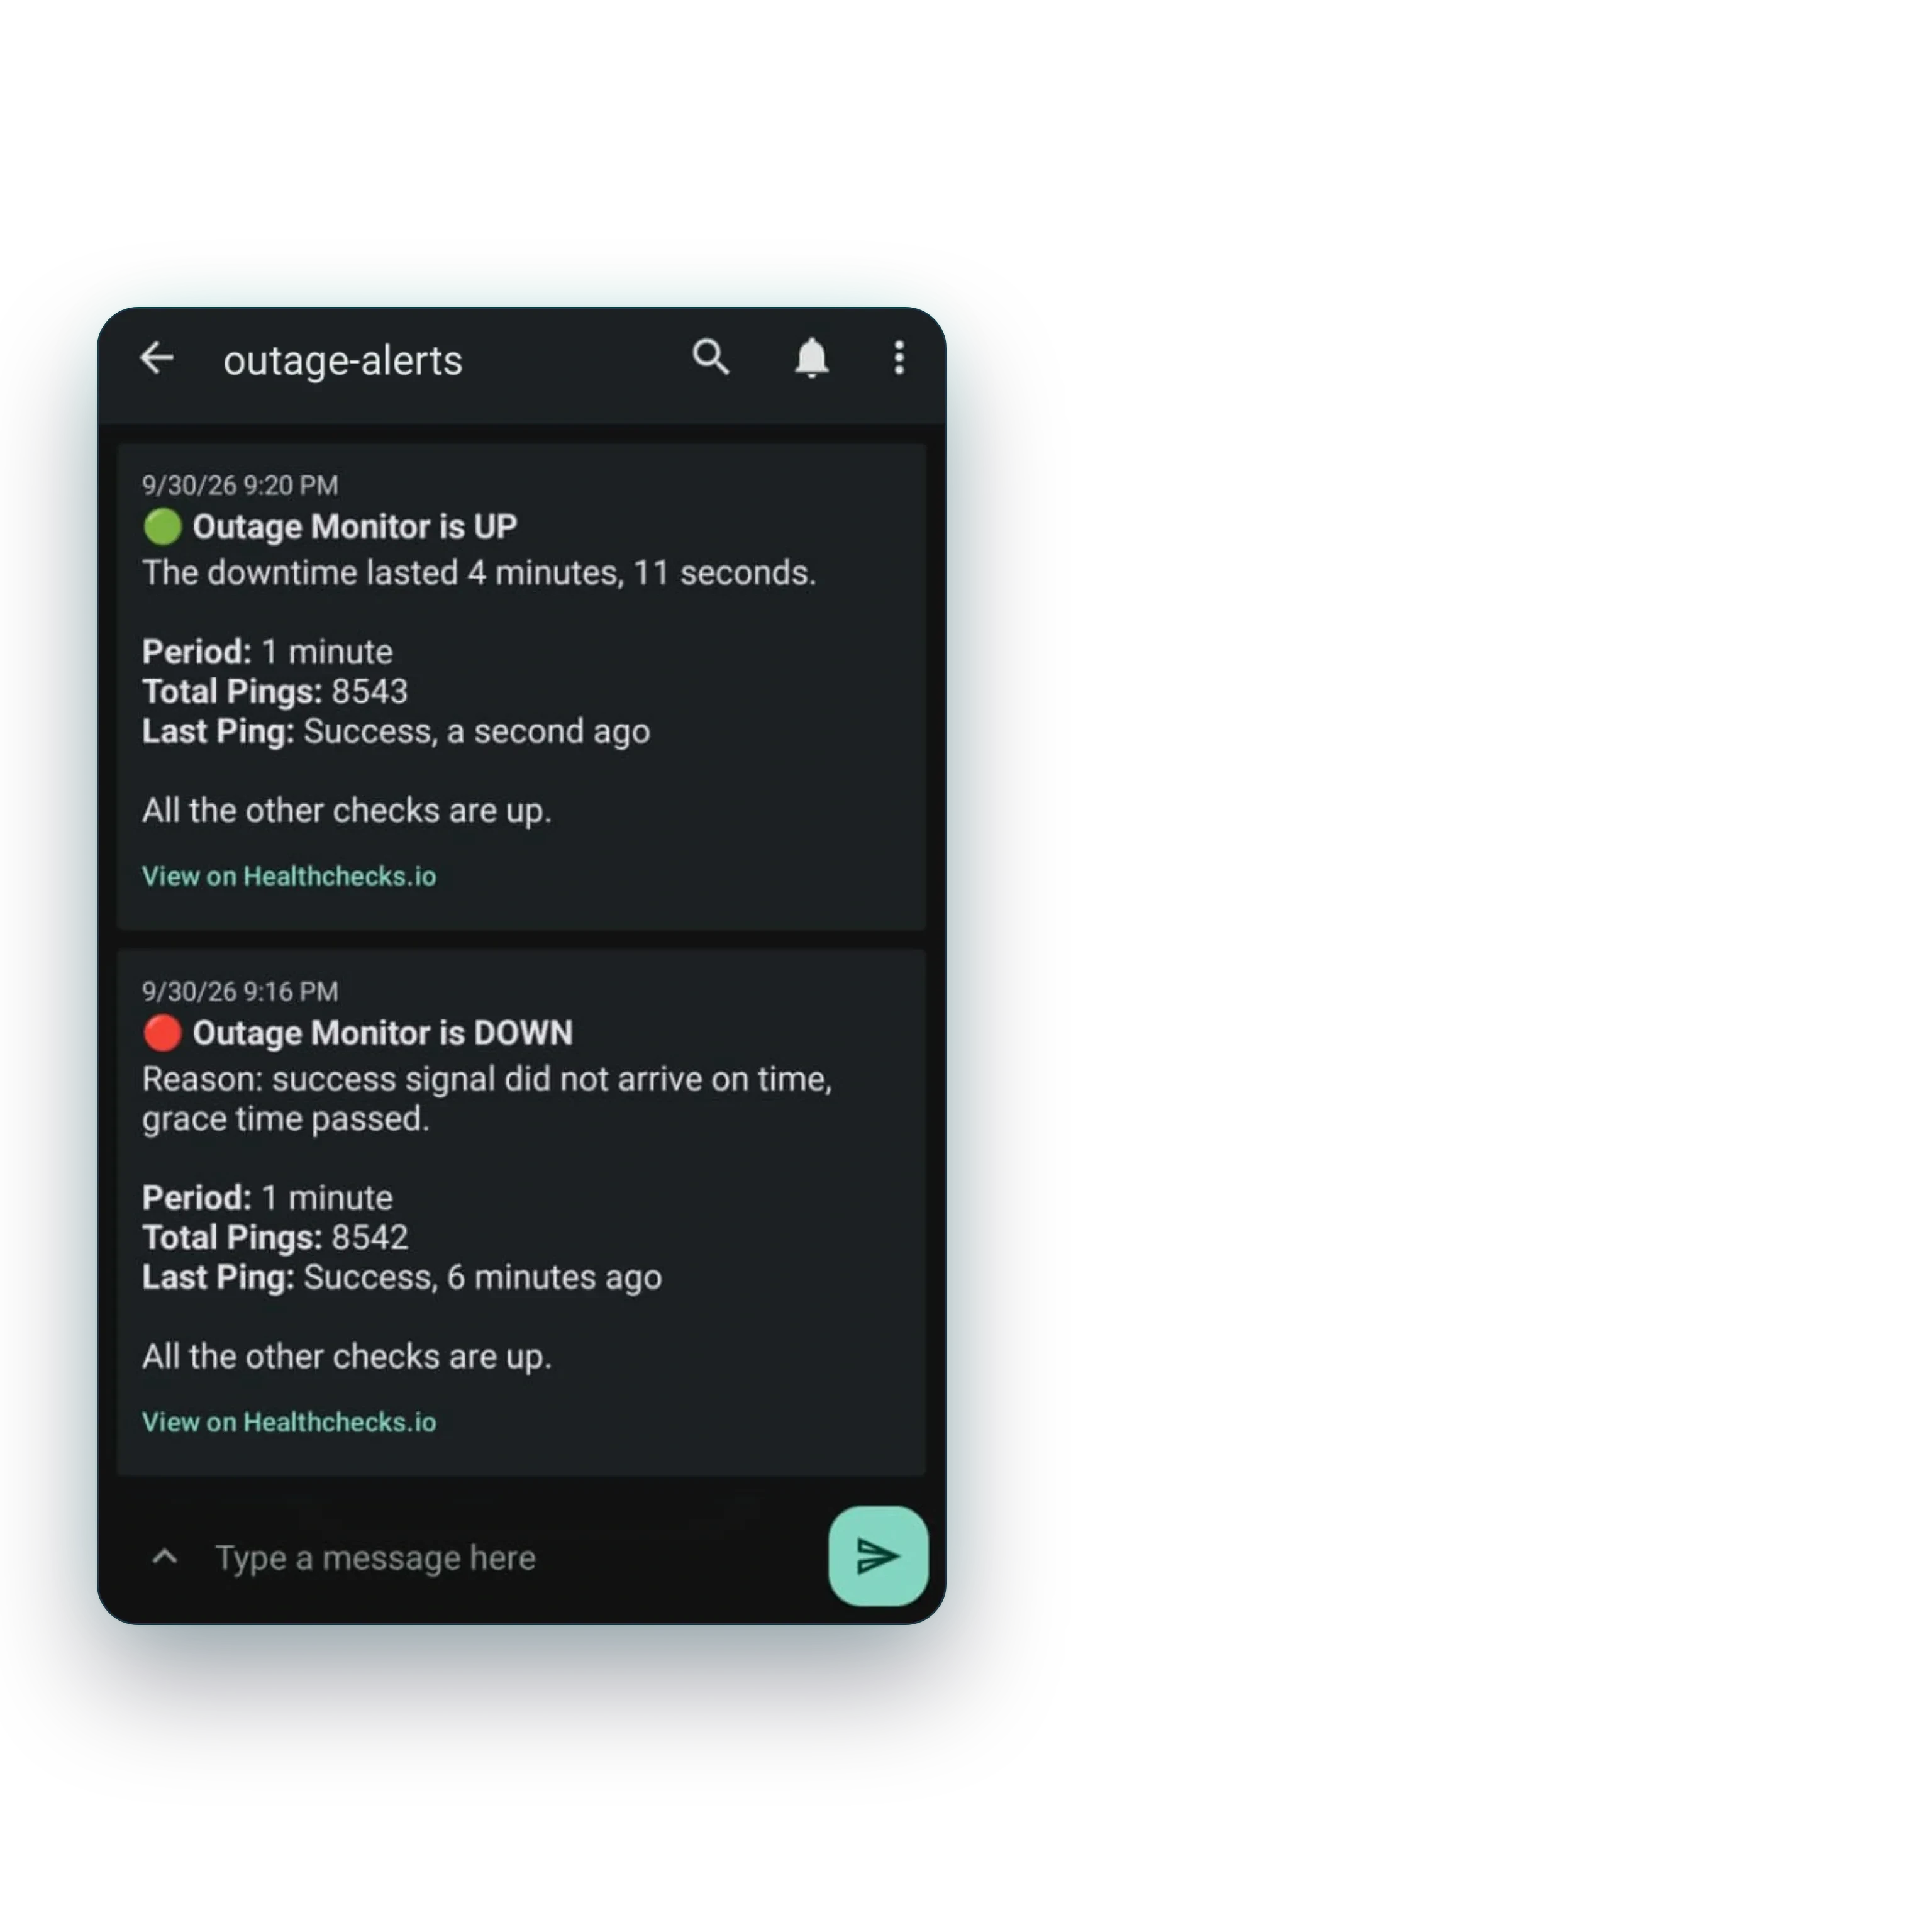
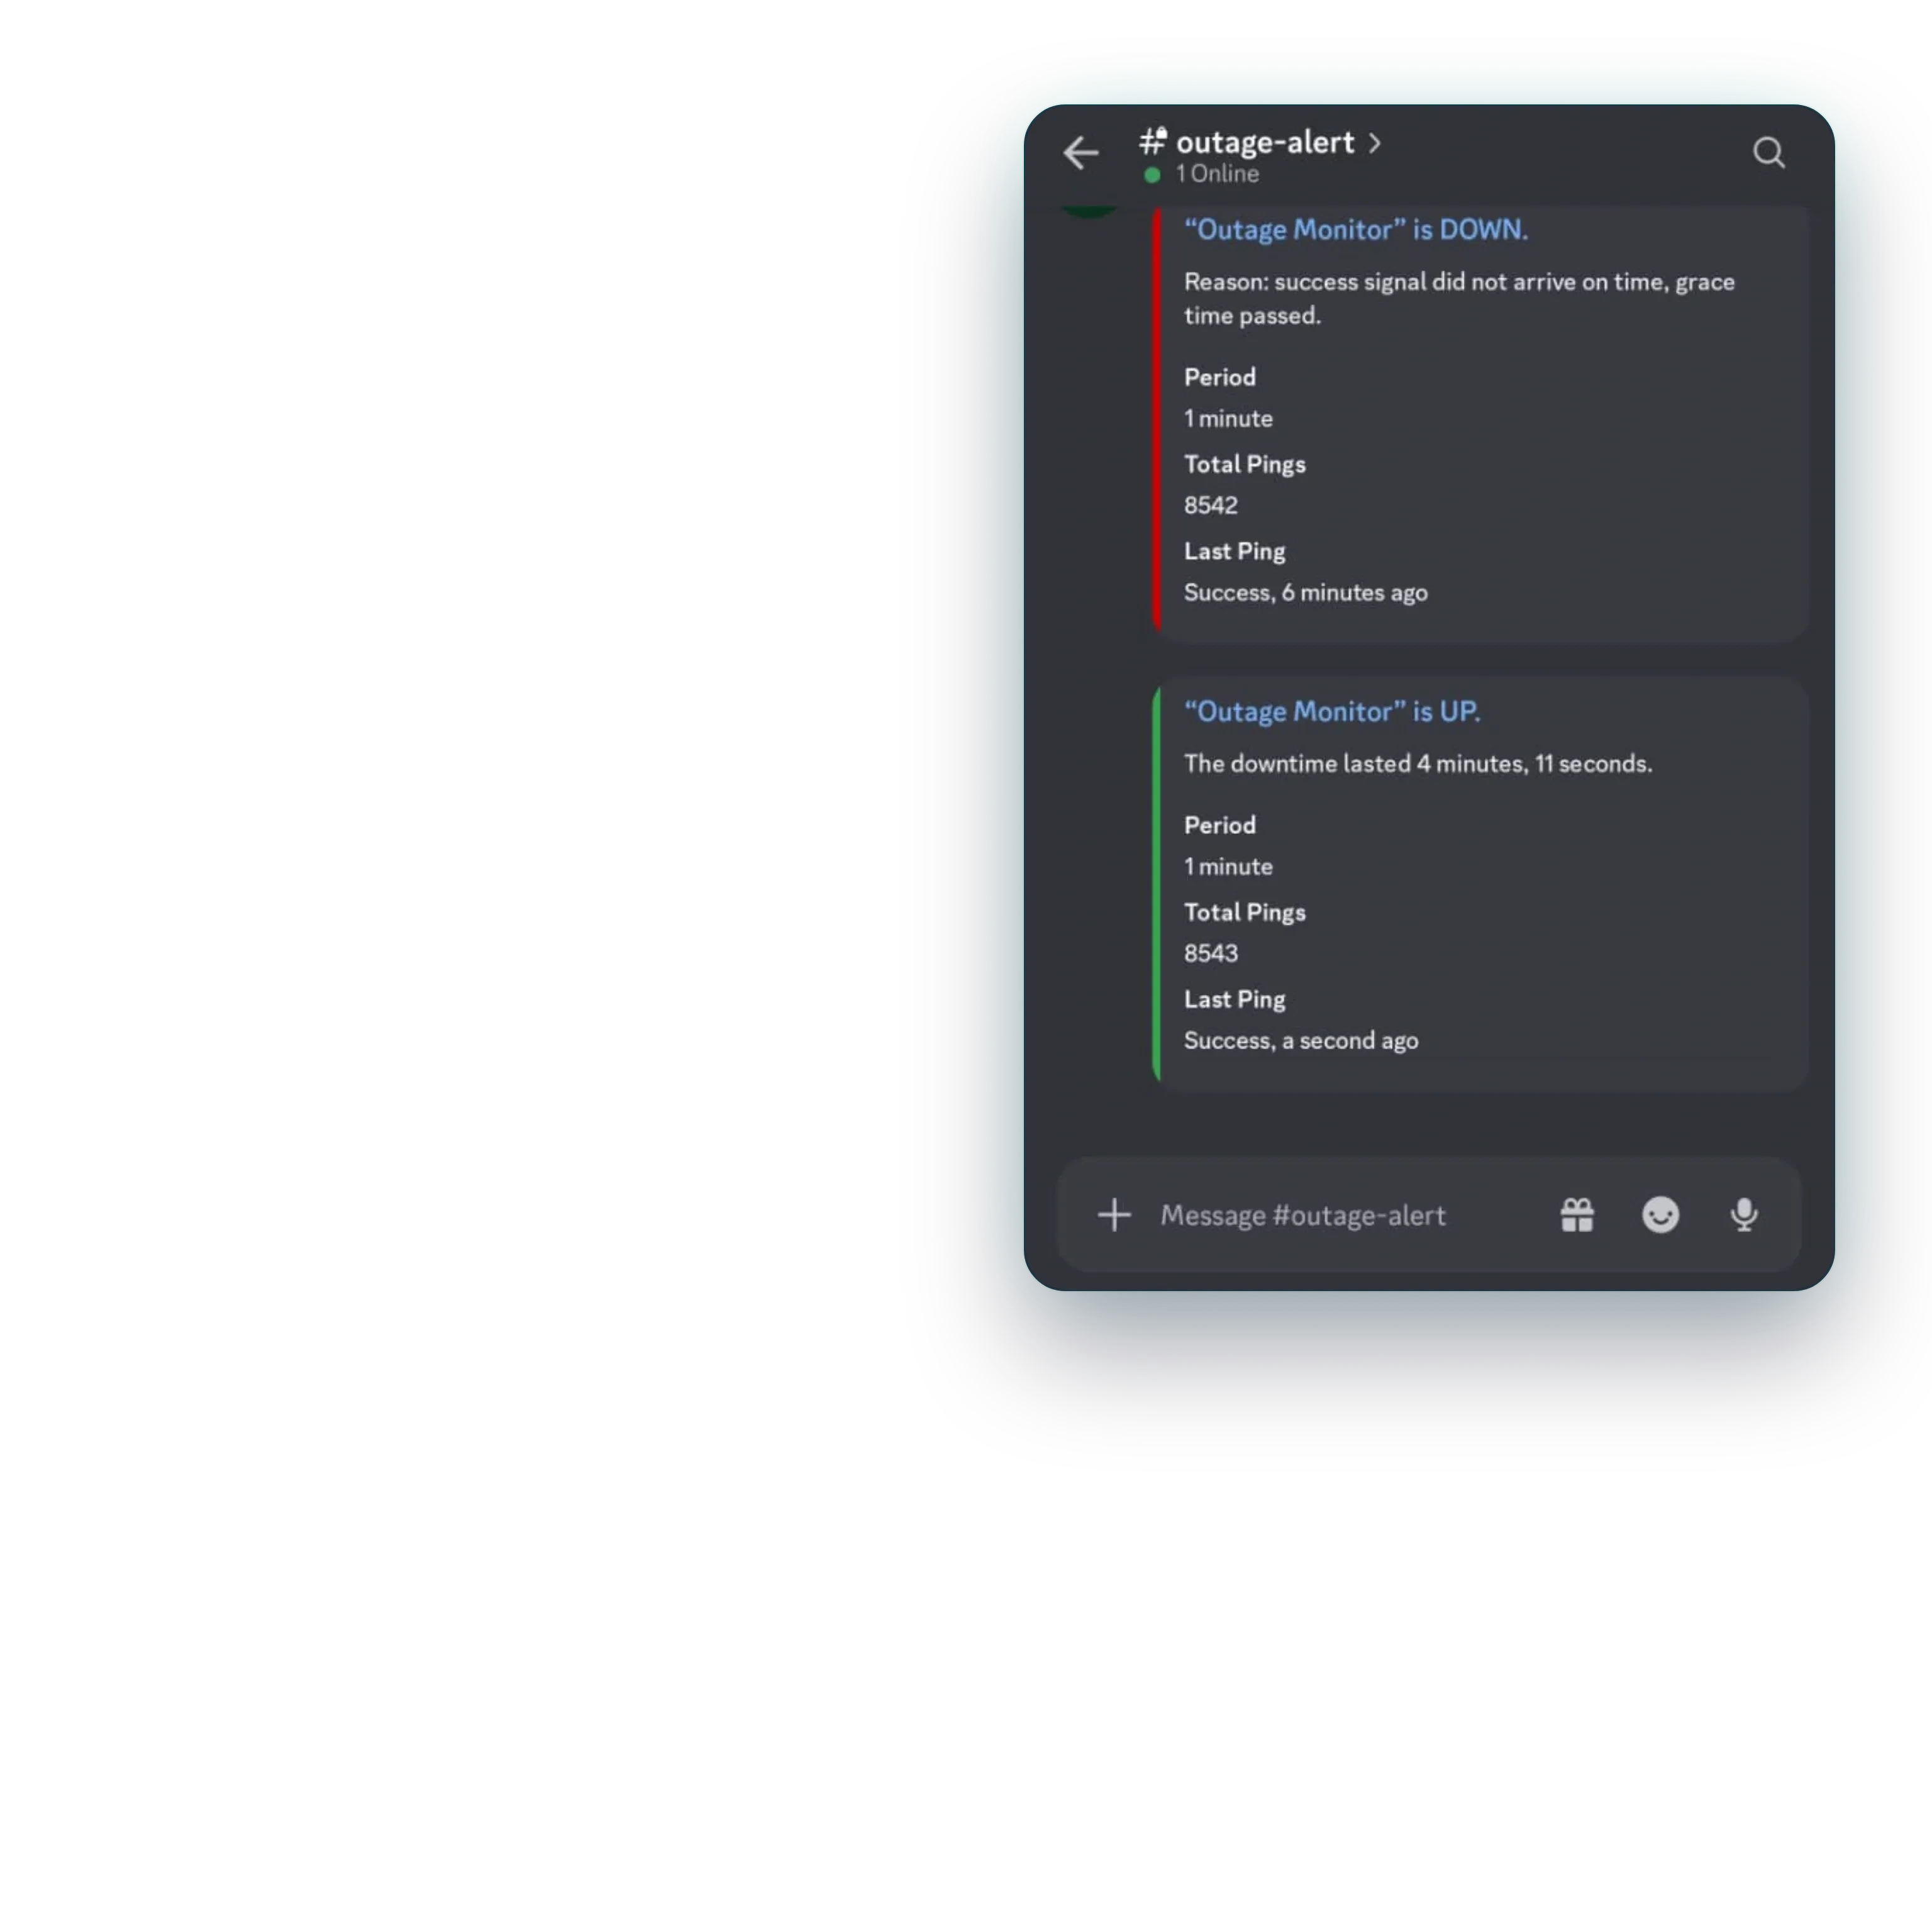
Nadie tiene que estar mirando un panel para que un problema se note: una alarma llega al teléfono por Telegram, Discord y ntfy, Telegram para el monitor de caídas y las reglas de alerta del propio clúster, y Discord y ntfy para el vigilante del monitor. El monitor, a su vez, está vigilado desde fuera de casa, así que cuando se quedó en silencio cuatro minutos el 30 de septiembre, ese mismo silencio llegó como una alarma, caída y luego recuperación, por Discord y ntfy a la vez.

También te puede gustar

La CI alojada era lo más lento y las compilaciones volvieron a casa
Las compilaciones y los despliegues pasaron de los runners alojados de GitHub, donde cada ejecución empezaba en una máquina nueva y las entregas esperaban colas e incidentes, a un pool de runners en casa: una máquina de compilación que toma cada trabajo mientras está encendida y runners de reserva en un servidor siempre encendido, detrás de un watchdog que, ante la duda, se inclina por seguir entregando. Las imágenes van a un registro de contenedores privado y las librerías del estudio a un registro npm privado, ambos dentro del edificio, y cada ejecución se archiva más allá de la retención de GitHub. El despliegue más lento pasó de ocho minutos y veinticuatro segundos a tres minutos y cinco, y la CI fue un tercio más rápida.
Md Moniruzzaman
sep 24, 2026
27 Pearls - Lanzamiento móvil y envío a tiendas
Una app de 27 Pearls terminada se convirtió en fichas aprobadas en App Store y Google Play dentro de un encargo de una semana, sin rondas de rechazos. La semana incluyó las compilaciones de publicación y la firma, textos de ficha escritos en torno al beneficio para el estudiante, capturas para cada tamaño de dispositivo exigido, declaraciones de privacidad acordes con lo que la app recoge y una cuenta de revisión que funcionaba. La app sigue hoy en Google Play.

Md Moniruzzaman
may 05, 2023

Fully Booked - Migración sin Tiempo de Inactividad a Kubernetes Autoalojado
Fully Booked funcionaba sobre infraestructura gestionada en la nube, con una factura que crecía cada mes y una pila que nadie controlaba del todo. Trasladamos toda la plataforma a un clúster de Kubernetes autoalojado sin un minuto de interrupción para quienes la usaban. El cambio abarcó DNS, ingress, bases de datos y el pipeline de despliegue, escalonado de modo que el tráfico se movía solo una vez probada cada capa en el clúster nuevo. Nadie que usara la aplicación esa semana notó nada, que era exactamente el objetivo. La factura recurrente pasó a ser hardware propio, y ese mismo clúster sostiene hoy las publicaciones semanales de la plataforma.

Md Moniruzzaman
jun 23, 2026

El blog son notas de campo desde producción: decisiones de arquitectura, sistemas de AI que sobrevivieron al contacto con usuarios reales e infraestructura que se paga sola. Escrito desde el trabajo, no sobre él.