Sukalyan Research Group, web de un grupo universitario de farmacia
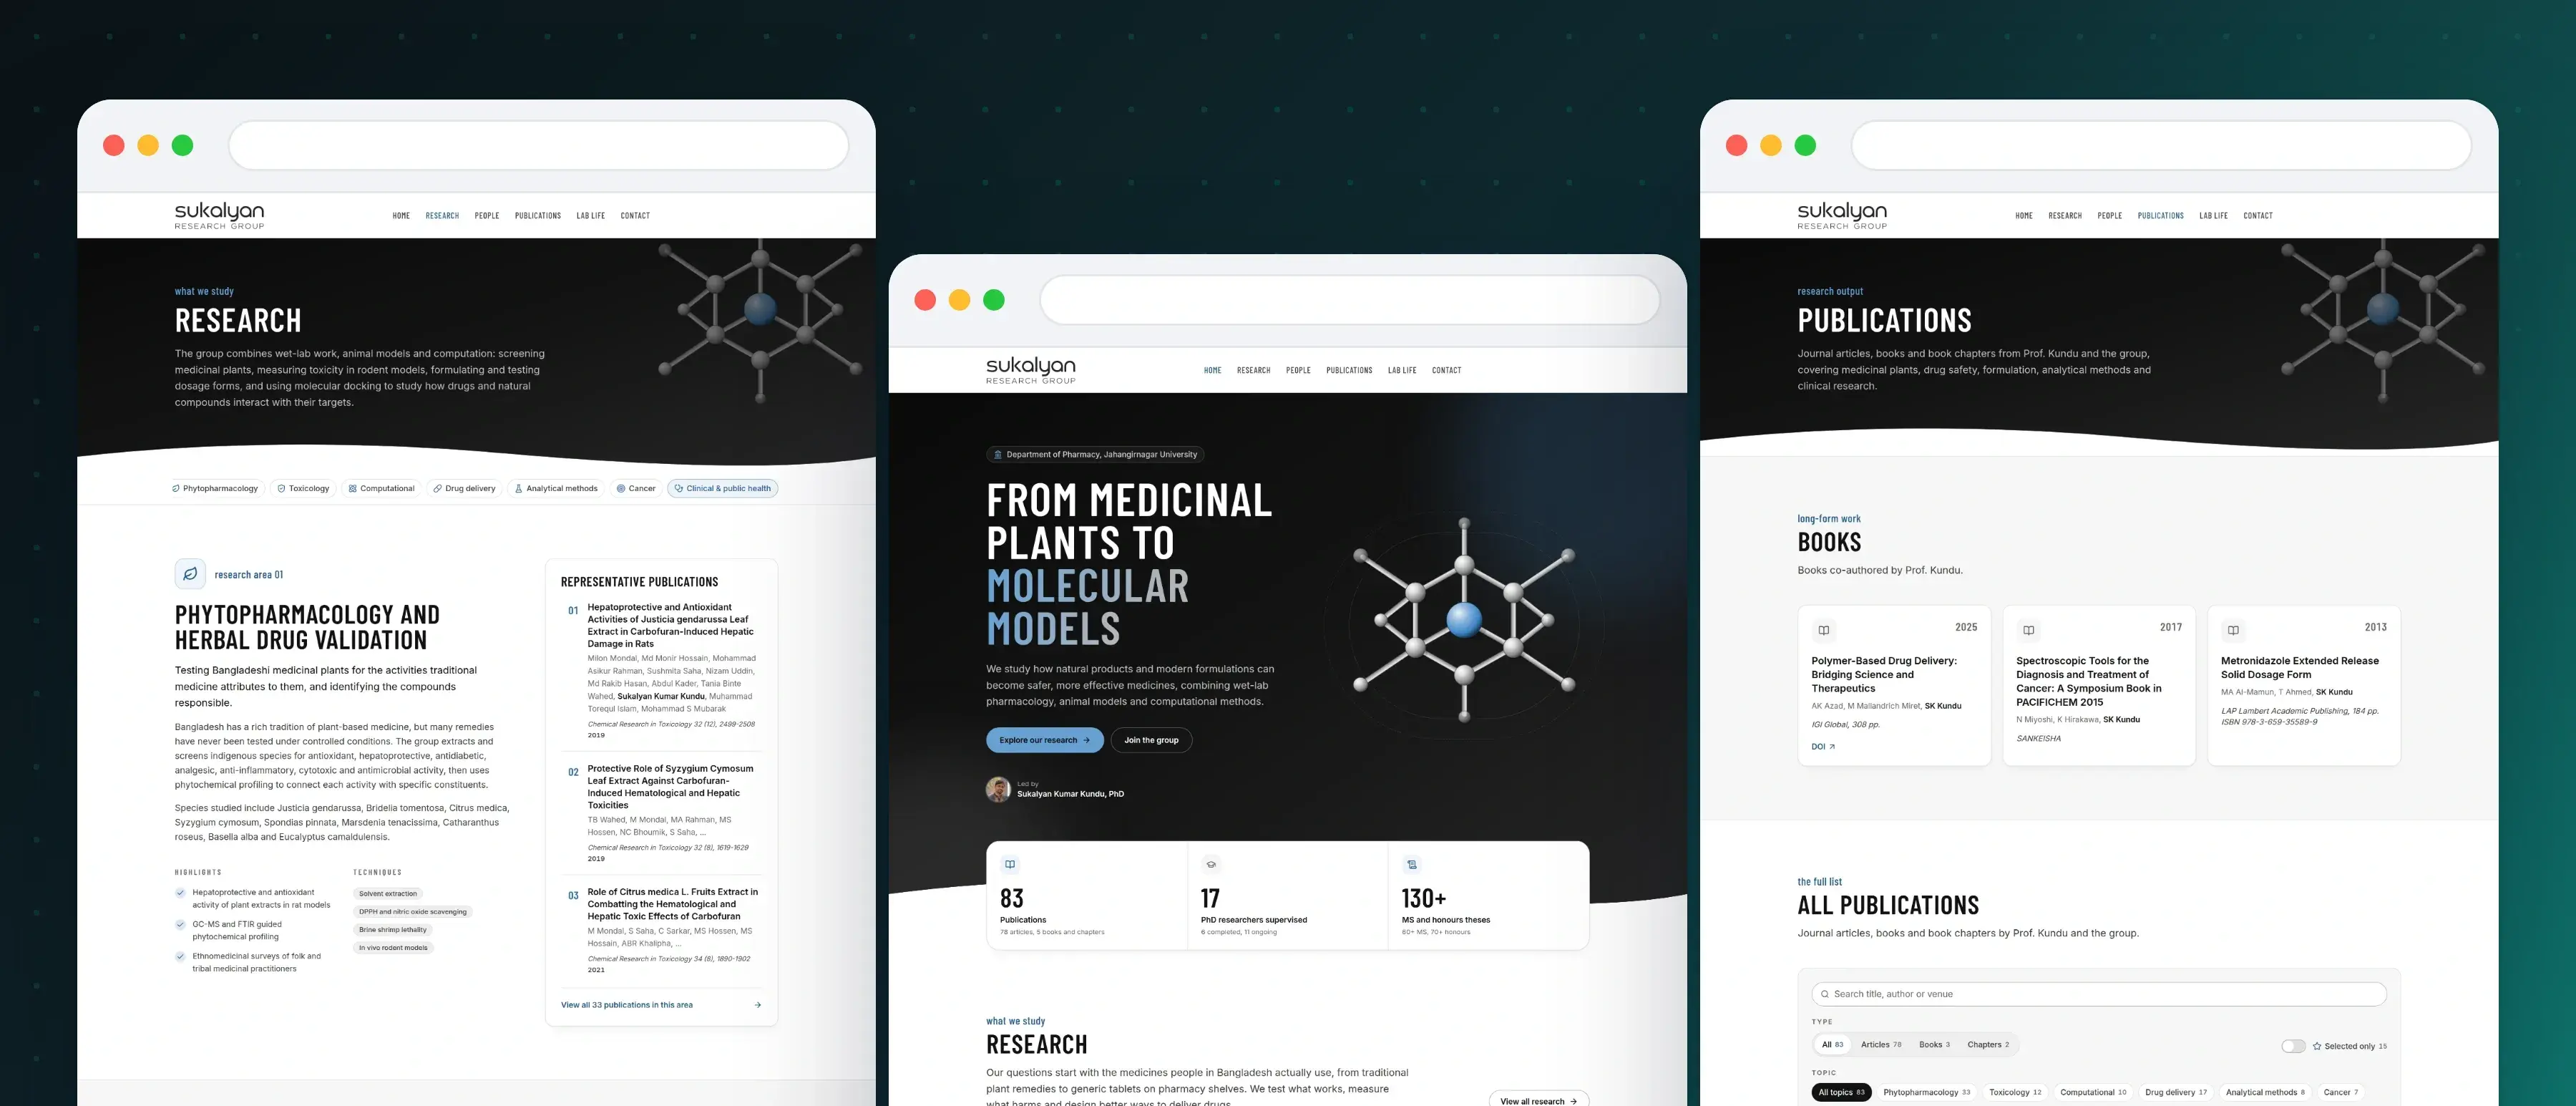
Sitio web del Sukalyan Research Group en el Department of Pharmacy de Jahangirnagar University, dirigido por el profesor Sukalyan Kumar Kundu: siete áreas de investigación con sus técnicas y artículos, una lista de publicaciones filtrable de ciento veinticuatro entradas de Google Scholar agrupadas por año, el perfil del investigador principal, los miembros por nombre y retrato, un muro de destinos de antiguos alumnos, una galería Lab Life y una página para unirse con cuatro vías y una lista de comprobación para el correo. Next.js con exportación estática, React y TypeScript, Tailwind CSS, todo el contenido detrás de una función de consulta para que el paso a un CMS headless no cambie nada más. Desplegado como un único contenedor en un clúster Kubernetes autoalojado.
Md Moniruzzaman

La historia completa
Un grupo de investigación con dos décadas de trabajo, una sola dirección en la web y mejores correos en la bandeja de entrada.
El trabajo era real. Encontrarlo, no.
El Sukalyan Research Group trabaja en el Department of Pharmacy de Jahangirnagar University, sobre plantas medicinales, liberación de fármacos, toxicología y farmacología computacional. Su investigador principal, el profesor Sukalyan Kumar Kundu, tiene ochenta y tres publicaciones listadas, supervisa a once investigadores doctorales y ha dirigido más de sesenta tesis de MS y setenta proyectos de honours. Nada de eso estaba en un solo lugar. Un futuro estudiante, un colaborador o una farmacéutica que buscara al grupo encontraba un perfil de Google Scholar, una página de ResearchGate, un listado de personal de la universidad y una cuenta social, cada uno mostrando un trozo distinto y ninguno explicando para qué existe el grupo.
A un grupo de investigación se le juzga por lo que devuelve una búsqueda. El encargo era una sola dirección que llevara la imagen completa: qué estudia el laboratorio, quién trabaja en él, cada artículo que ha publicado y cómo unirse.
Una línea que le dice a un desconocido para qué existe el laboratorio
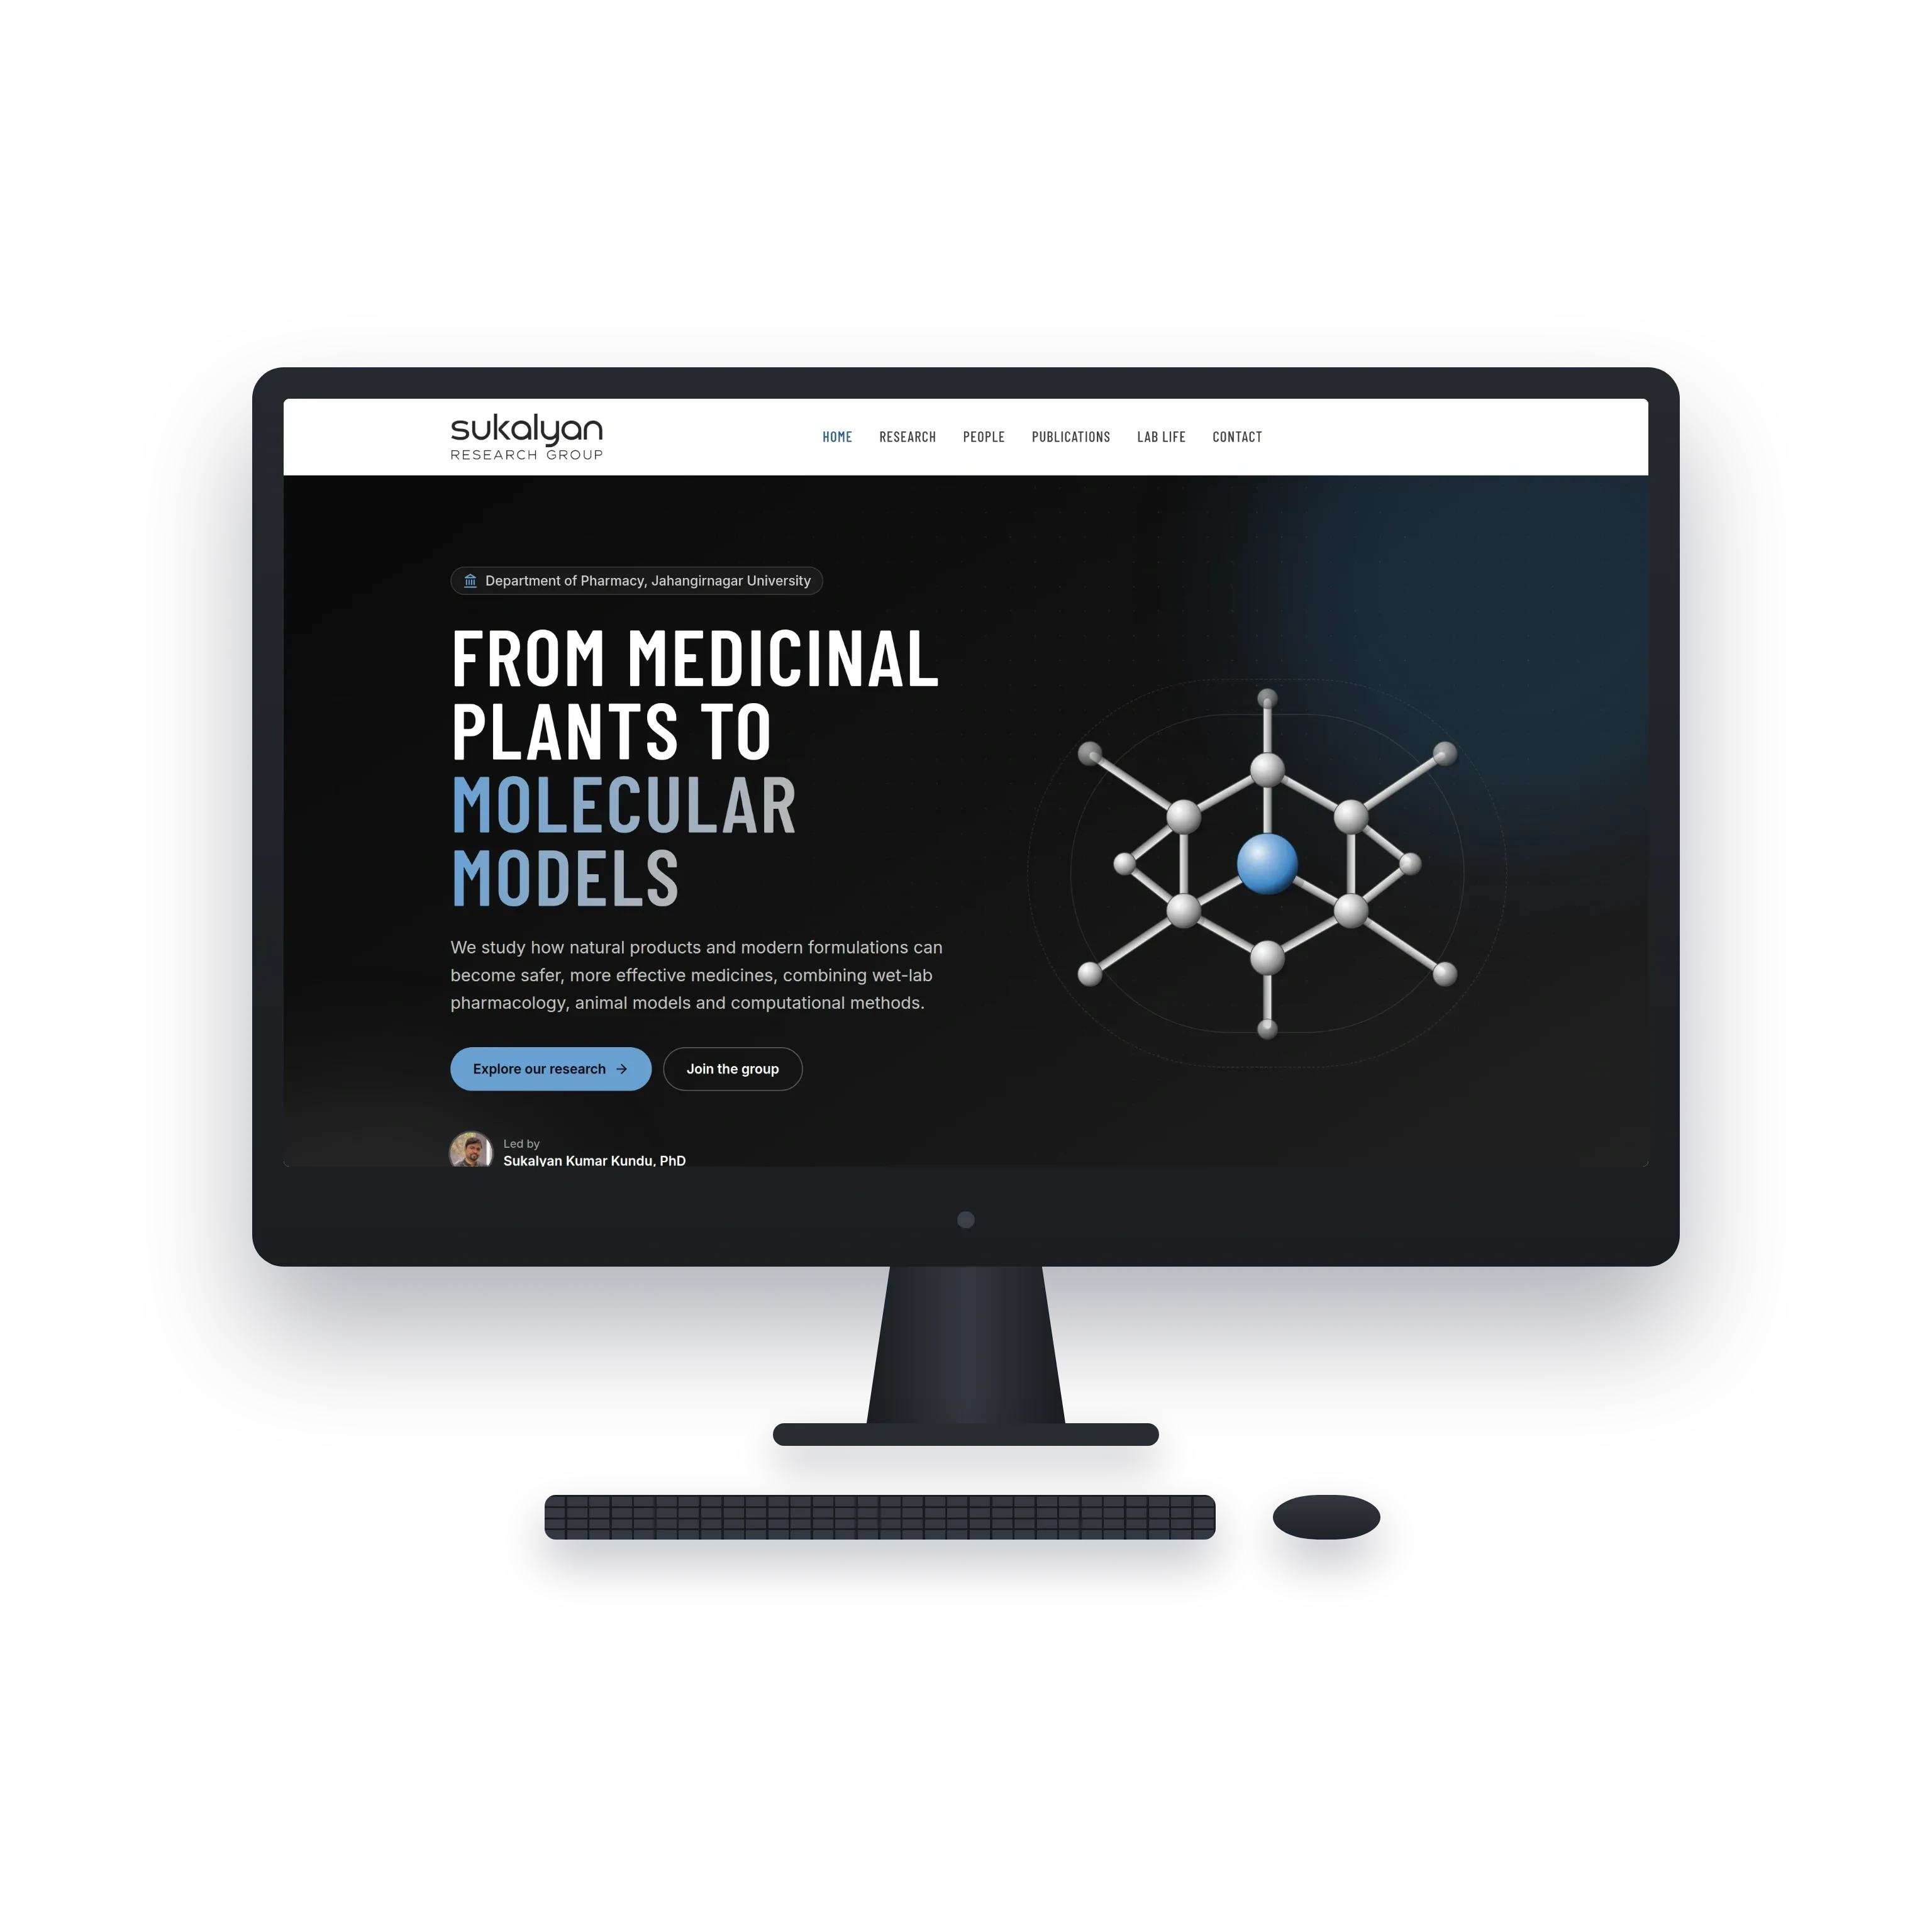
La página de inicio se abre con la frase que el grupo diría si tuviera treinta segundos: de las plantas medicinales a los modelos moleculares, estudiando cómo los productos naturales y las formulaciones modernas se convierten en medicamentos más seguros y eficaces. Debajo están las dos cosas que un visitante quiere de verdad, la investigación y la forma de entrar, y luego tres cifras que el grupo puede respaldar: ochenta y tres publicaciones, diecisiete investigadores doctorales supervisados, más de ciento treinta tesis de MS y de honours. Más abajo vienen las siete áreas de investigación, el investigador principal con sus cinco perfiles públicos, seis artículos seleccionados, el equipo por nombre y cargo, y un relato breve y honesto de la universidad y el departamento que rodean al grupo.
Las preguntas en las que trabaja el grupo empiezan por los medicamentos que la gente de Bangladés usa de verdad, desde remedios tradicionales de plantas hasta comprimidos genéricos en el estante de una farmacia. Decirlo con claridad, en la primera pantalla, es lo que separa a un grupo que un desconocido puede situar de uno que no.
Siete áreas de investigación, cada una responde antes de la pregunta
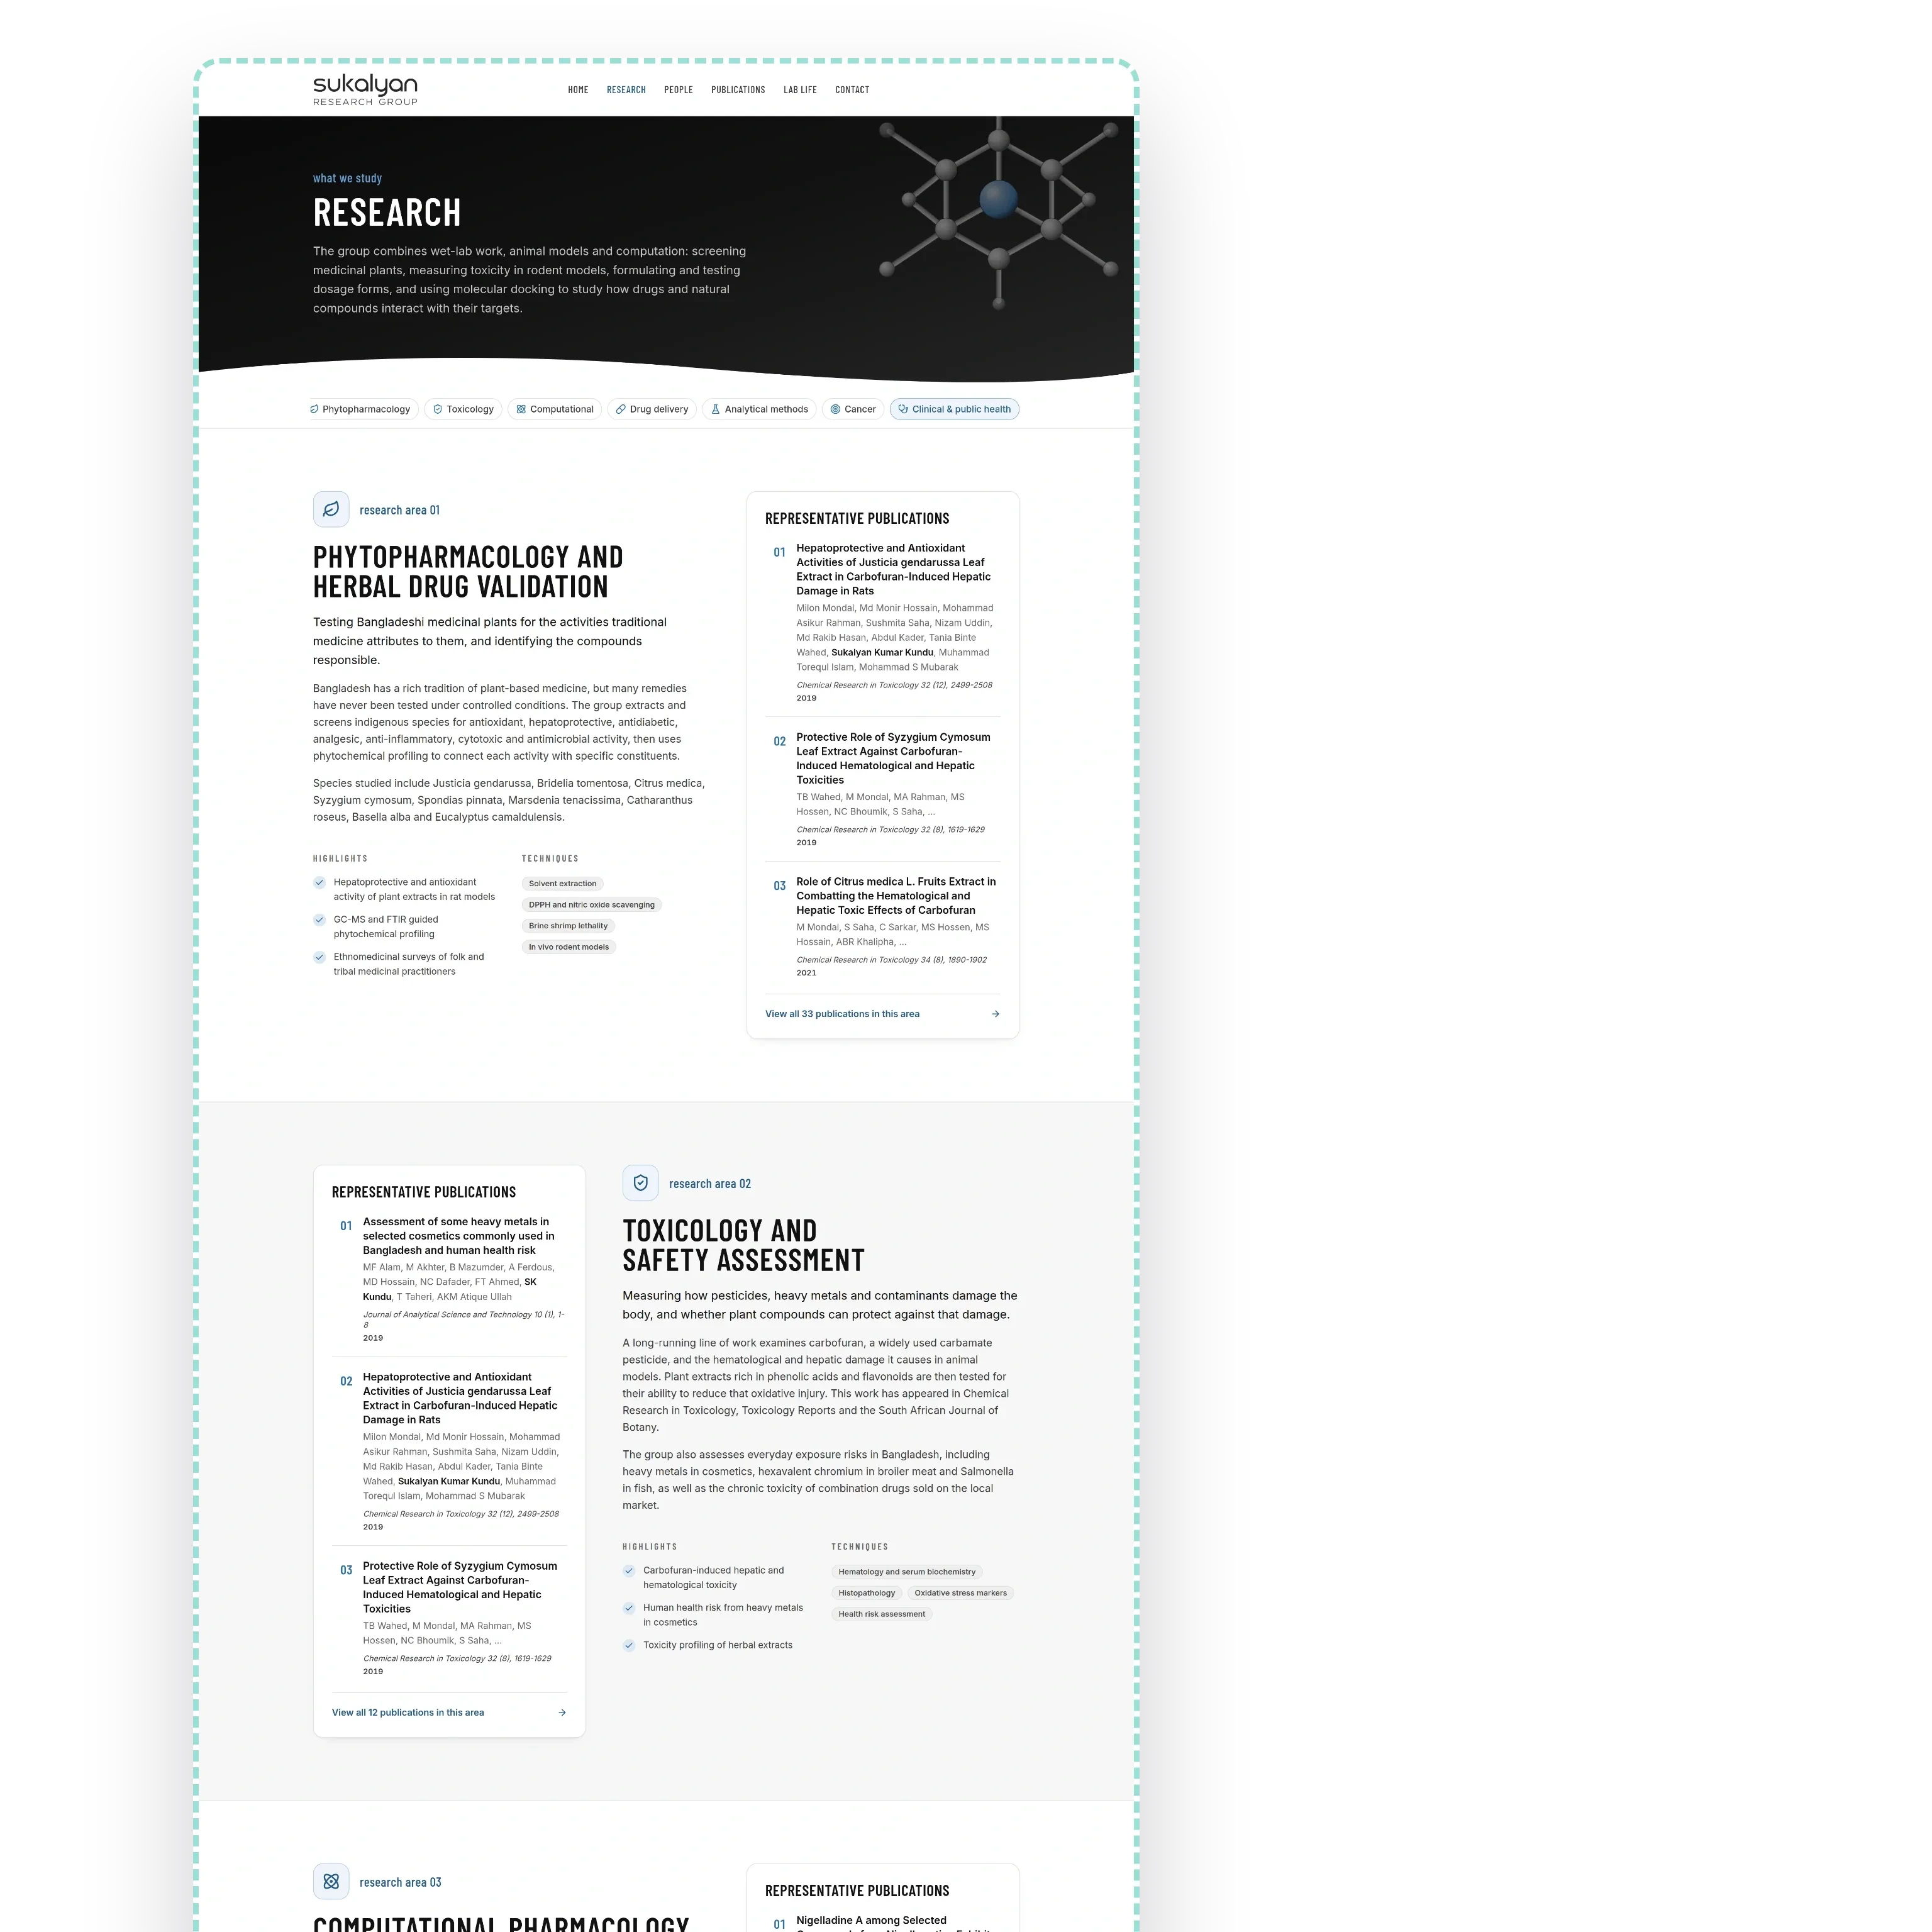
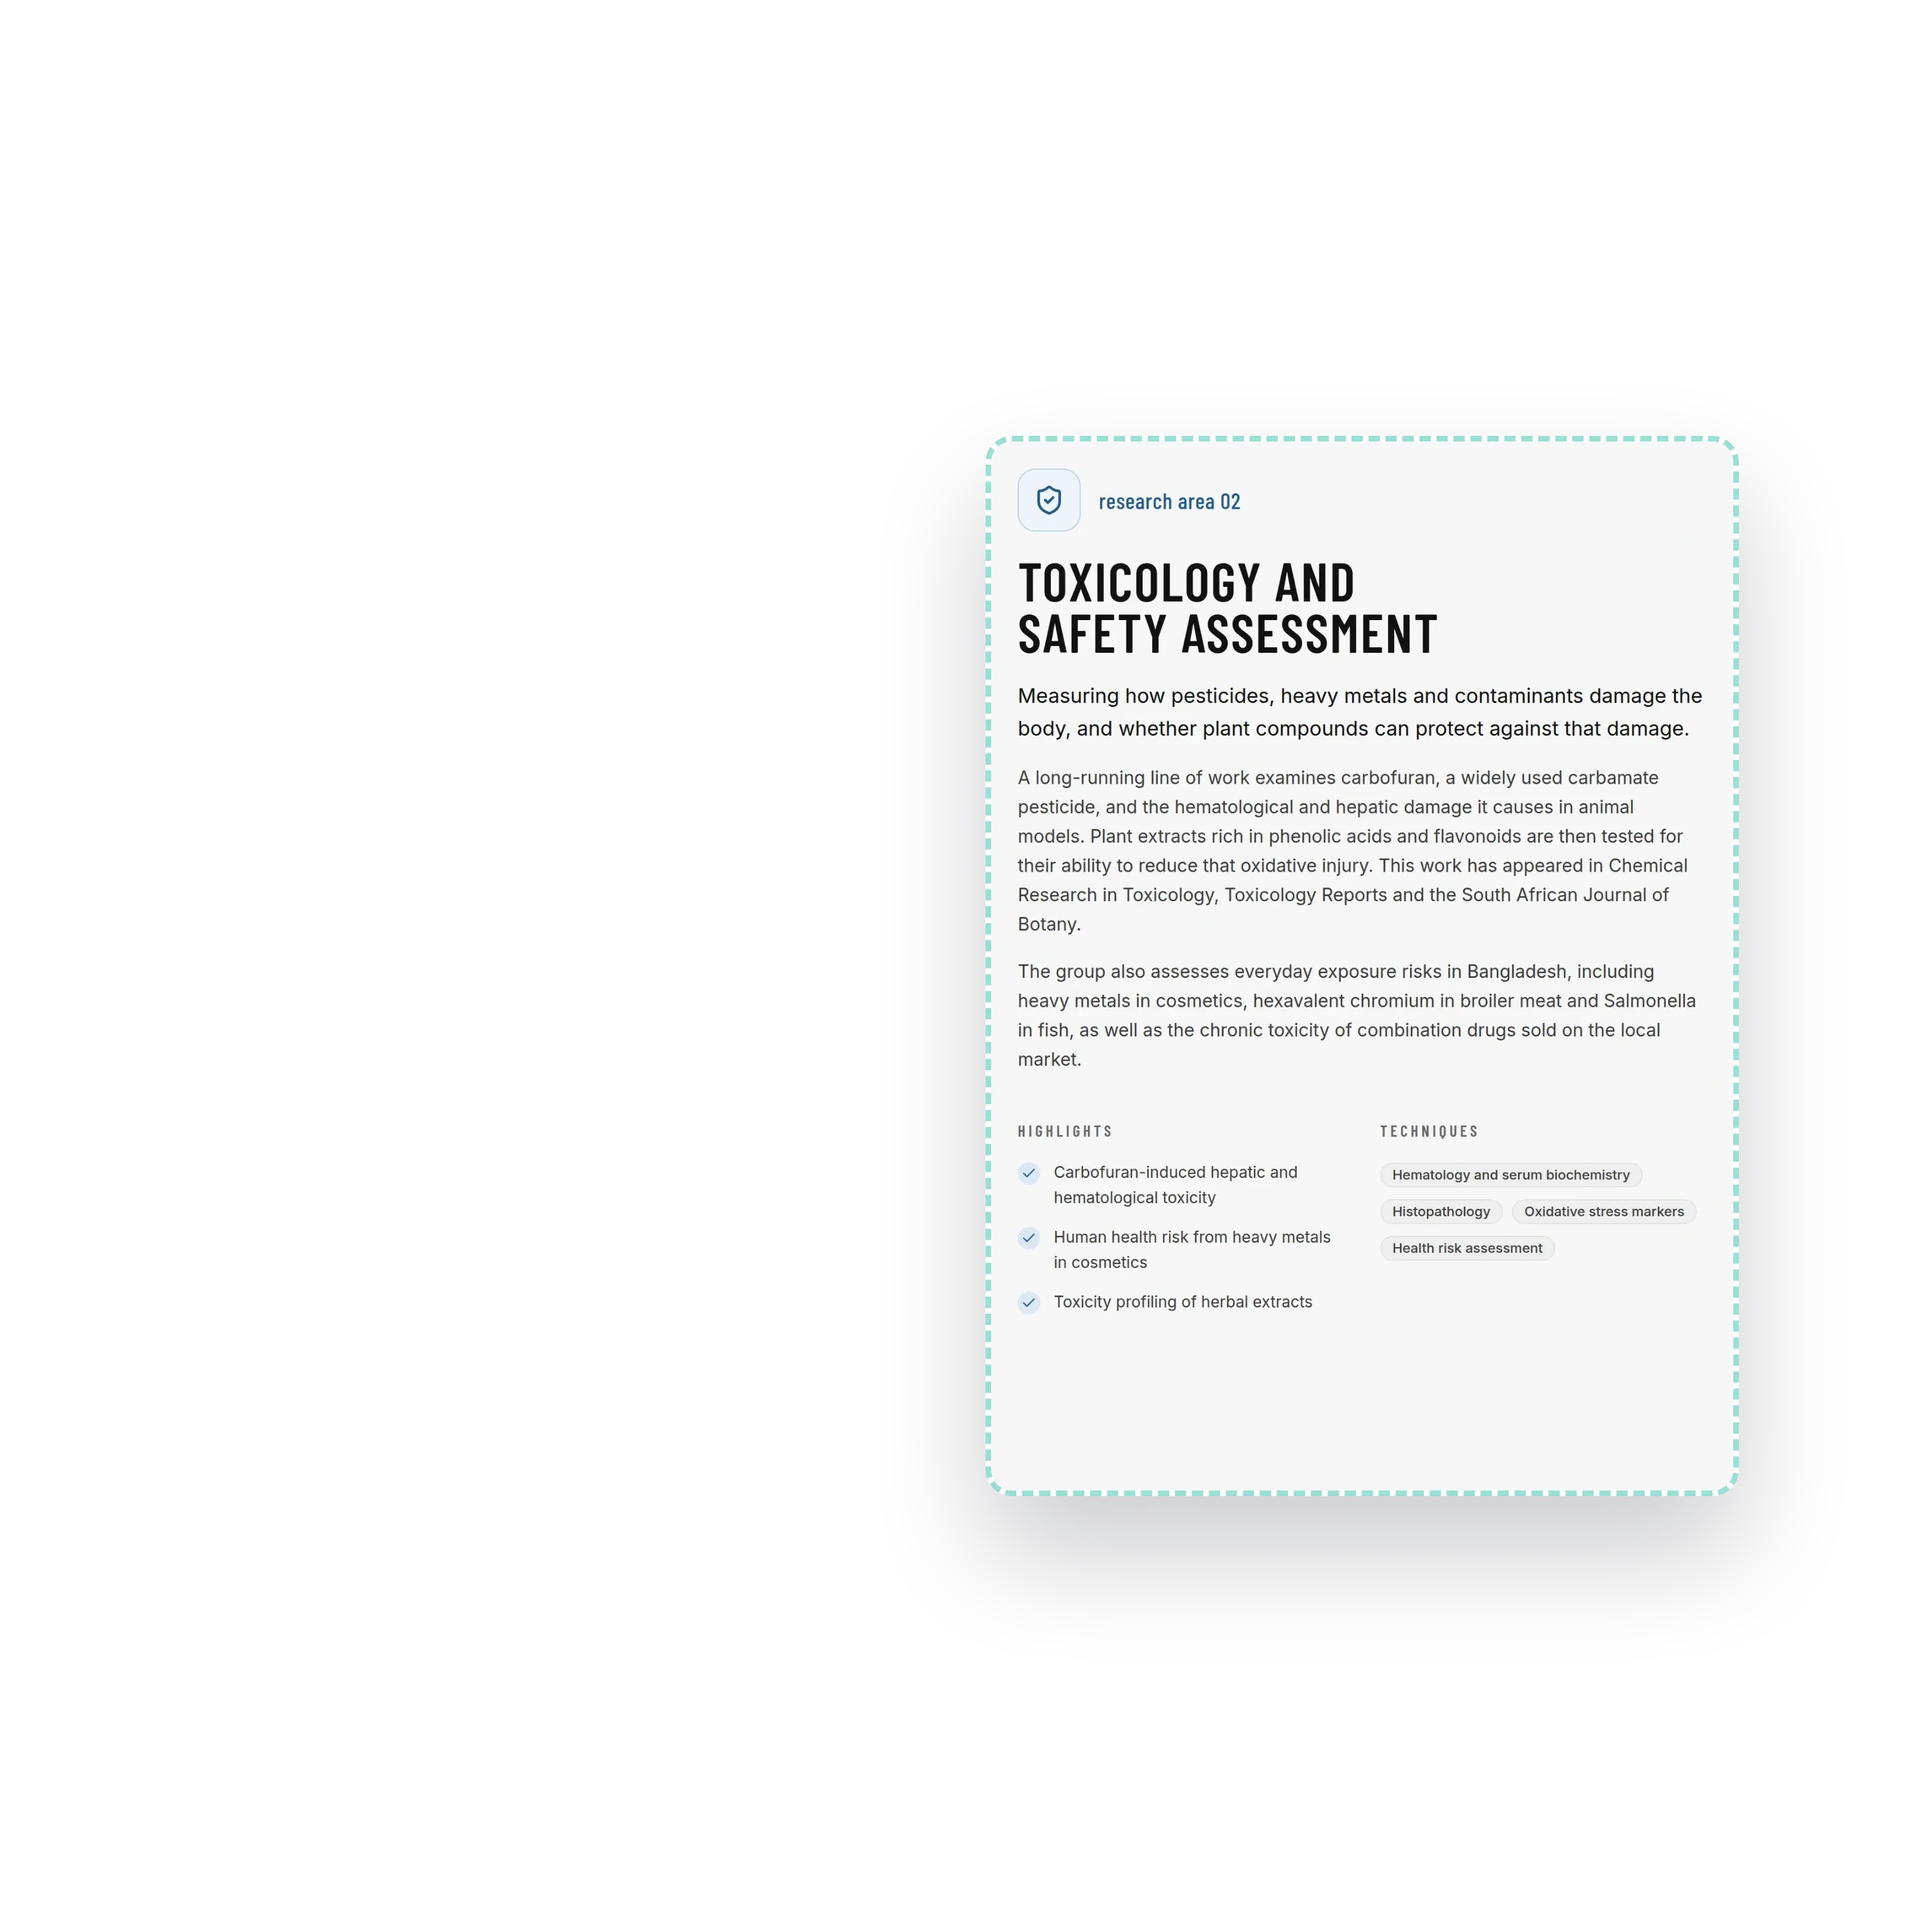
La página de investigación expone siete áreas: fitofarmacología y validación de fármacos herbales, toxicología y evaluación de seguridad, farmacología computacional y acoplamiento molecular, liberación de fármacos y ciencia de formulación, desarrollo y validación de métodos analíticos, terapéutica del cáncer, e investigación clínica y de salud pública. Cada una lleva qué estudia, las técnicas que usa, sus hitos y tres artículos representativos, con un enlace a cada artículo que hay detrás, así que un área nunca es un título sin nada debajo, y una franja con las siete queda fija mientras la página se desplaza.
Esta es la página que hace el filtrado del grupo. Un estudiante que lee que el laboratorio trabaja sobre toxicidad del carbofurano en modelos animales, o sobre metales pesados en cosméticos, escribe un correo distinto del que solo leyó que es un departamento de farmacia. La banda de métodos bajo las áreas agrupa las técnicas por disciplina, acoplamiento y perfilado ADMET, HPLC y ensayos de disolución, comprimidos matriciales e hidrogeles, modelos animales y letalidad en artemia, inmunohistoquímica, para que un colaborador vea en una pantalla si el grupo realiza el ensayo que necesita.
Cada artículo navegable y los errores de autoría tratados con honradez
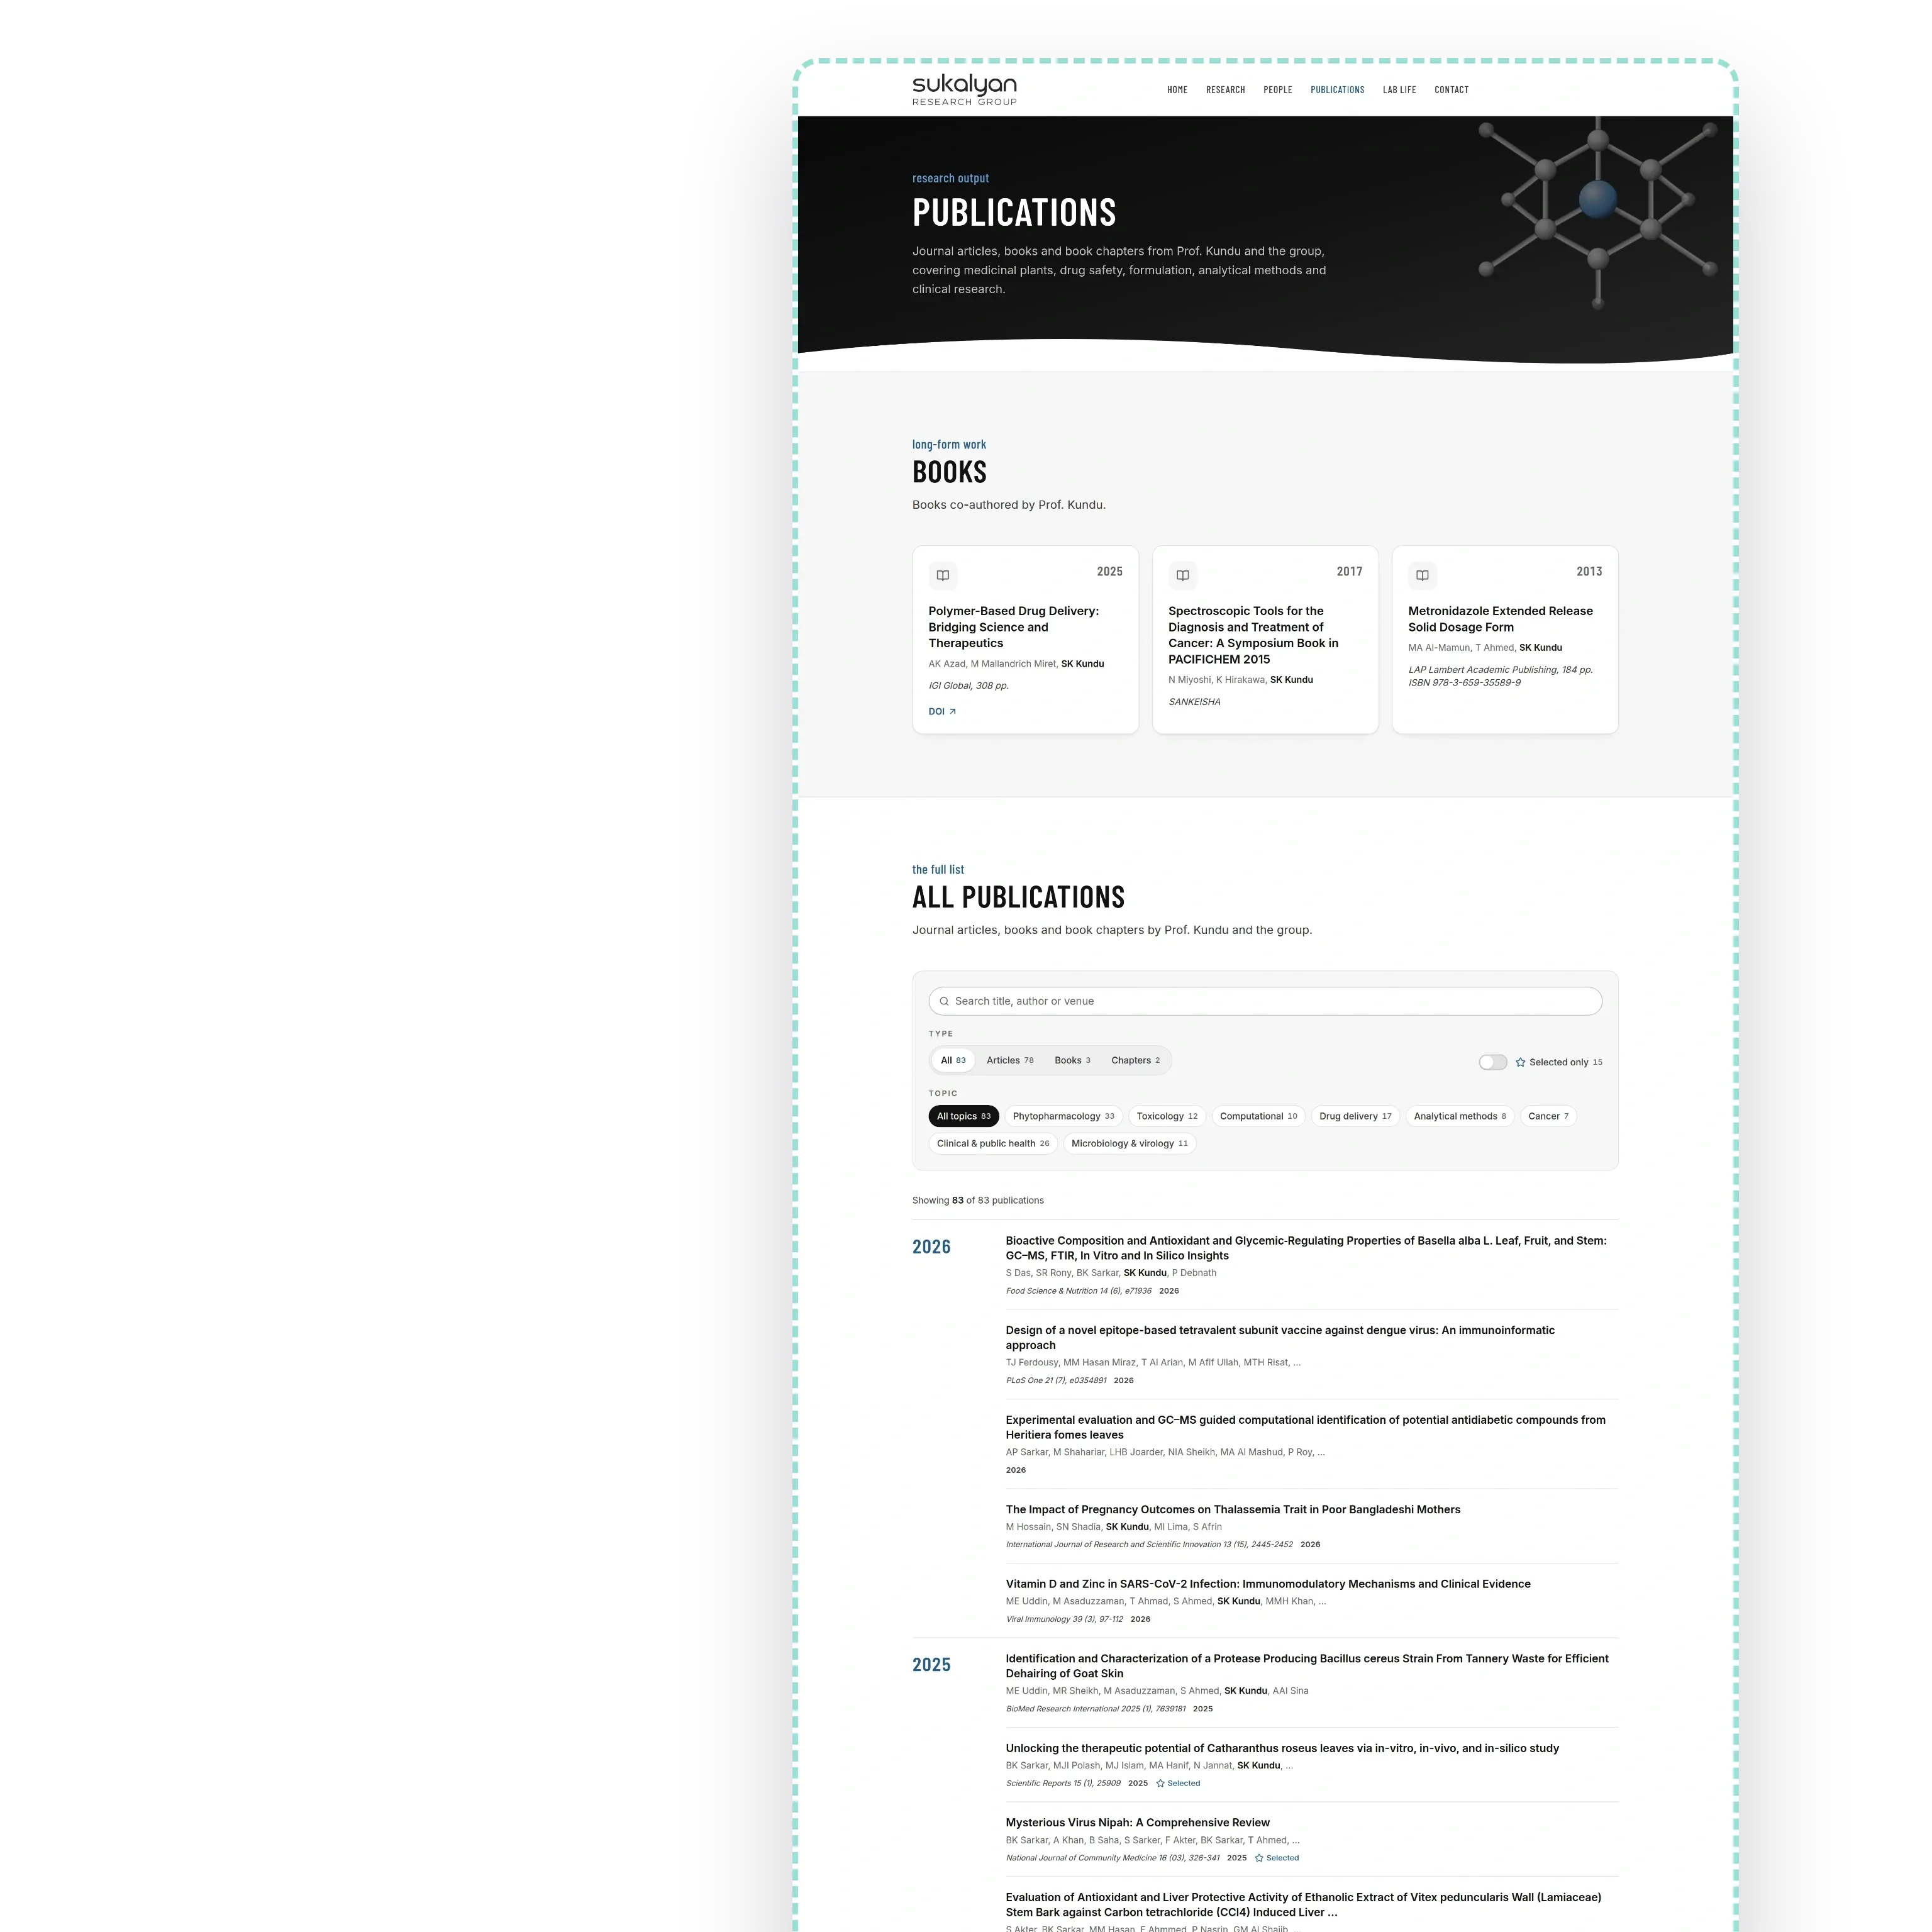
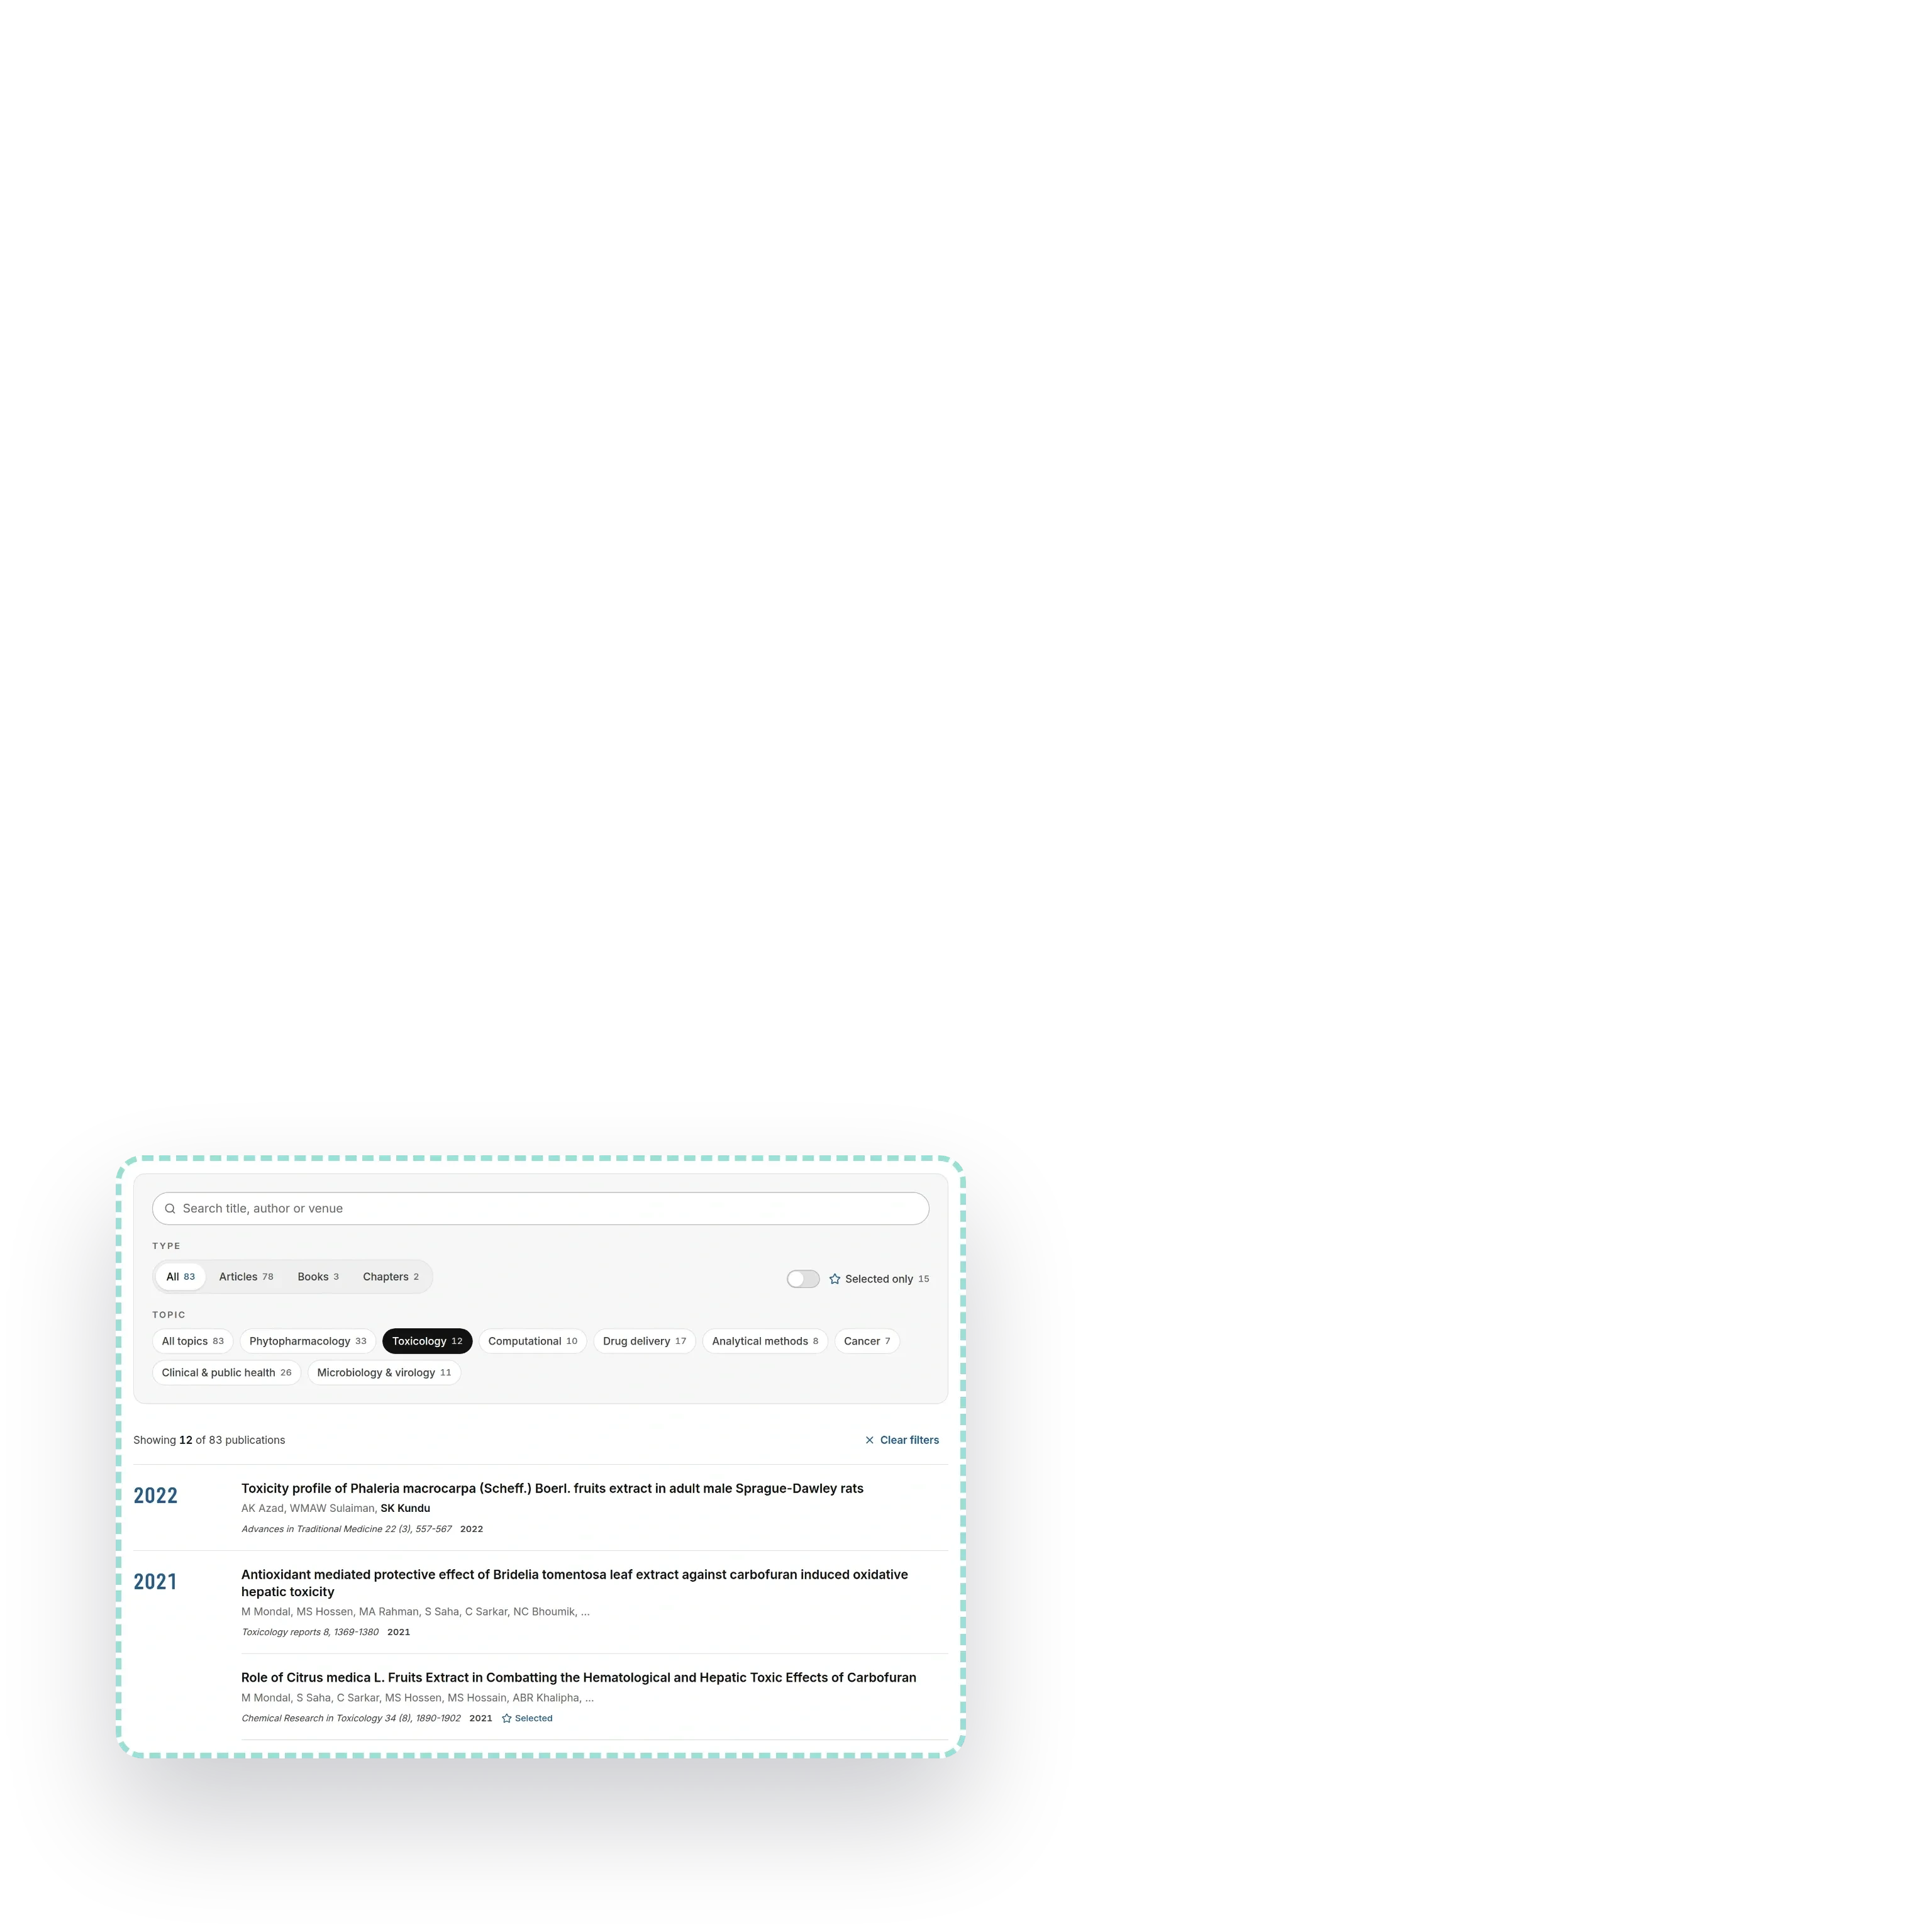
La página de publicaciones lleva ciento veinticuatro entradas sincronizadas desde Google Scholar. Se muestran ochenta y tres, agrupadas por año bajo encabezados que quedan fijos mientras la lista se desplaza, filtrables por tipo, por tema y por texto libre, con un interruptor para los quince artículos seleccionados y los tres libros en tarjetas propias encima de la lista. Cada filtro vive en la barra de direcciones, así que un área de investigación enlaza directamente con sus doce o treinta y tres artículos.
Lo interesante son los cuarenta y uno que no se muestran. Scholar adjunta artículos de otros autores con nombres parecidos, y esas entradas se quedan en el contenido con una nota de revisión que explica por qué cada una está oculta, en lugar de borrarse. La lista de publicaciones de un grupo es la única página que un revisor comprobará línea por línea, así que una entrada equivocada cuesta más que una ausente, y una entrada oculta puede restaurarse en cuanto alguien la confirma.
Personas por nombre y cargo, y adónde fueron después
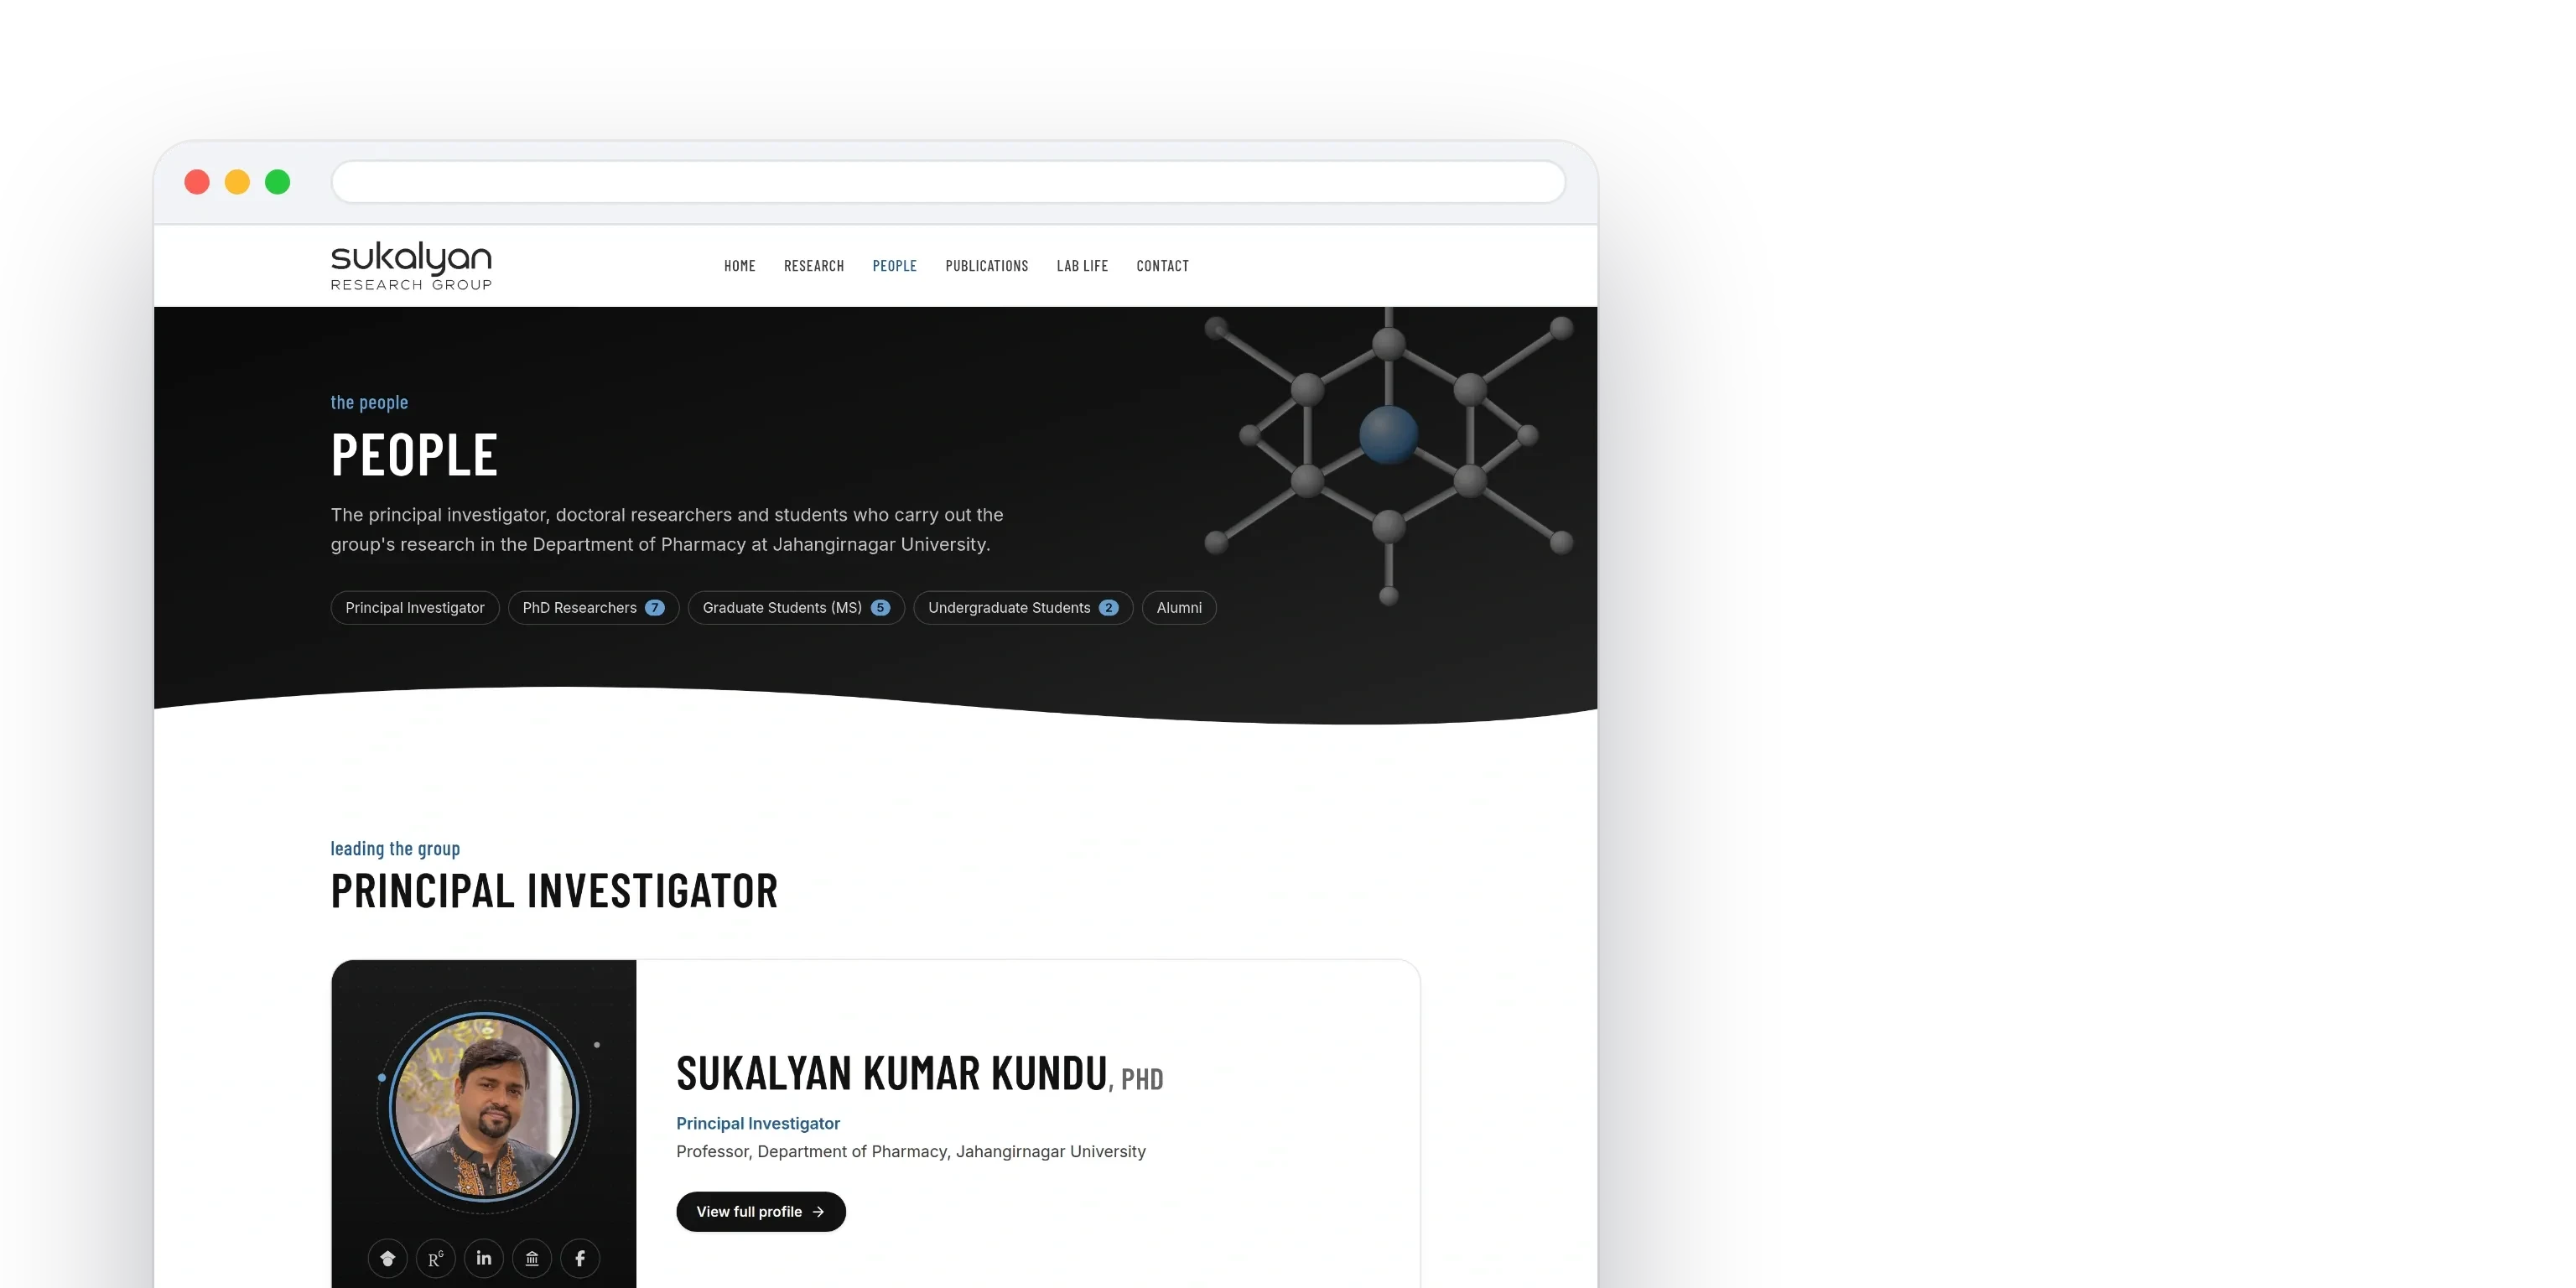
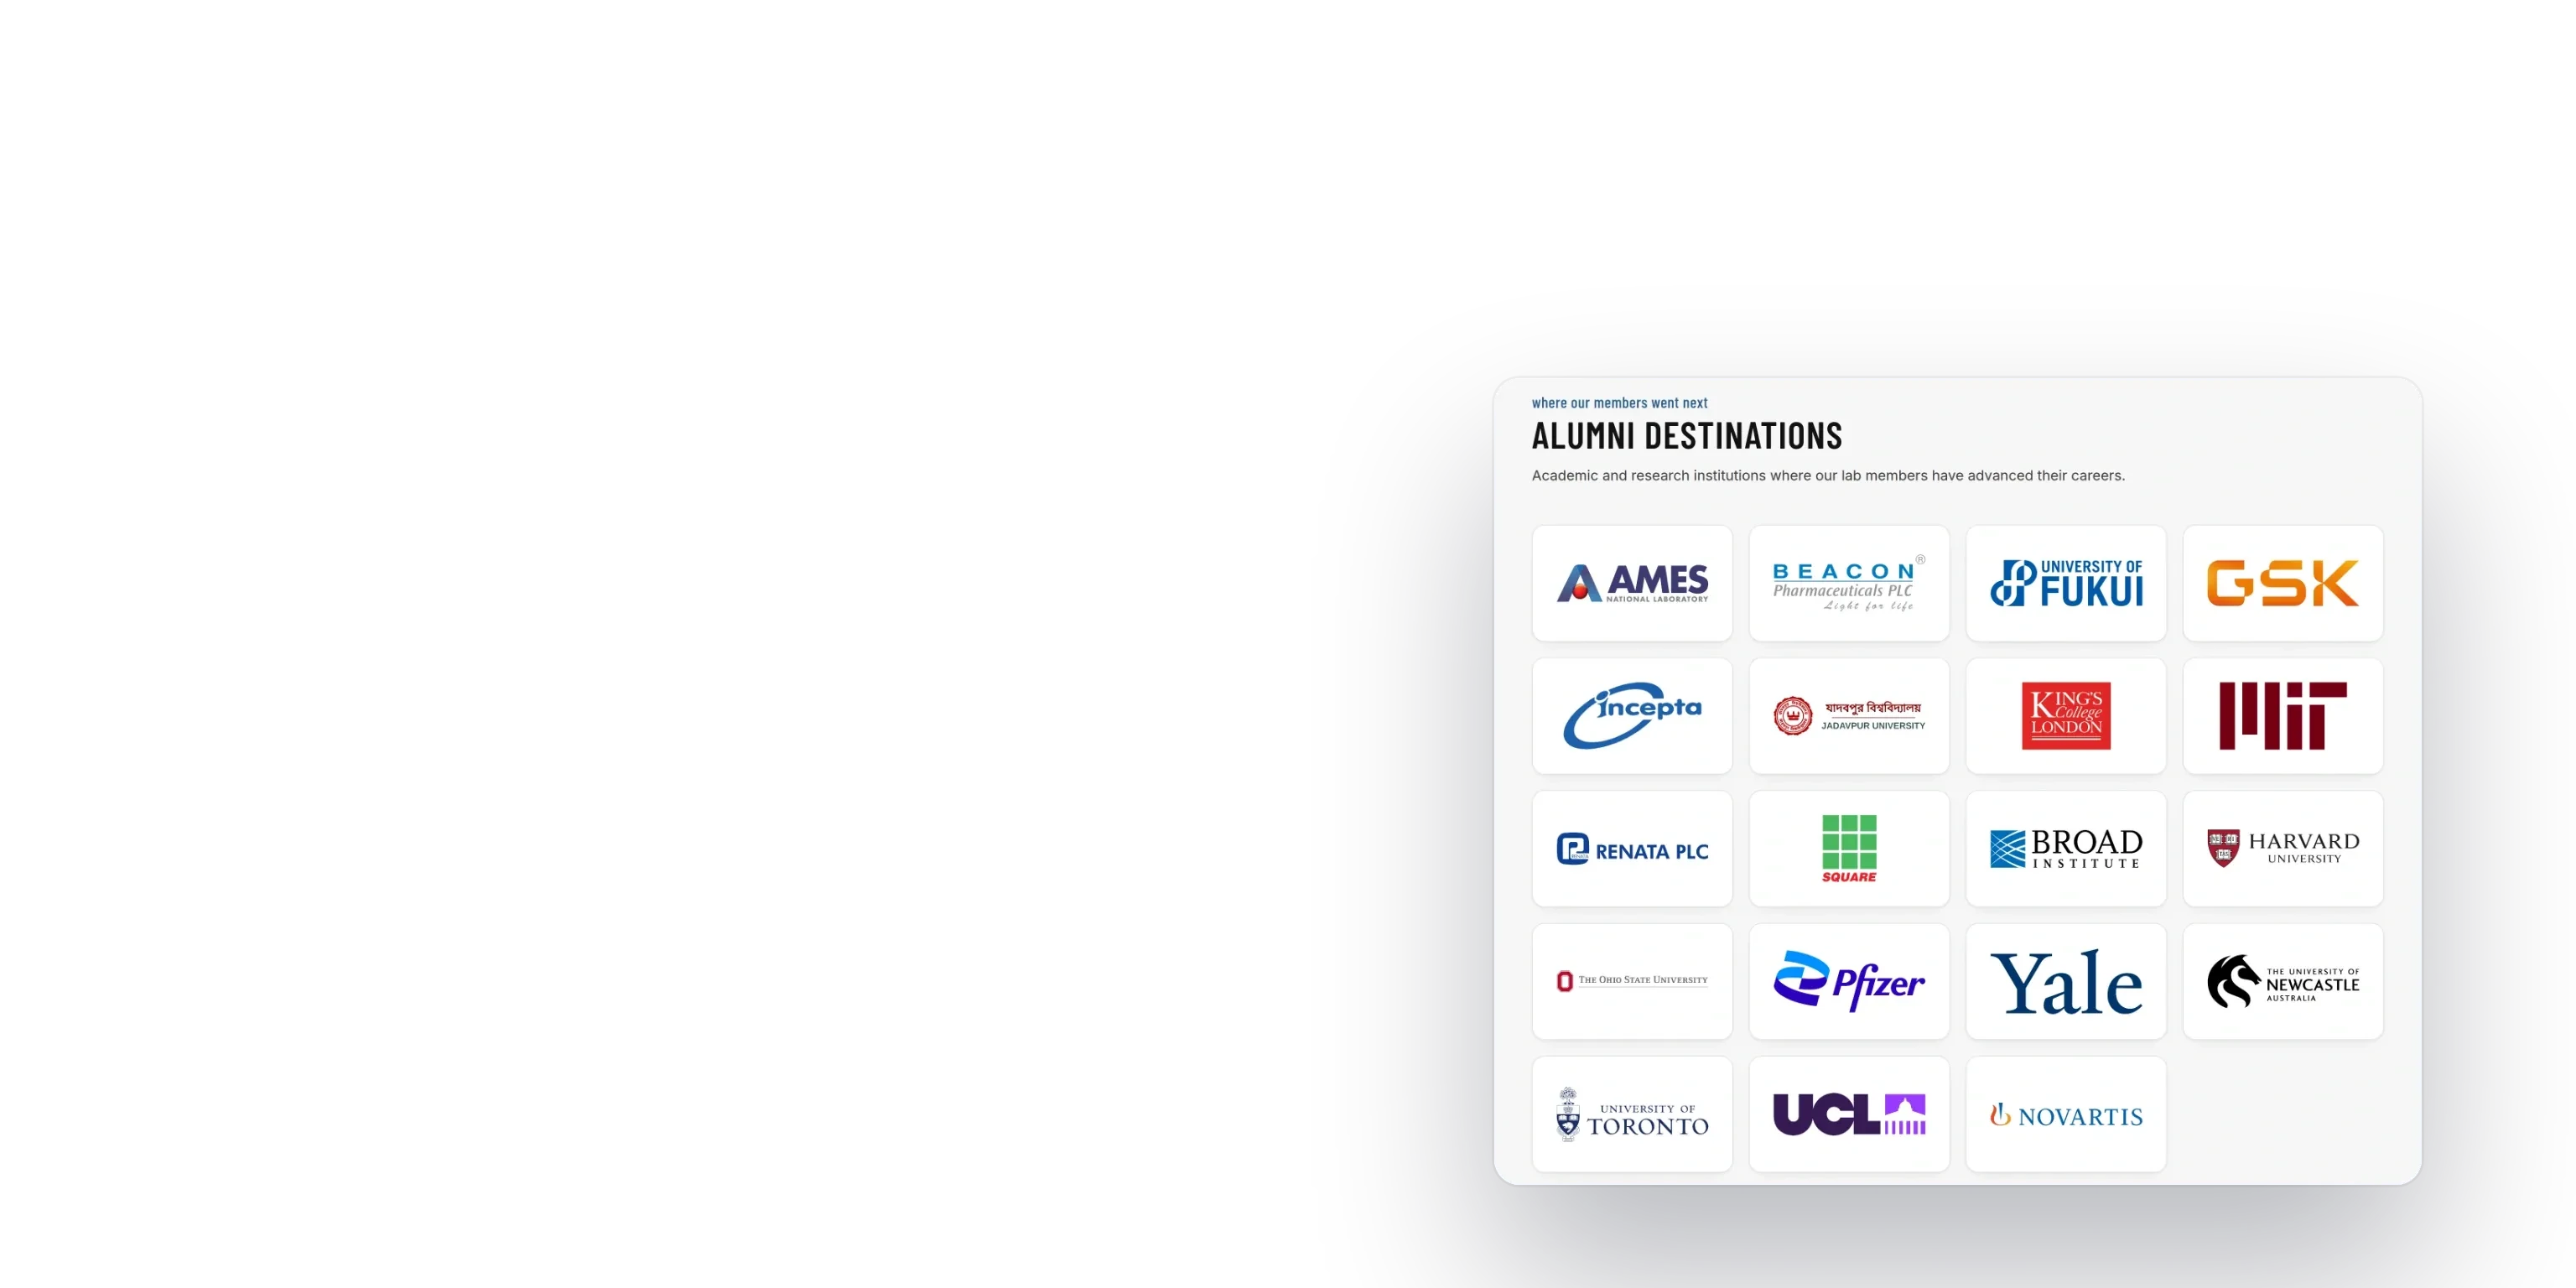
La página de personas lleva al investigador principal con sus cinco perfiles públicos y un perfil completo detrás, luego siete investigadores doctorales. La página de investigación cierra con el destino de los antiguos miembros: diecinueve destinos en ocho países, de Harvard, MIT y Yale a Pfizer, Novartis y Square.
Un primer correo que merece respuesta
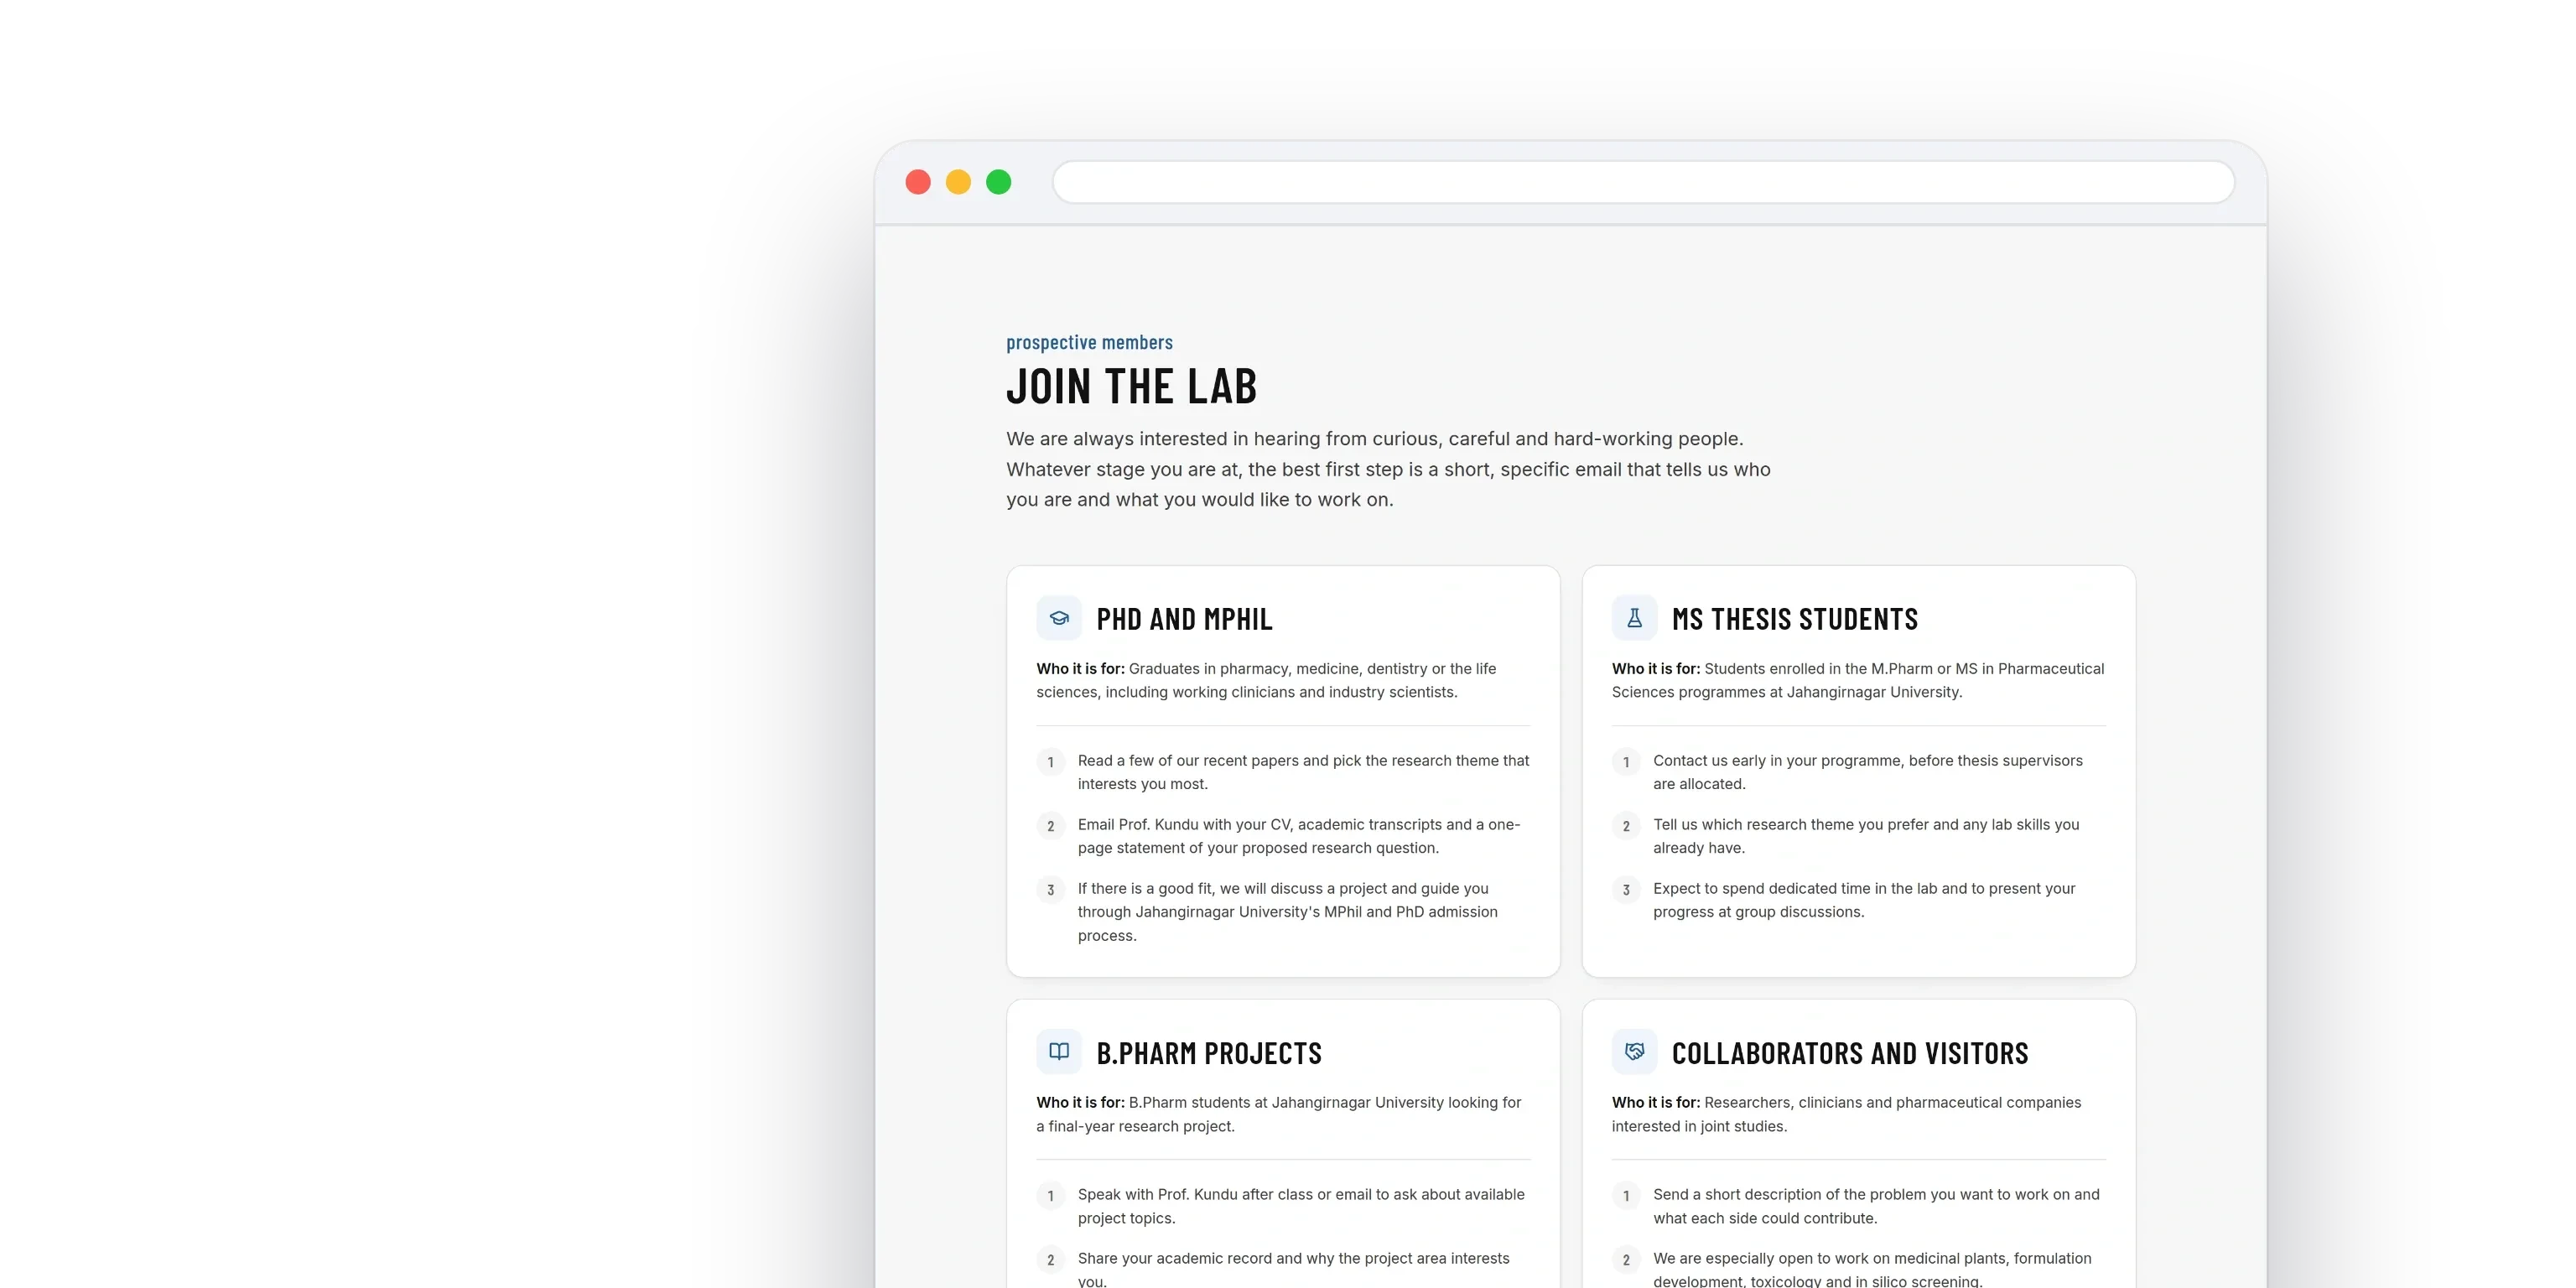
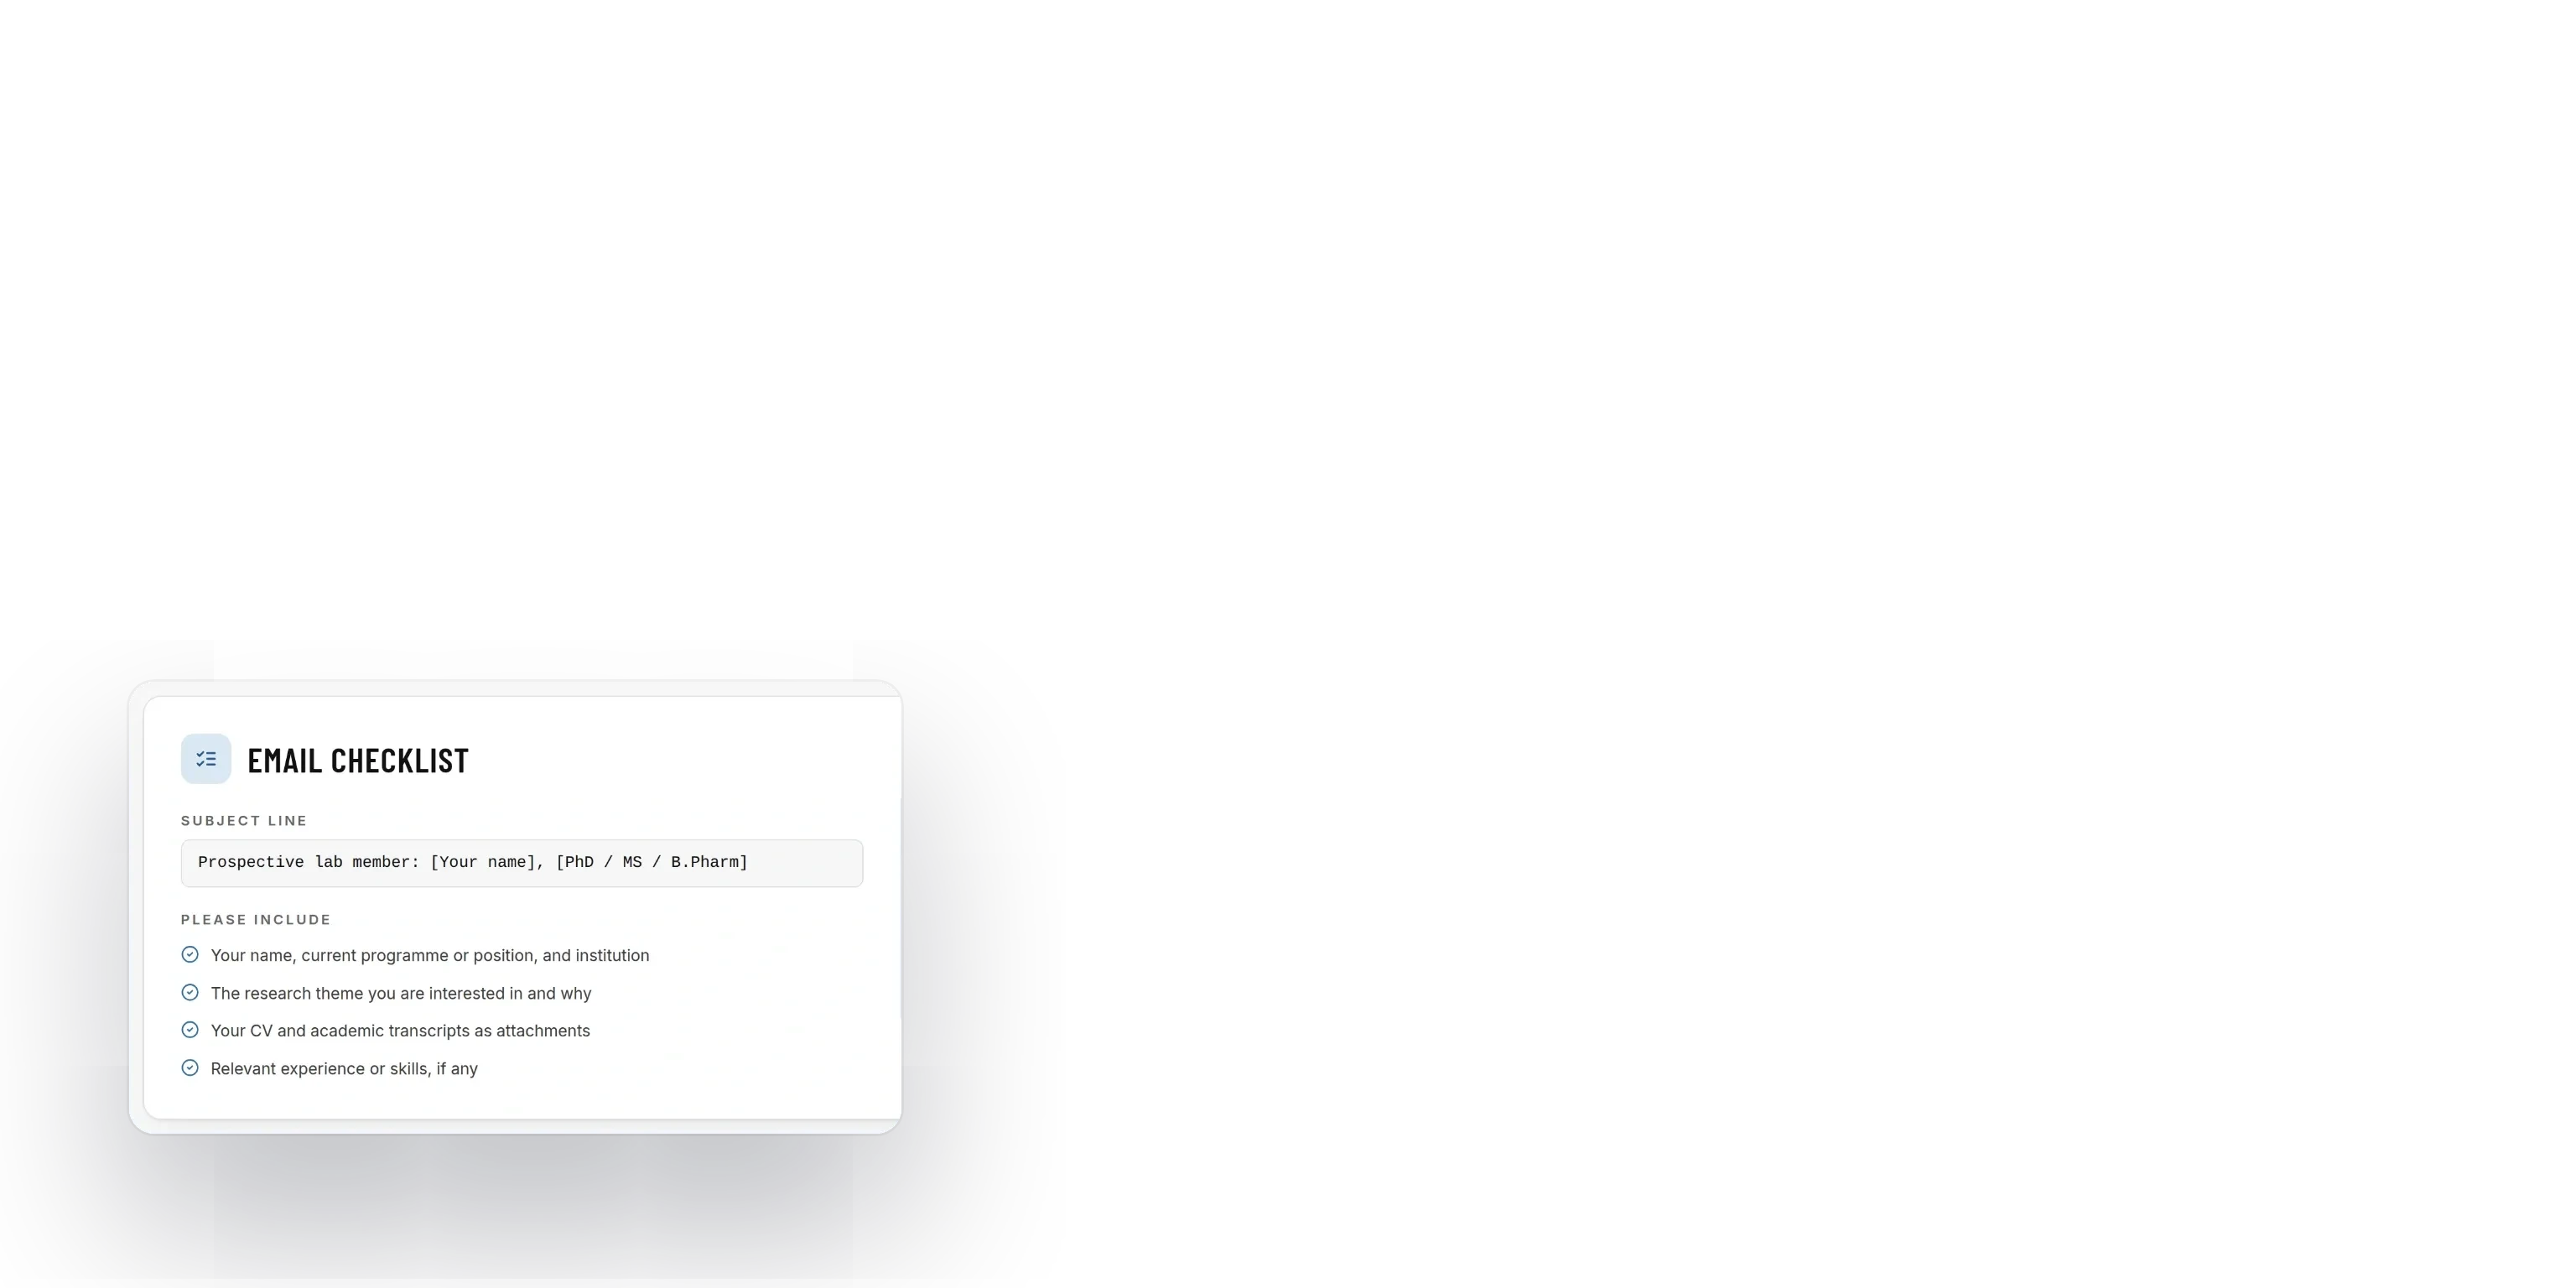
La mayoría de las consultas a un profesor llegan vacías. La página de contacto responde con cuatro vías, doctorado y MPhil, tesis de MS, proyectos de grado y colaboradores, cada una con su destinatario y los pasos en orden, y luego una lista de comprobación y un asunto que un botón deja en la app de correo. El estudiante envía CV, expediente y una pregunta de investigación en el primer mensaje y no en el tercero.
Hecha para hosting estático y para pasar a un CMS sin reescribirla
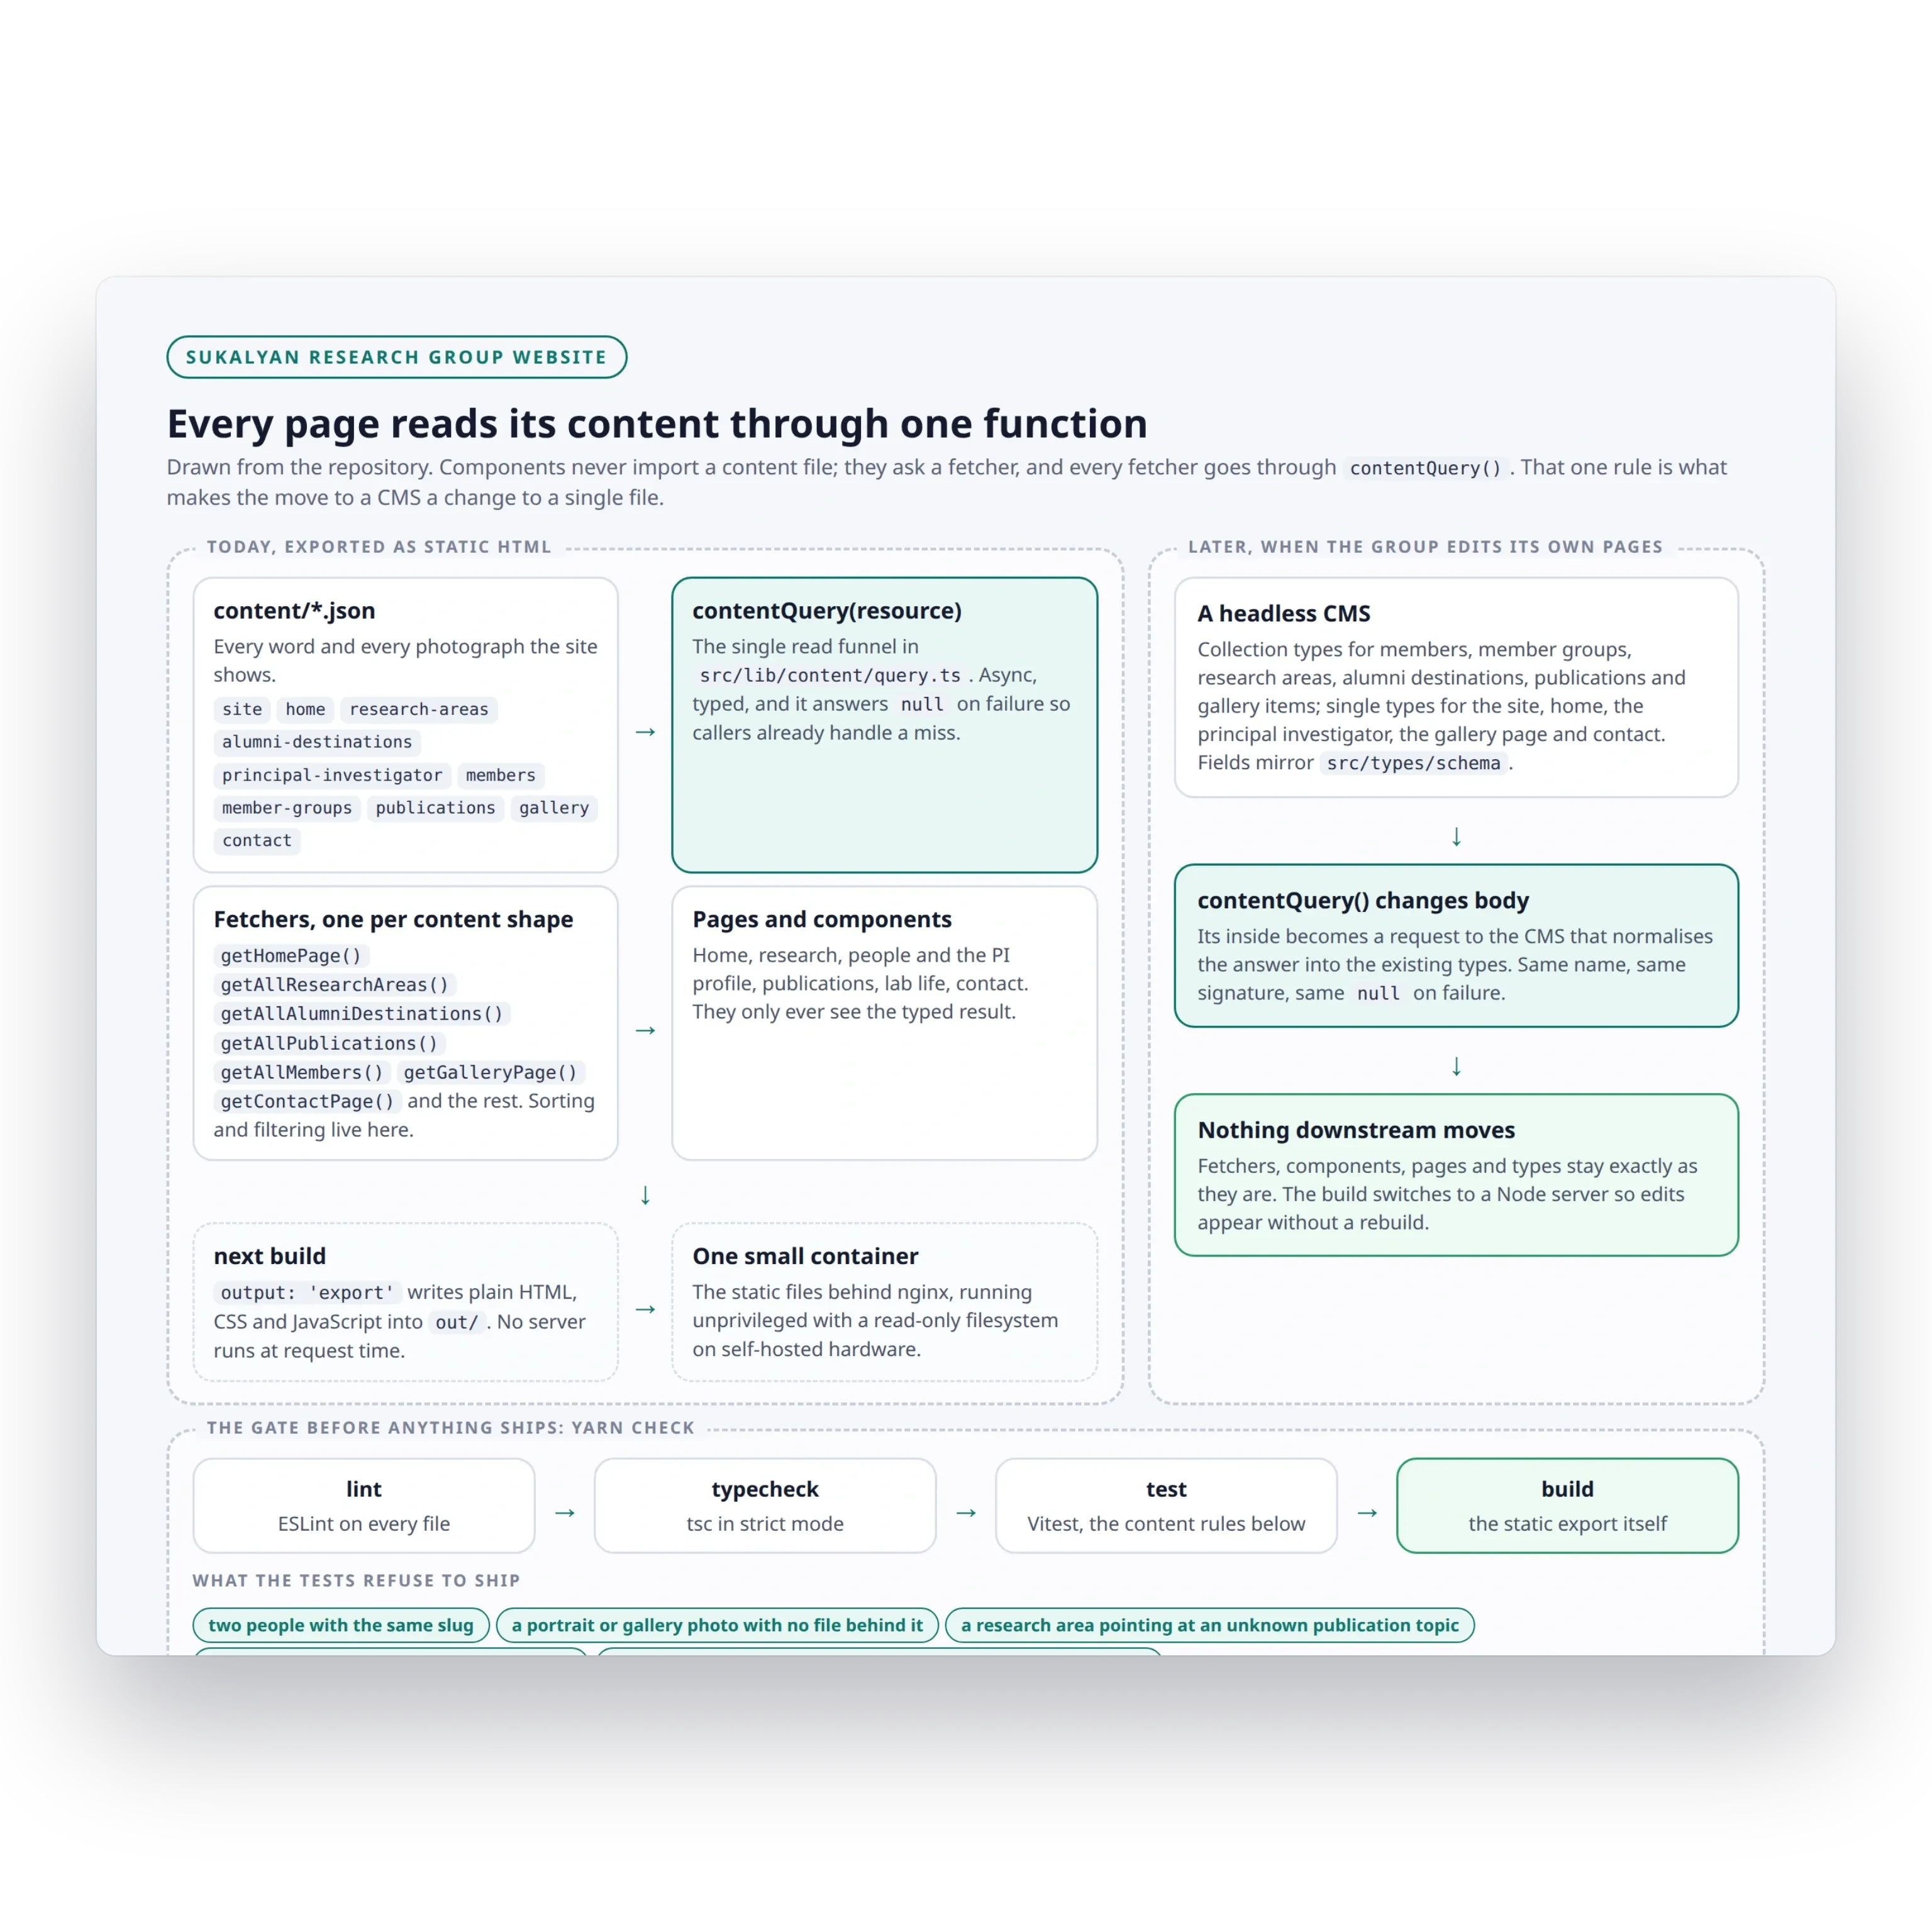
Cada palabra y cada fotografía del sitio vive en archivos de contenido detrás de una única función de consulta, y ningún componente lee el contenido directamente. Esa sola regla es lo que abarata el siguiente paso: cuando el grupo esté listo para editar sus propias páginas, la consulta se apunta a un CMS headless y las páginas, los componentes y los tipos quedan exactamente como están. Toda una ronda de cambios, la paleta, el logotipo, las tarjetas de personas, la galería, el muro de antiguos alumnos y la página de publicaciones, salió en una sola versión, y cada cambio fue un archivo de contenido o un componente; la función de consulta y el despliegue no se movieron. Hoy el sitio se exporta como HTML estático y lo sirve como archivos planos un pequeño contenedor, por eso carga al instante y mantenerlo no cuesta casi nada.
La puerta antes de publicar cualquier cosa es un único comando que ejecuta el linting, la comprobación de tipos, la batería de pruebas y una compilación. Las pruebas comprueban lo que de verdad rompe un sitio de investigación: que no haya dos personas con el mismo slug, ningún retrato ni foto de la galería que apunte a un archivo inexistente, ningún área de investigación enlazada a un tema de publicación que no exista, al menos un artículo destacado en la página de inicio, y un escaneo que hace fallar la compilación si aparece una raya en cualquier parte del código, el contenido o el README.
Lo que el grupo tiene ahora
Una sola dirección que lleva el registro completo, una investigación que un desconocido entiende en un minuto, una lista de publicaciones que resiste una lectura línea por línea, las personas que trabajan allí por nombre y retrato, las fotografías del propio grupo, y una forma de entrar que le dice a cada tipo de solicitante exactamente qué enviar. El sitio corre como un pequeño contenedor en hardware autoalojado, barato de mantener vivo y hecho para que el grupo asuma su edición cuando quiera, sin pagar dos veces por el sitio.
También te puede gustar
CoverFanz - Panel de Administración para un Marketplace de Artistas
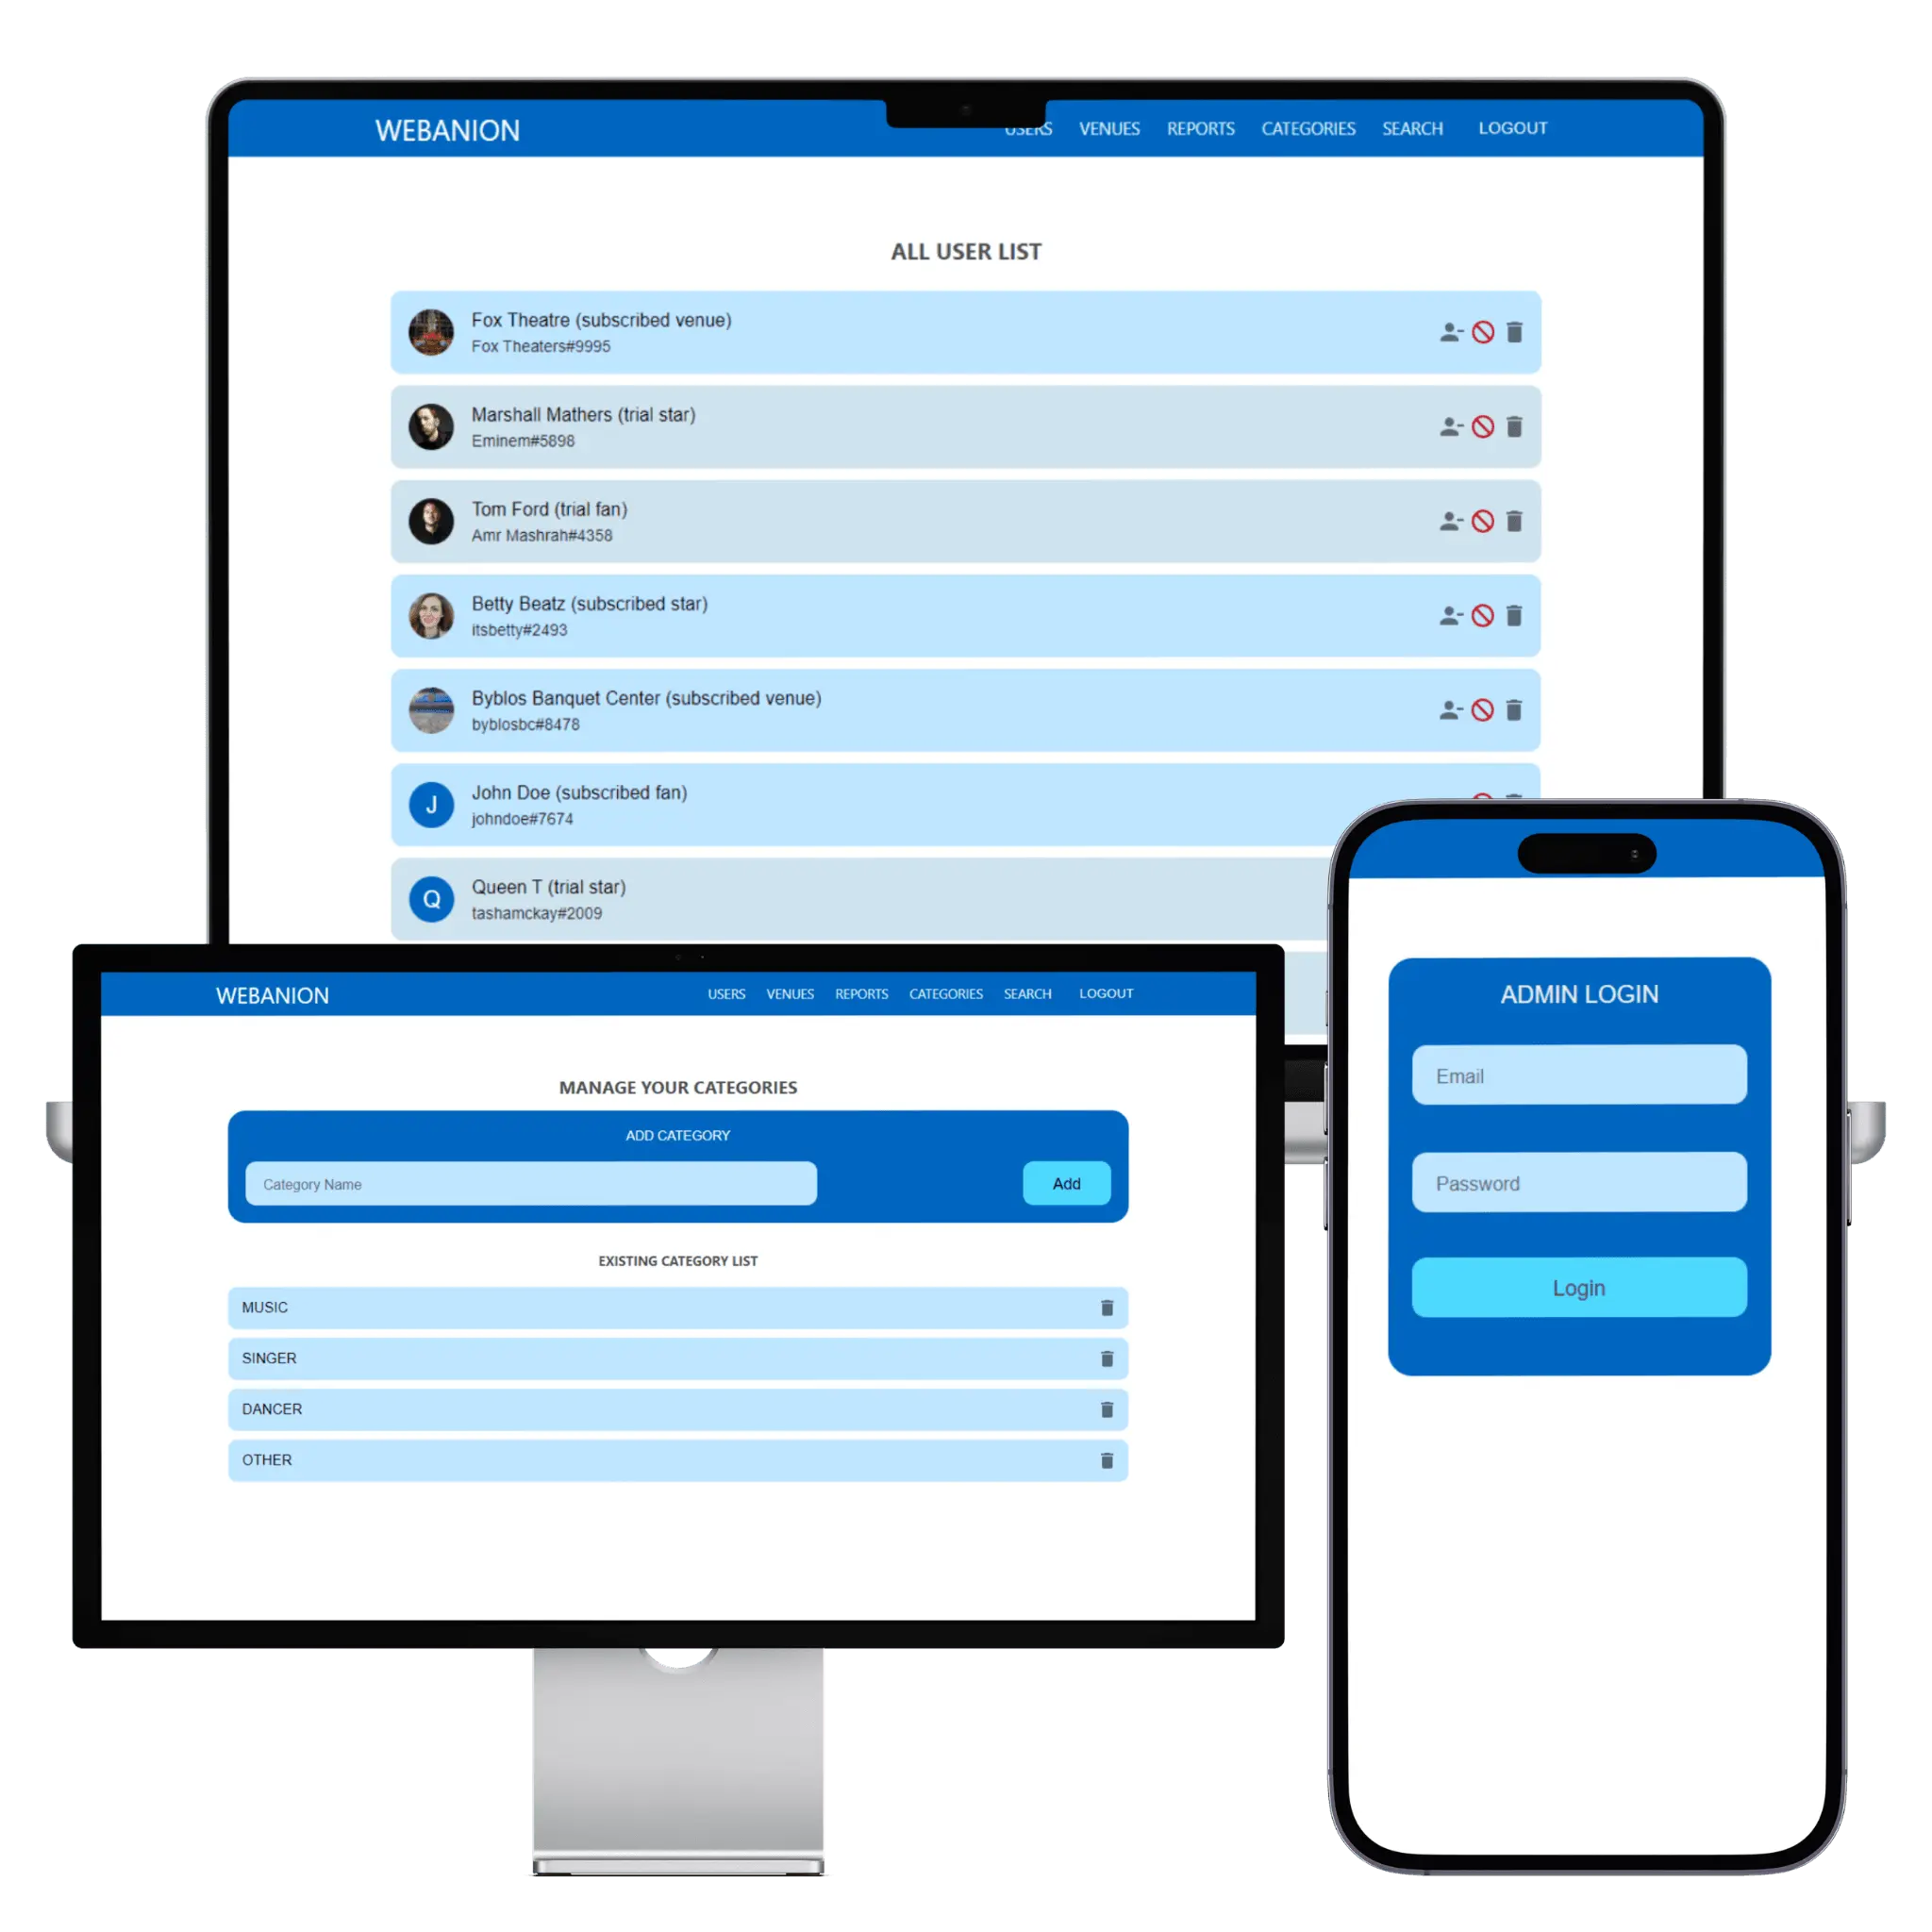
El panel de administración con el que el fundador de CoverFanz gestionó un marketplace de artistas desde el día del lanzamiento sin pedir nada a un desarrollador. Cada fan, artista y local está en una sola lista con el estado de su suscripción, los locales nuevos esperan en una cola de aprobación hasta que se comprueba su dirección, las denuncias llegan con el motivo adjunto y los tipos de actuación son una lista que controla el fundador. Se construyó en el mismo mes que las apps, sobre la misma API GraphQL.

Md Moniruzzaman
abr 29, 2022


Al-Insaf - Plataforma de Finanzas Cooperativas con Libro Mayor y Préstamos
Una organización de finanzas cooperativas llevaba los registros de socios, los ahorros, los préstamos y el capital de los inversores entre papel y hojas de cálculo, sin forma de auditar una sucursal ni de cerrar el día con limpieza. Construimos un único sistema que lo reúne todo: registro de socios, cobros diarios, préstamos desde la solicitud hasta el desembolso, un libro mayor para varias sucursales, el capital de los inversores y un registro de auditoría que anota quién hizo qué. Los oficiales registran cada cobro en el momento en que se hace, los gerentes aprueban los préstamos y cierran el día, y el modelo de permisos decide qué puede ver y hacer cada rol en lugar de ocultar botones. Todo lo que se muestra en este caso de estudio funciona con datos de demostración precargados; los registros reales de socios nunca aparecen en el material de portafolio.
Md Moniruzzaman

Webanion - Plataforma de Portafolio con CMS Headless y Servidor MCP
Un sitio de portafolio estático no podía sostener el trabajo en cinco idiomas ni seguir el ritmo de la escritura que hay detrás, así que lo reemplazamos por una plataforma. Un CMS headless guarda cada caso de estudio, artículo y registro; un frontend en Next.js los presenta en inglés, bengalí, español, hindi y chino; y un servidor MCP expone ese mismo contenido a los asistentes de IA, de modo que un agente preguntado por este trabajo lee la fuente en lugar de adivinar a partir de un rastreo. La búsqueda, la gestión de medios, un flujo de aprobación y una capa pública de descubrimiento funcionan sobre ella. La prueba es recursiva: la página que estás leyendo la sirve el sistema que describe esta entrada.
Md Moniruzzaman
El blog son notas de campo desde producción: decisiones de arquitectura, sistemas de AI que sobrevivieron al contacto con usuarios reales e infraestructura que se paga sola. Escrito desde el trabajo, no sobre él.