
构建和部署从 GitHub 的托管 runner 搬到了家中的一个 runner 池。过去每次运行都从一台全新机器开始,发布还要等排队、等故障恢复;现在由一台构建机在线时承接每个任务,常开服务器上的备用 runner 则由一个看门狗看守,一旦拿不准,它优先保证还能继续发布。镜像进入私有容器镜像仓库,工作室的程序库进入私有 npm 仓库,两者都在自家环境内,每次运行的记录也会归档,留存时间超过 GitHub 的保留期。最慢的部署从八分二十四秒缩短到三分零五秒,CI 也快了三分之一。
Md Moniruzzaman
完整故事
托管流水线让一家企业在等待上付出了什么,以及构建、镜像和软件包搬到同一个屋檐下之后,发生了哪些变化。
流水线是别人的机器,糟糕的日子也是别人的
直到 2026 年 9 月中旬,每一次构建和部署都在 GitHub 的托管 runner 上运行,而托管 runner 每次都是一台全新的虚拟机:哪怕只改一行代码,基础镜像、每个依赖和每一层构建都要重新下载,用完即弃。之后,镜像还要在常开的生产服务器上构建,因为结果只能在那里运行,于是承载数据库和公开站点的那台机器,同时还在编译。最慢的一次部署中位耗时八分二十四秒,几乎全花在构建上;合并一个接一个地排队;一次发布还可能因为某个依赖下载超时而失败,而这种失败与代码毫无关系。就连记录也留不住:GitHub 默认只保留九十天的工作流日志。
底层服务这一年也过得不轻松。2 月 2 日,GitHub 报告其托管 runner 不可用,任务在排队等待中超时:“Actions jobs queued and timed out while waiting to acquire a hosted runner”(事件记录)。3 月 5 日,百分之九十五的工作流运行未能按时启动:“failed to start within 5 minutes with an average delay of 30 minutes”(事件记录)。7 月 9 日,约十个小时里,任务启动延迟或干脆失败:Actions “experienced delayed and failed job starts on GitHub-hosted runners”(事件记录)。8 月 26 日,任务无法启动,“Actions jobs failed to start”,此后两个小时里,运行启动延迟超过五分钟:“were delayed starting by more than 5 minutes as the system caught up with delayed load”(事件记录)。9 月 13 日,GitHub 报告包括 Actions 在内的约 28 项服务可用性下降:“degraded availability across approximately 28 services, including Issues, Pull Requests, Actions”(事件记录)。按其状态页面统计,1 月到 9 月之间,有五十多起事件波及 Actions。代码仓库、代码评审和工作流定义都还留在 GitHub;搬走的只是运行这些工作的机器,以及那台机器一直在下载又丢弃的一切。
部署从八分钟缩短到三分钟,有实测为证
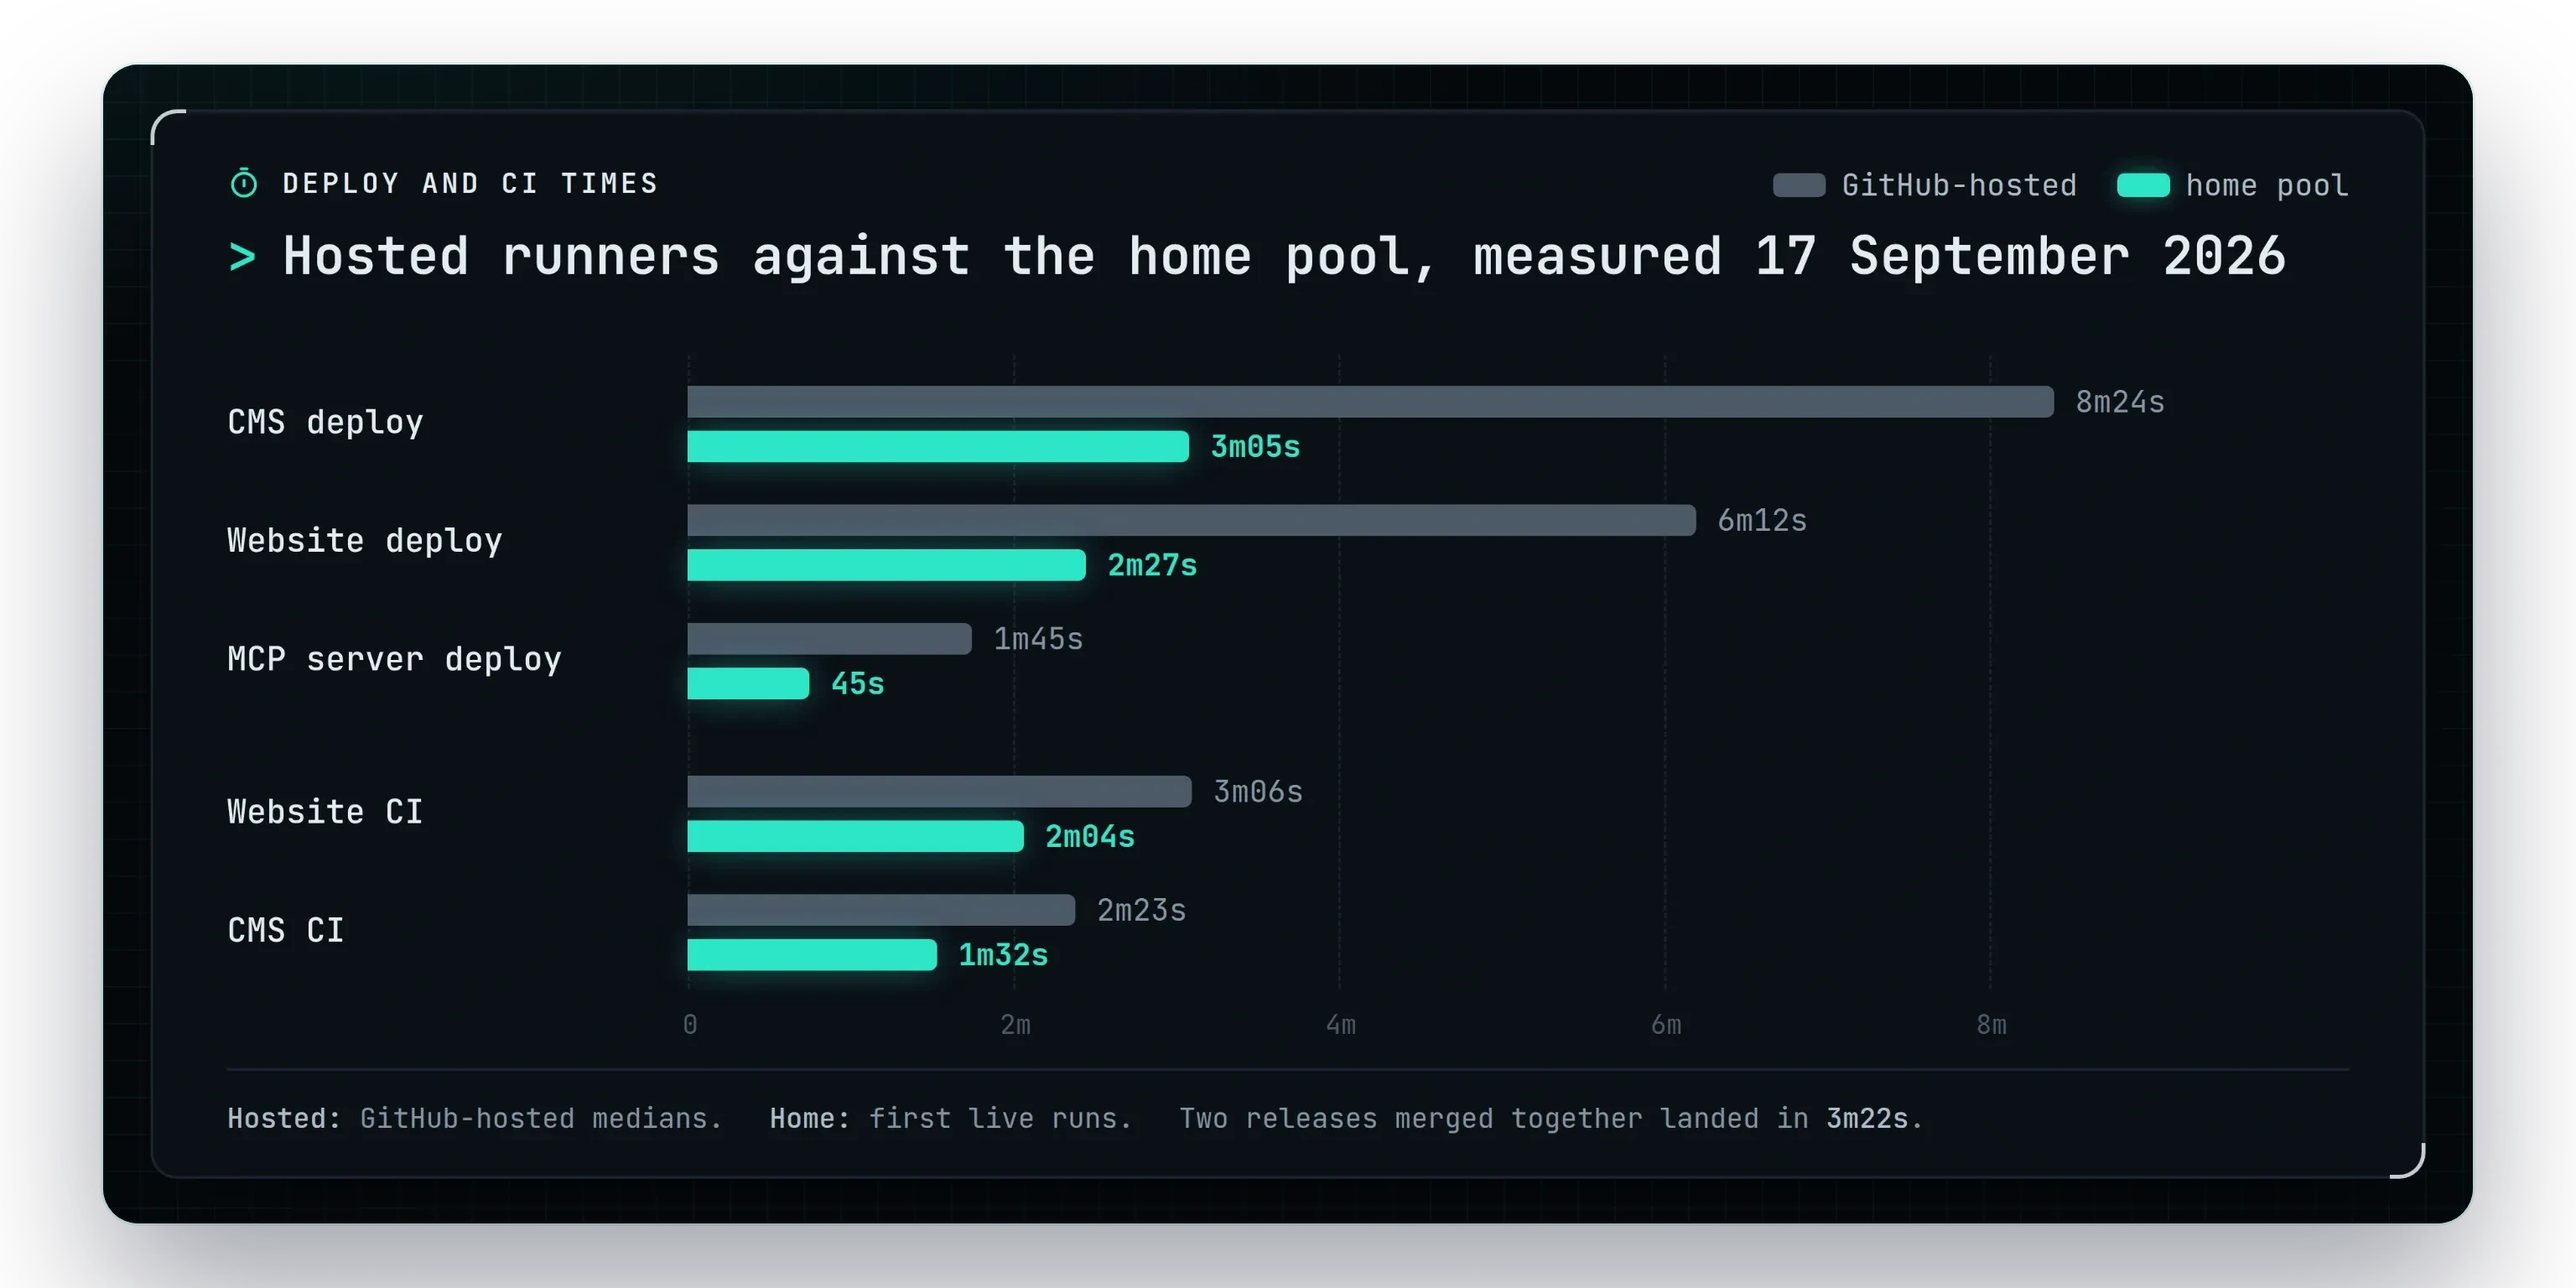
9 月 17 日对照托管环境的中位数实测:CMS 的部署从 8 分 24 秒降到 3 分 05 秒,网站从 6 分 12 秒降到 2 分 27 秒,MCP 服务器从 1 分 45 秒降到 45 秒。两次一起合并的发布在 3 分 22 秒的实际时间内全部上线,三个服务同时运行 CI 时也快了三分之一。
每次运行,都在构建了上一次的那台机器上
托管 runner 每次都是一台全新的机器。家中的 runner 池每个任务用的都是同样的机器,所以镜像层和软件包缓存早已就位,镜像在送往集群的路上从不经过互联网,构建也在专为构建准备的机器上运行,而不是在承载站点的那台上。同一次构建,冷缓存耗时 528 秒,热缓存只要 192 秒。家中最初的几次运行慢了三倍,直到去掉了一个步骤:每次构建都通过家庭网络把依赖缓存上传回 GitHub,网站光这一步就要 411 秒。当 runner 是别人的机器时,这样做有道理;当缓存本来就放在下一次构建运行的地方时,就毫无意义。
Runs 视图列出每个受监视仓库的每一次运行,并在运行结束时逐一归档,因此它比 GitHub 的保留期留存得更久。截图当天,它显示了 49 秒、3 分 15 秒和 2 分 51 秒的部署,以及两到三分钟的 CI 运行,失败记录也一目了然:同一次部署失败了两次,第三次才通过。
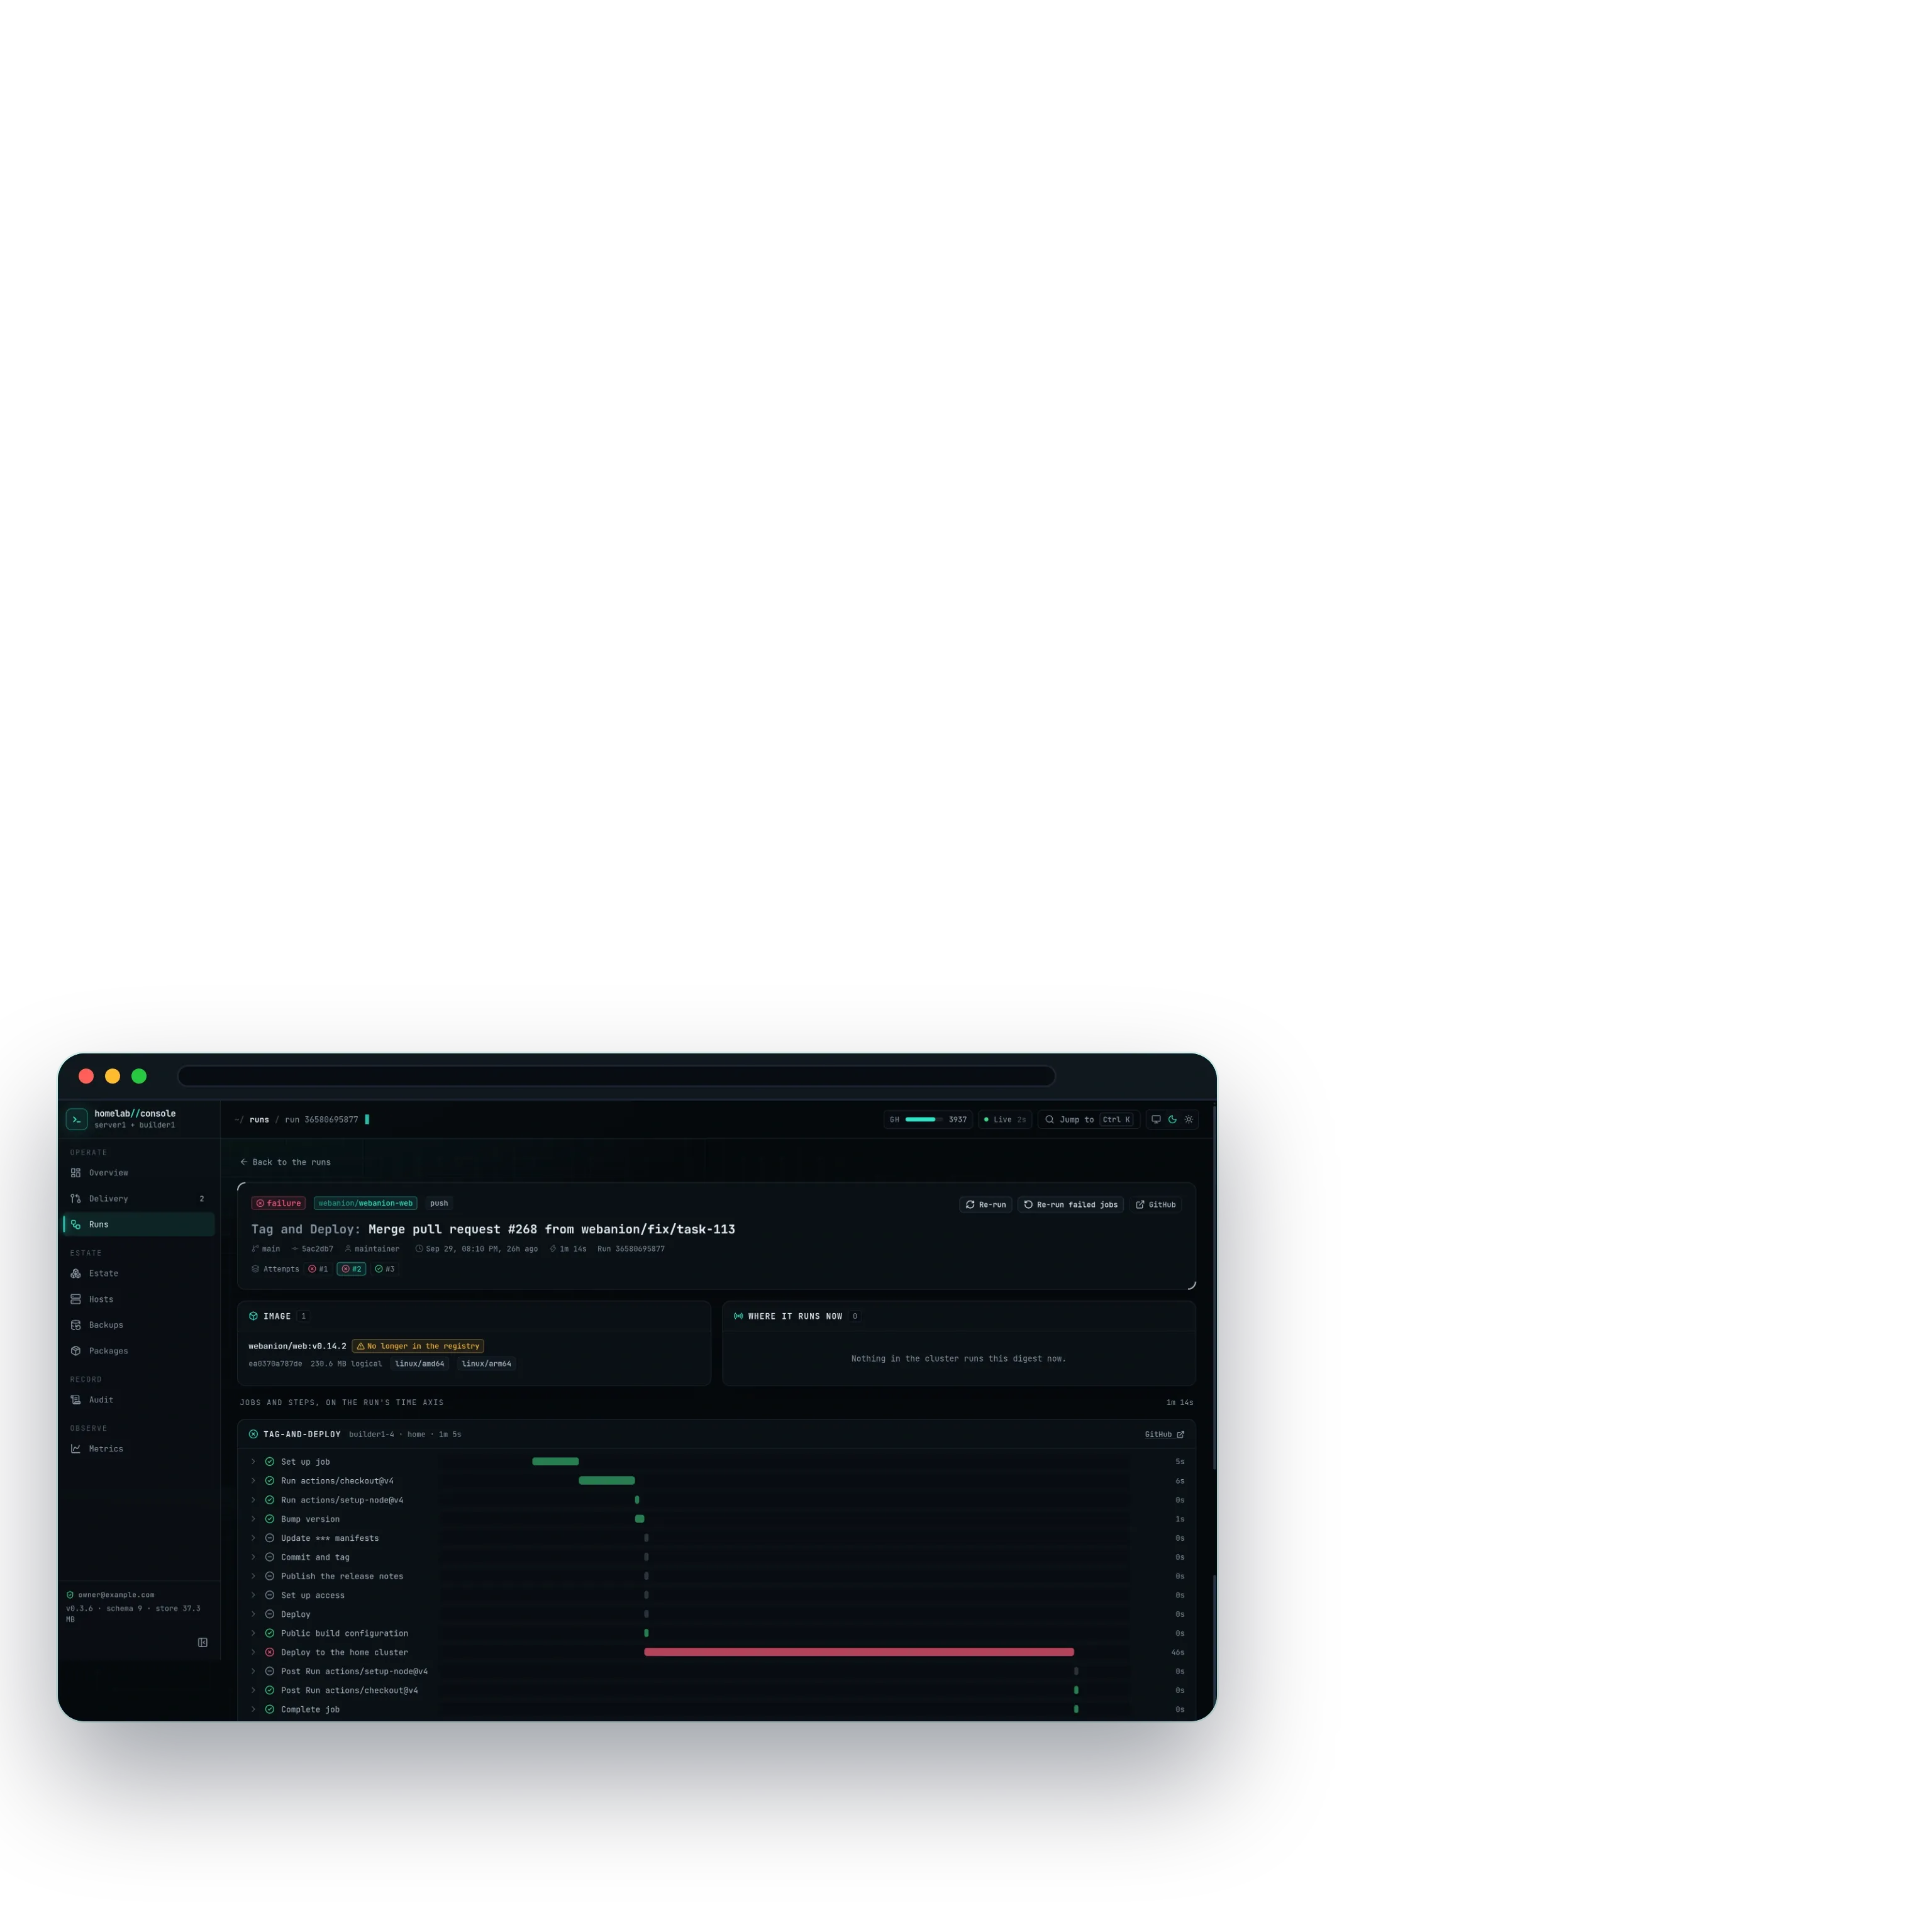
一次部署,按步骤展开在它自己的时间轴上
打开一次运行,每个任务和步骤都排在这次运行自己的时间轴上,时间取自 GitHub 的时间戳;旁边是这次运行推送的镜像,附带它的 digest、大小和平台,以及这个镜像现在在哪里运行。重试会被保留,而不是被覆盖:截图里的部署前两次尝试失败,第三次通过,每次尝试都能单独打开,第二次显示部署步骤在四十六秒后失败,因此修复之后,失败的原因依然有据可查。
通过的那次尝试展示了家中 runner 池上的时间花在哪里:检出代码和升级版本号只要几秒,构建并部署到集群用了略少于两分半钟。它还展示了控制台能说明、而 CI 日志说明不了的事:这个镜像已经不在镜像仓库里了,因为保留策略只留下最近的构建,集群里也已经没有任何东西在运行这个 digest。

构建机离开时,工作照样完成
runner 池有一个主用和一个备用。构建机在线时,它的 runner 承接每一个任务;常开服务器上则保留着备用 runner,只有当看门狗判断构建机已经离开时才会启动。看门狗要在不止一次检查失败之后才判定这台机器下线,也要在不止一次检查通过之后才判定它回来,因此一次短暂的网络抖动永远不会让任何东西来回切换,交接在两个方向上都能在一两分钟内完成。它从不把任务拦腰截断:关机会等正在运行的任务结束,备用 runner 也只在空闲时才退下。
如果看门狗根本连不上 GitHub,它照样会启动备用 runner,因为一次让部署停摆的监控故障,比它要盯防的那次中断更糟。控制台总览上的 runner 池面板会显示由哪一侧承接任务,以及哪些备用 runner 已经就绪。

镜像和软件包,都在同一个屋檐下提供
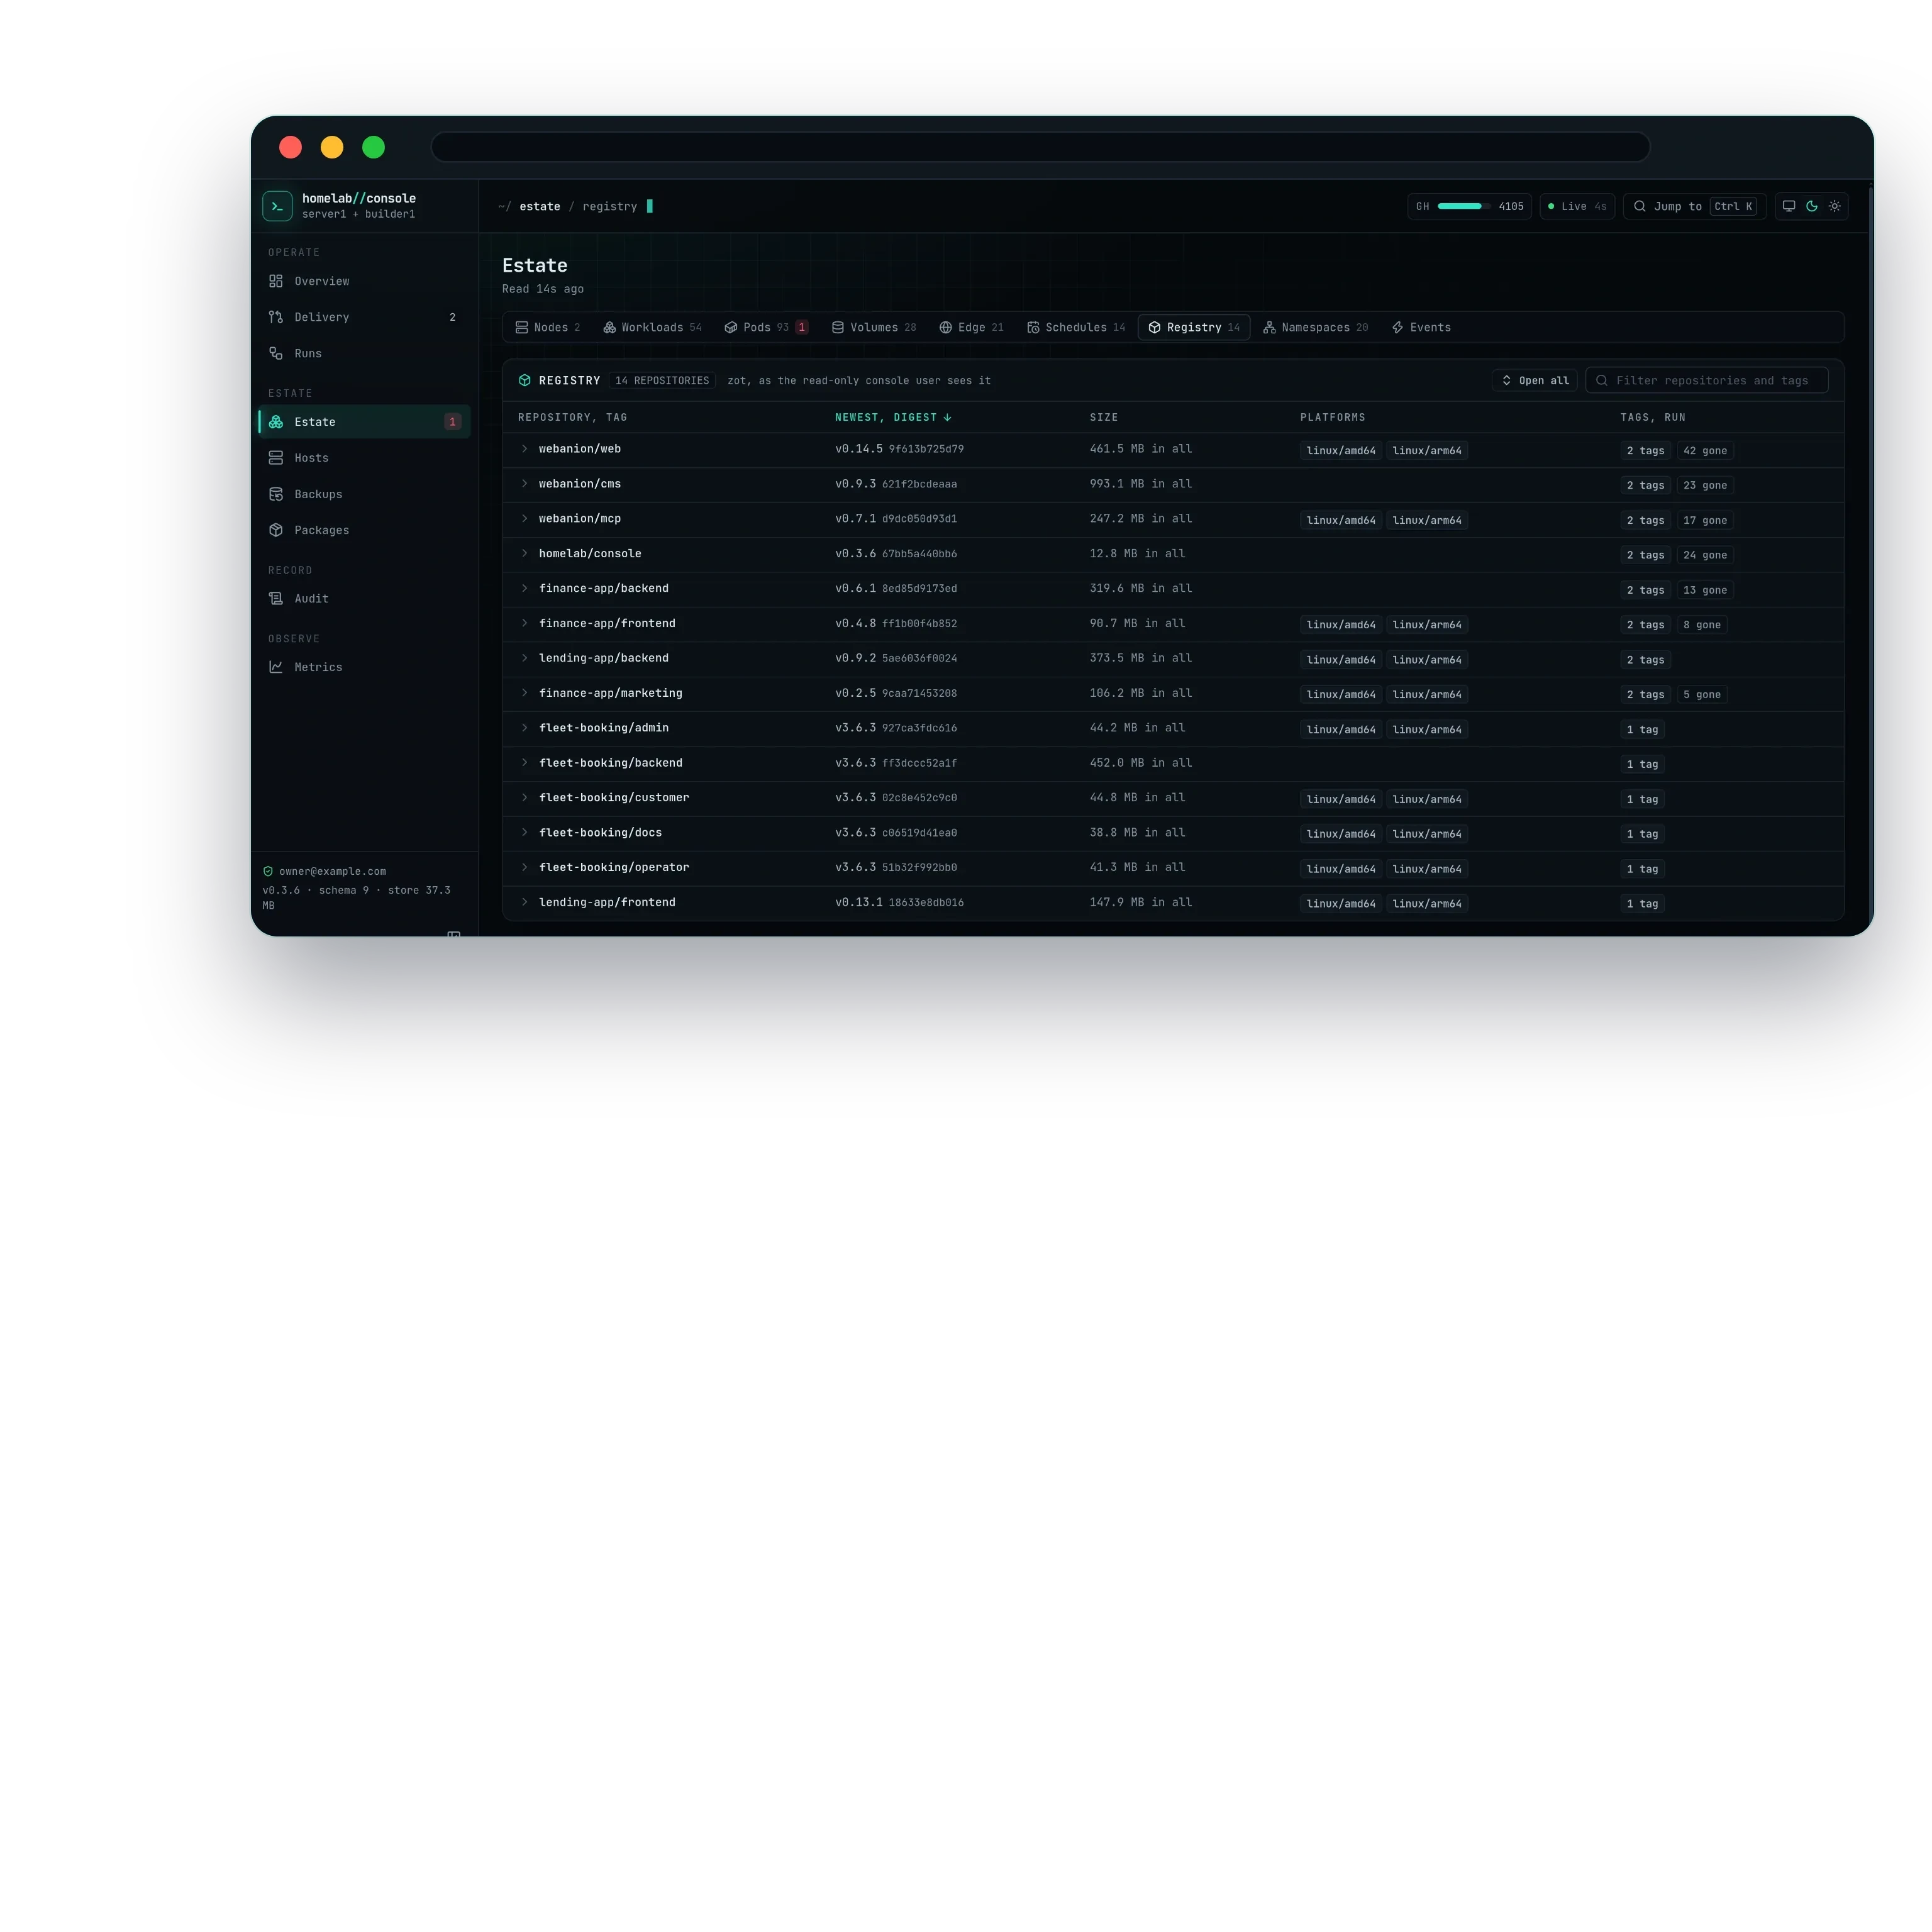
一个容器镜像仓库和一个 npm 仓库在常开服务器上并行运行,因为容器镜像和 npm 软件包使用的协议毫无共通之处。容器镜像仓库通过局域网接收 runner 池构建的每一个镜像:只有一个账号可以推送,所有拉取方都用只读账号,不允许匿名访问;同一个标签可以同时包含两种处理器架构,让每个节点拉取与自己匹配的构建。保留策略为每个服务留下最近的两个构建,外加最后一次被拉取的那个,这就是回滚窗口,它是明确写下来的,而不是想当然。
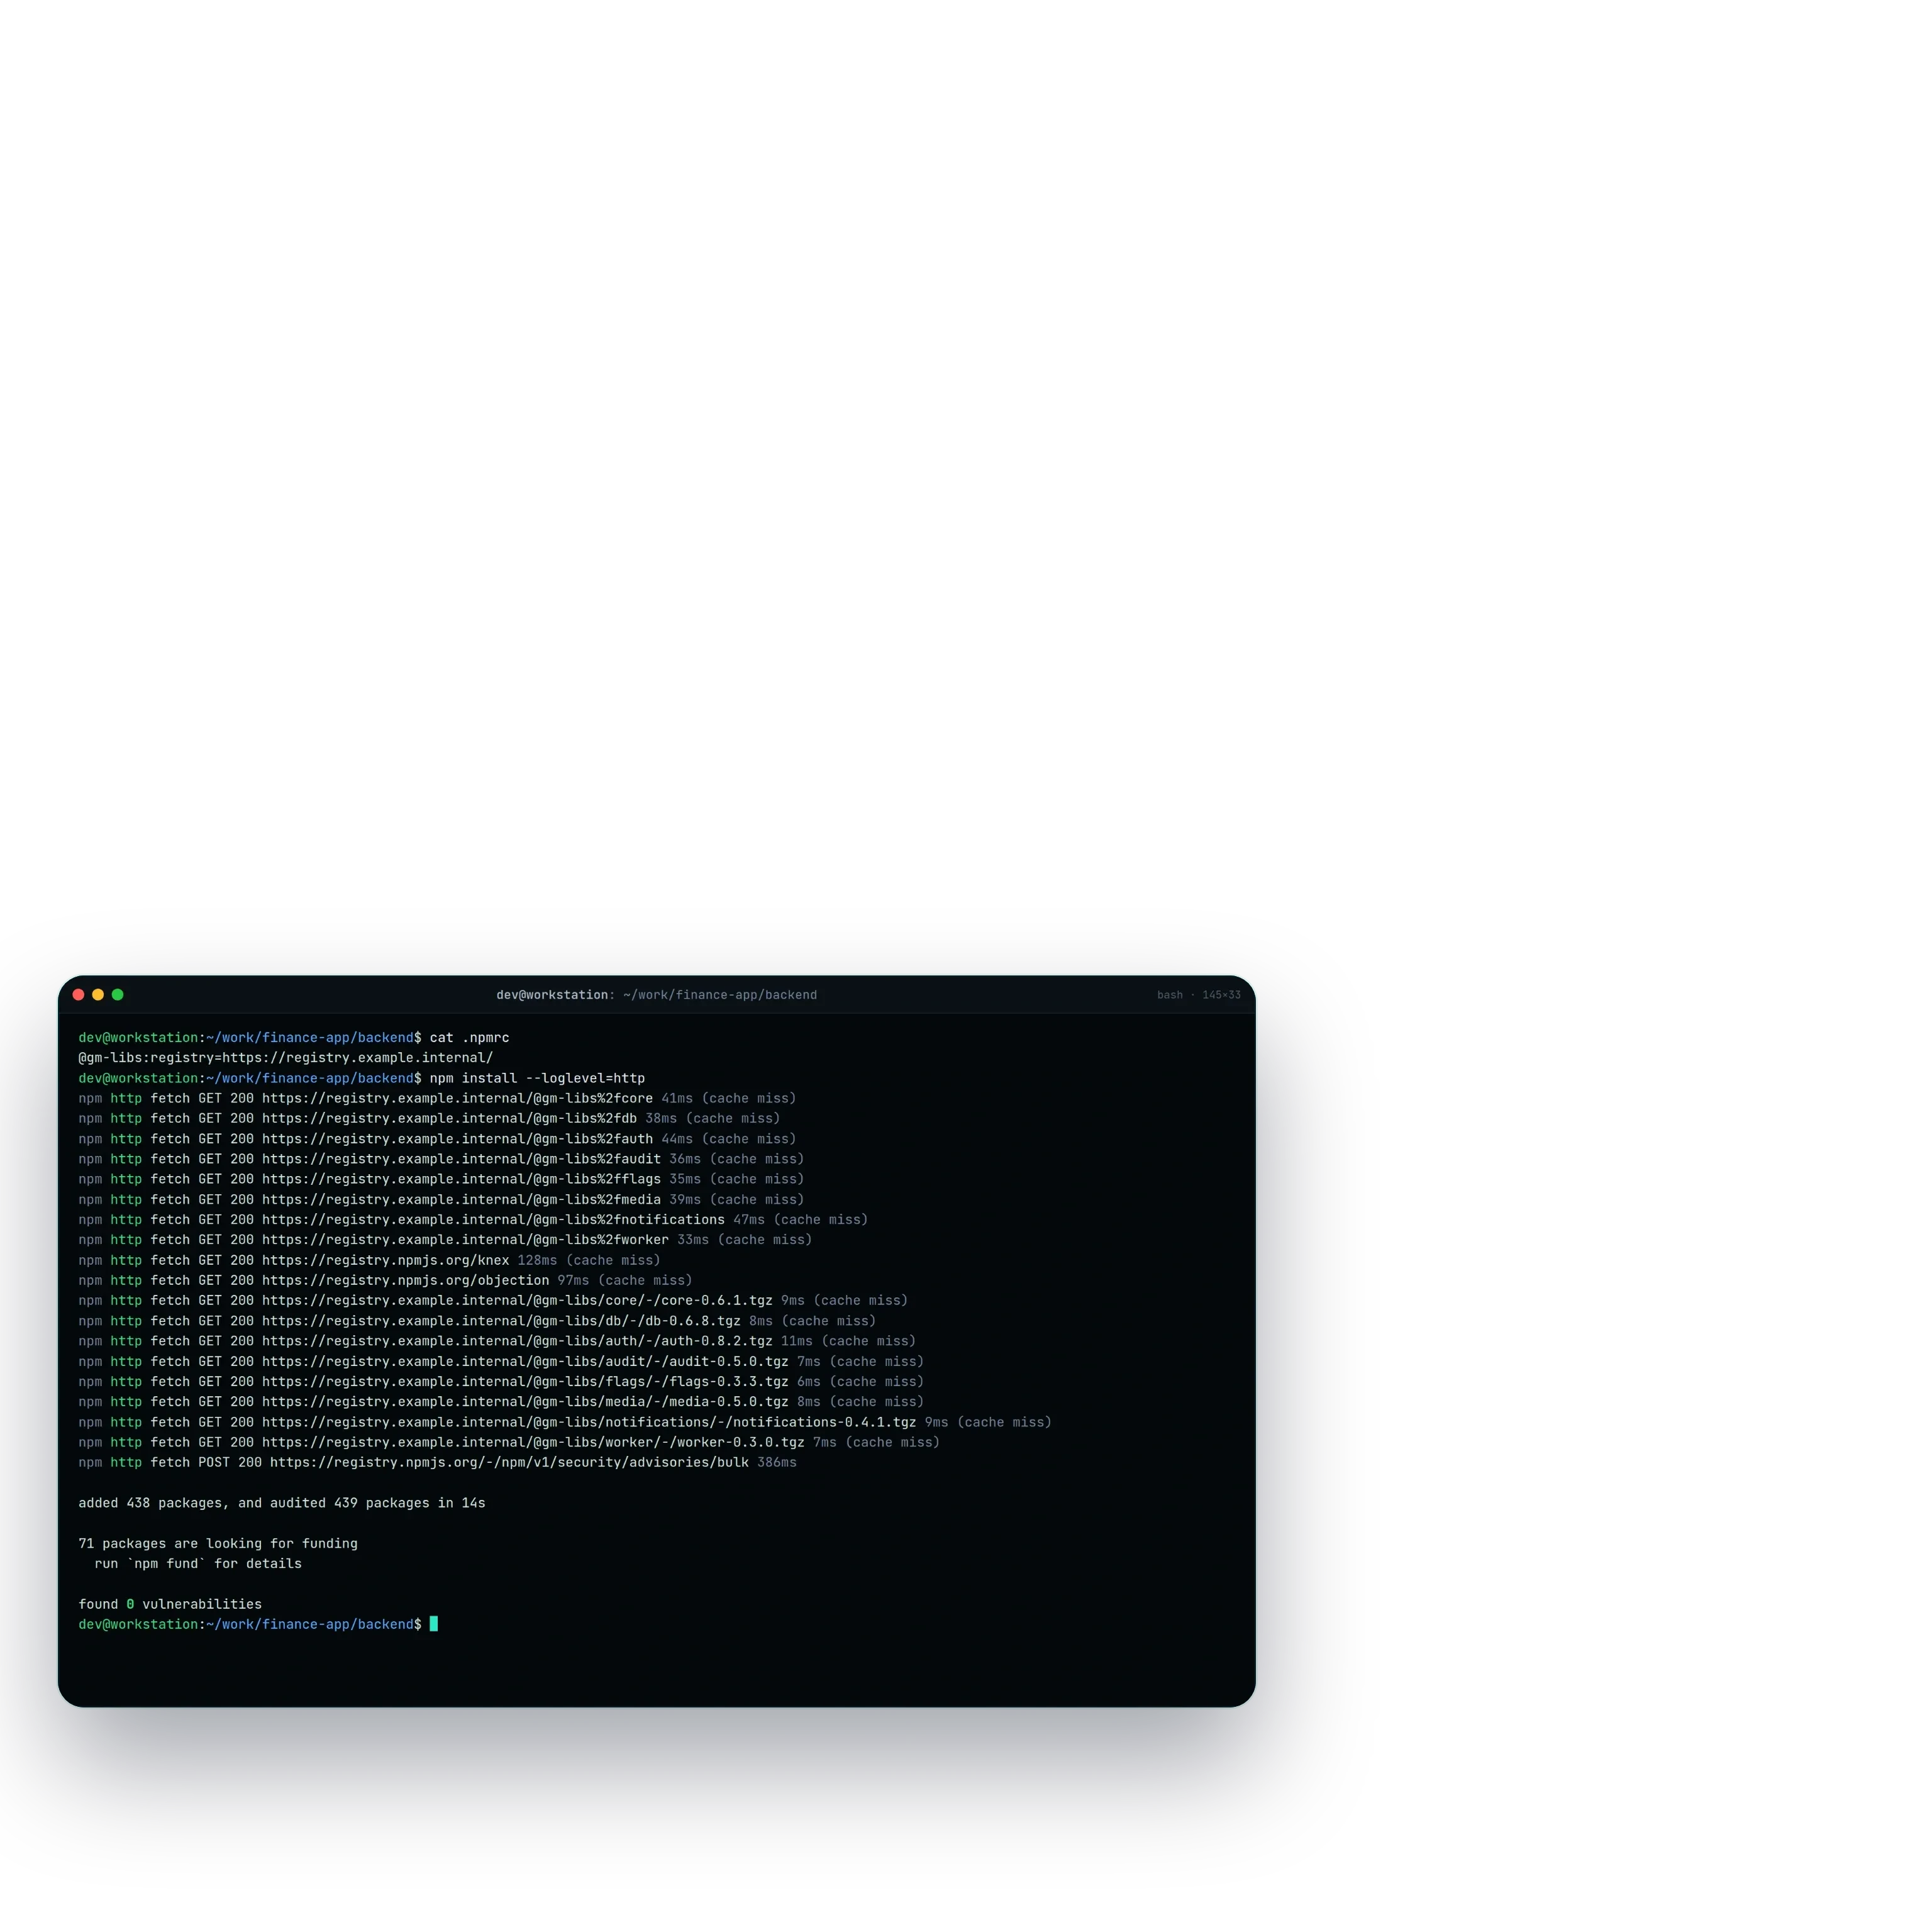
npm 仓库提供工作室自己的程序库家族。每个程序库的发布版本,都由集群内部的一个同步任务每五分钟从它的 GitHub Release 逐字节发布进来;每次读取都需要登录,公开名称拒绝写入,每晚还有一个任务把每个已发布版本与对应的发布逐一比对。这些仓库都没有自己的界面,所以控制台就是它们的屏幕:Estate 视图列出容器镜像仓库里的各个镜像库及其大小和平台,任何使用这些程序库的项目,安装时也都在自家屋檐下完成解析。
从一次合并到一个运行中的 Pod,以及一行就能退回
一次合并会把构建排进 runner 池,镜像通过局域网送进镜像仓库,部署则以一个仅限一个 namespace 的身份运行,没有删除权限,只有一个指定的 secret。每个节点拉取与自己匹配的构建,而每个仓库的一个变量,就能让某个服务在下一次 push 时回到托管 runner 上。


它给工作周带来了什么,以及适合谁来做
合并不再相互等待:构建机在线时,多个发布可以并排构建和部署;在备用 runner 上,一把锁让繁重的步骤逐个执行,互不冲突。一次修复大约三分钟就能上线,而不是八分钟;常开服务器只在构建机不在时才编译;GitHub 删除记录之后,每次运行的记录仍留在自家屋檐下。代码仓库、代码评审和工作流定义都留在 GitHub;搬走的只有机器、缓存、镜像和软件包。
局限先说在前面:构建进行到一半时停电,这次构建就会失败,需要重新运行。对于发布已经开始排队的团队,对于代码和镜像不应离开自家环境的人,对于眼看着一个修复在别人的队列里干等的创始人,这是正确的一步。对于没有人负责这些机器的团队,这是错误的一步,这一点值得说清楚。底层的集群是一个节点变成集群的故事,围绕它的平台是支撑整个工作室的自托管家庭实验室,而同样的方法用在一个客户的平台上,就是零停机迁移到自托管 Kubernetes。
你可能也喜欢
27 Pearls:移动发布和商店提交
一款已完成的 27 Pearls 应用,在为期一周的合作中成为 App Store 和 Google Play 上获批的商店页面,没有经历任何一轮拒审。这一周包括发布构建与签名、围绕学生收益撰写的商店文案、覆盖每种必需设备尺寸的截图、与应用实际收集的数据相符的隐私声明,以及一个可用的审核账号。这款应用至今仍在 Google Play 上。

Md Moniruzzaman
5月 05, 2023



一个节点变成了集群,没有任何应用需要改动
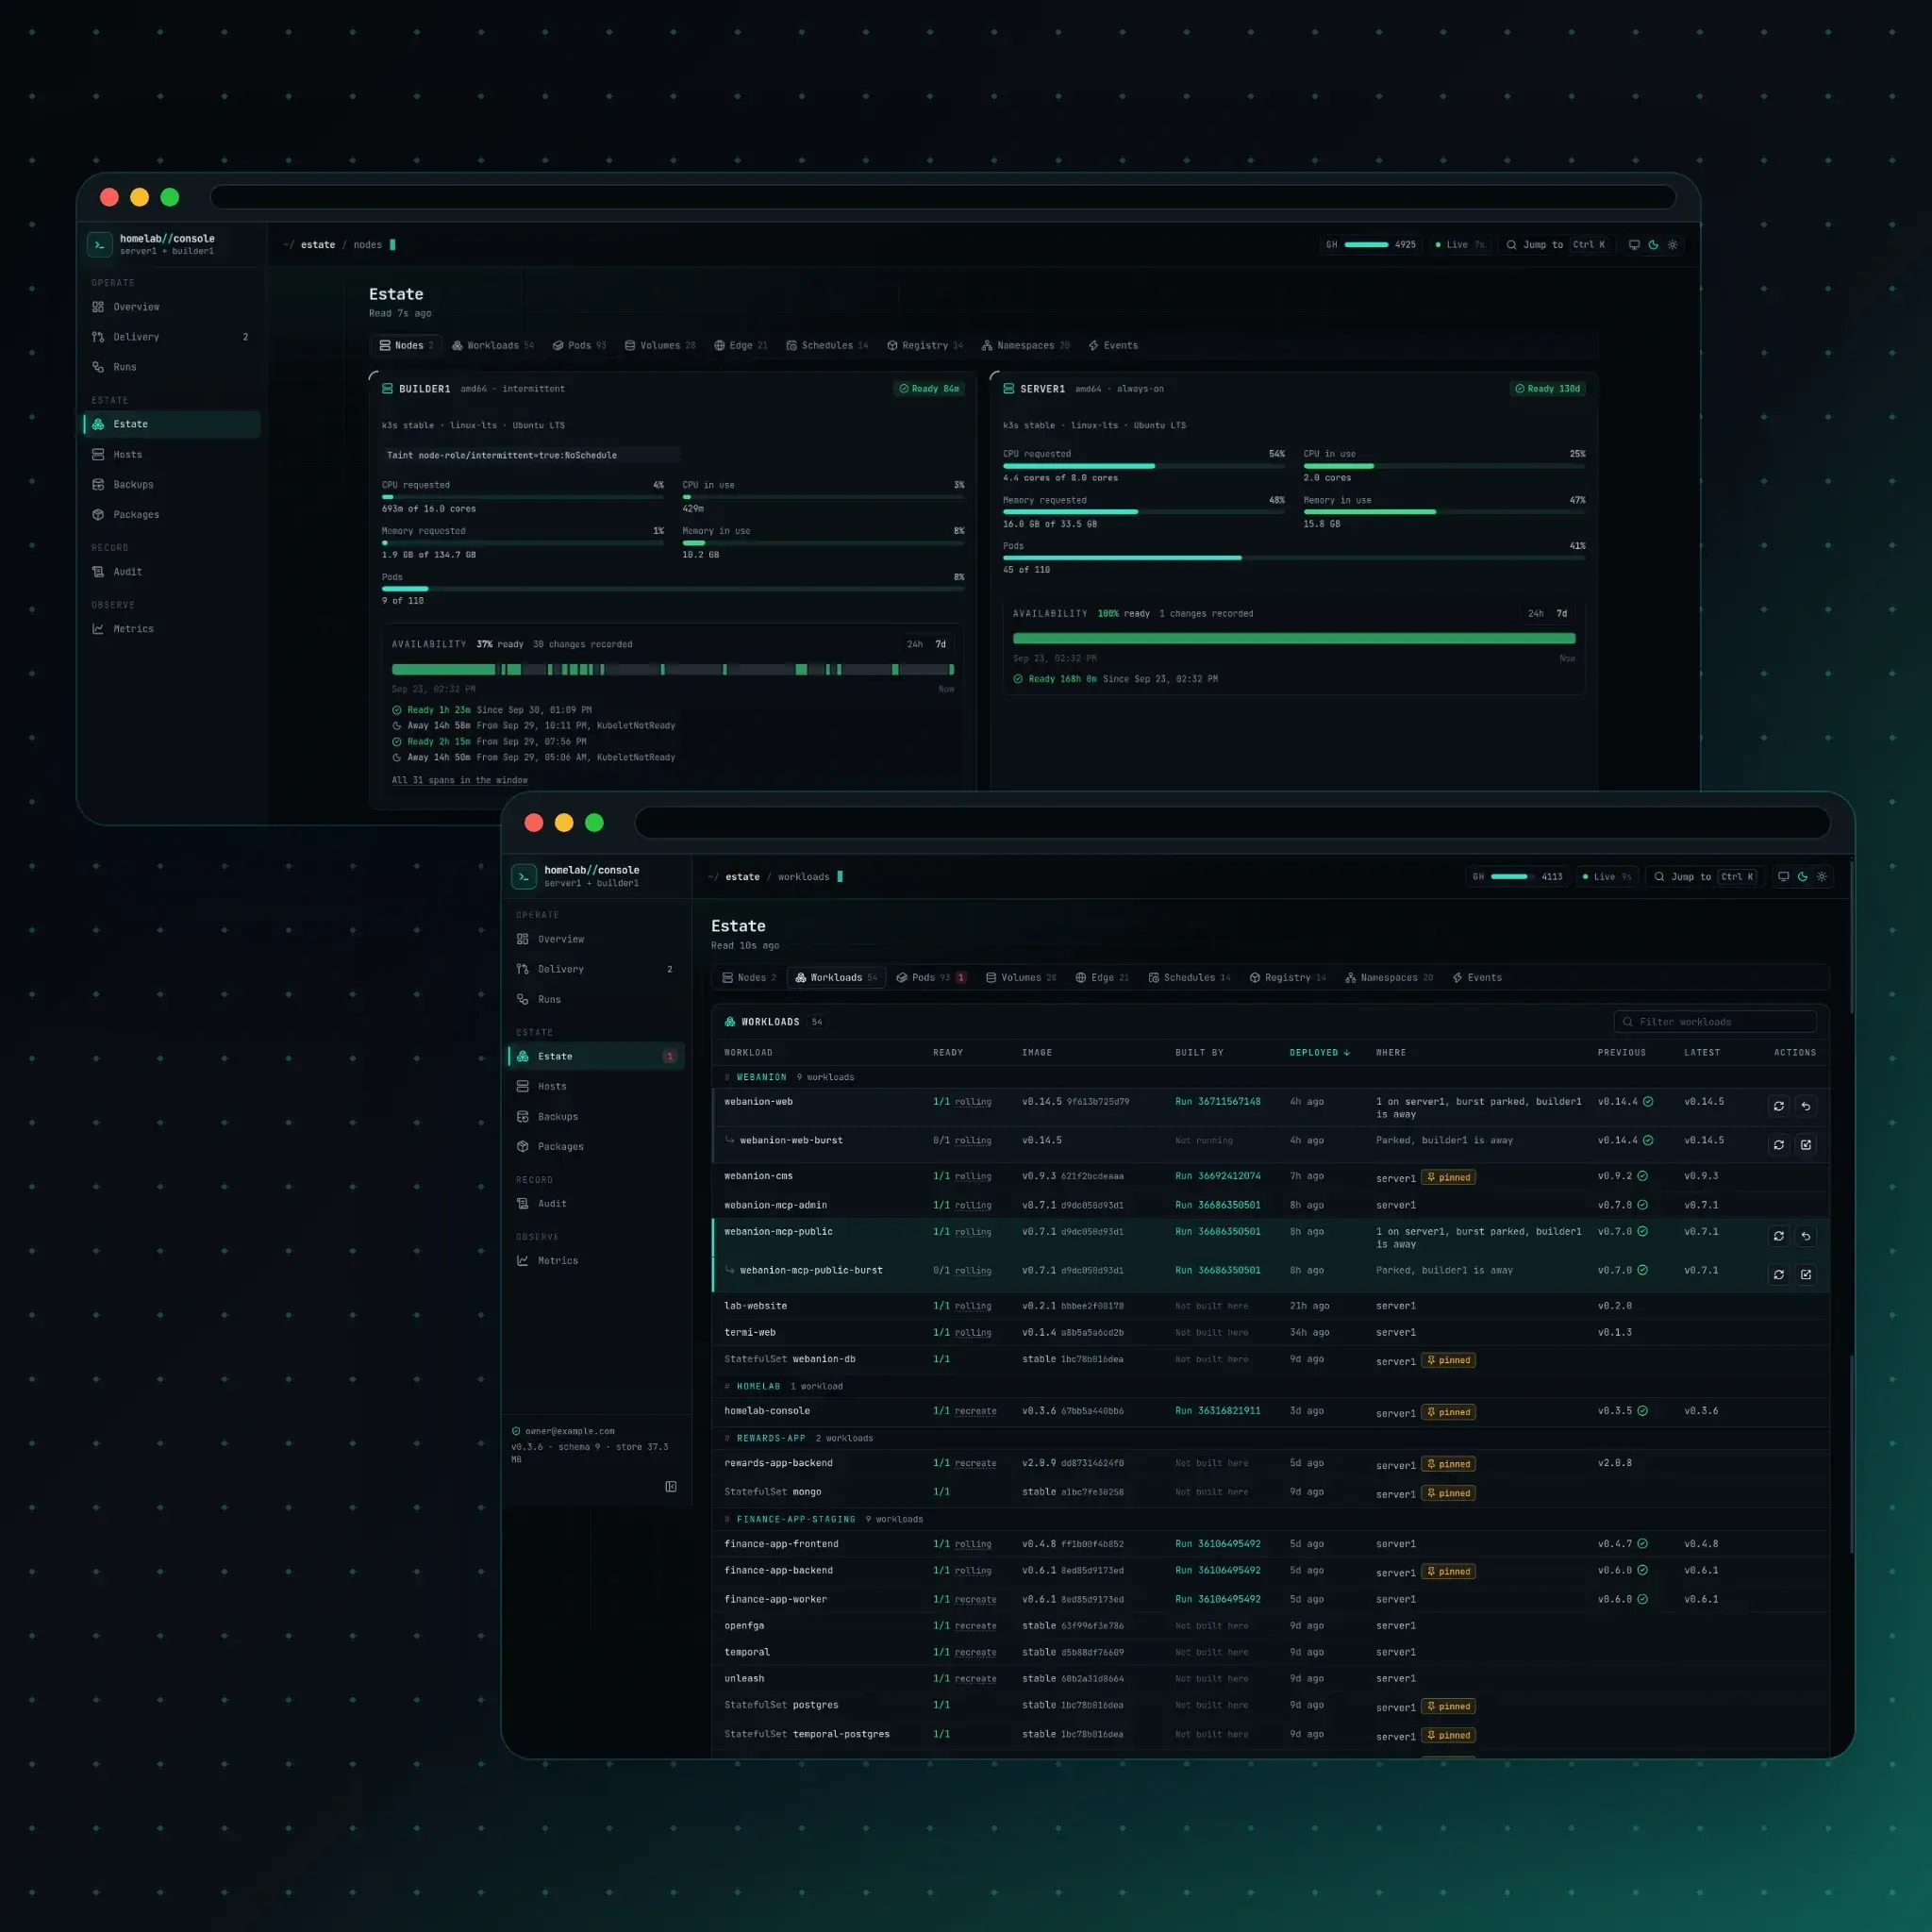
第二台可随时关机的机器加入了一个正在运行的单节点集群,没有改动任何应用。常开服务器保存控制平面、每个数据库和卷以及每个服务的第一个副本;构建机在 taint 之后承担构建任务和无状态服务的第二个副本,它休眠时这些副本会等待,而不是退回常开服务器。工作结束时它自行关机,有任务进入队列时再回来;一个控制台展示每个节点、每个工作负载和每段可用时间;常开服务器上的每一项 CPU request 都经过测量,使其预留从可分配量的 84% 降到 56%。
Md Moniruzzaman
9月 22, 2026
博客是来自生产一线的笔记:架构决策、经受住真实用户考验的 AI 系统、能自己挣回成本的基础设施。写于工作之中,而不是隔岸观火。