
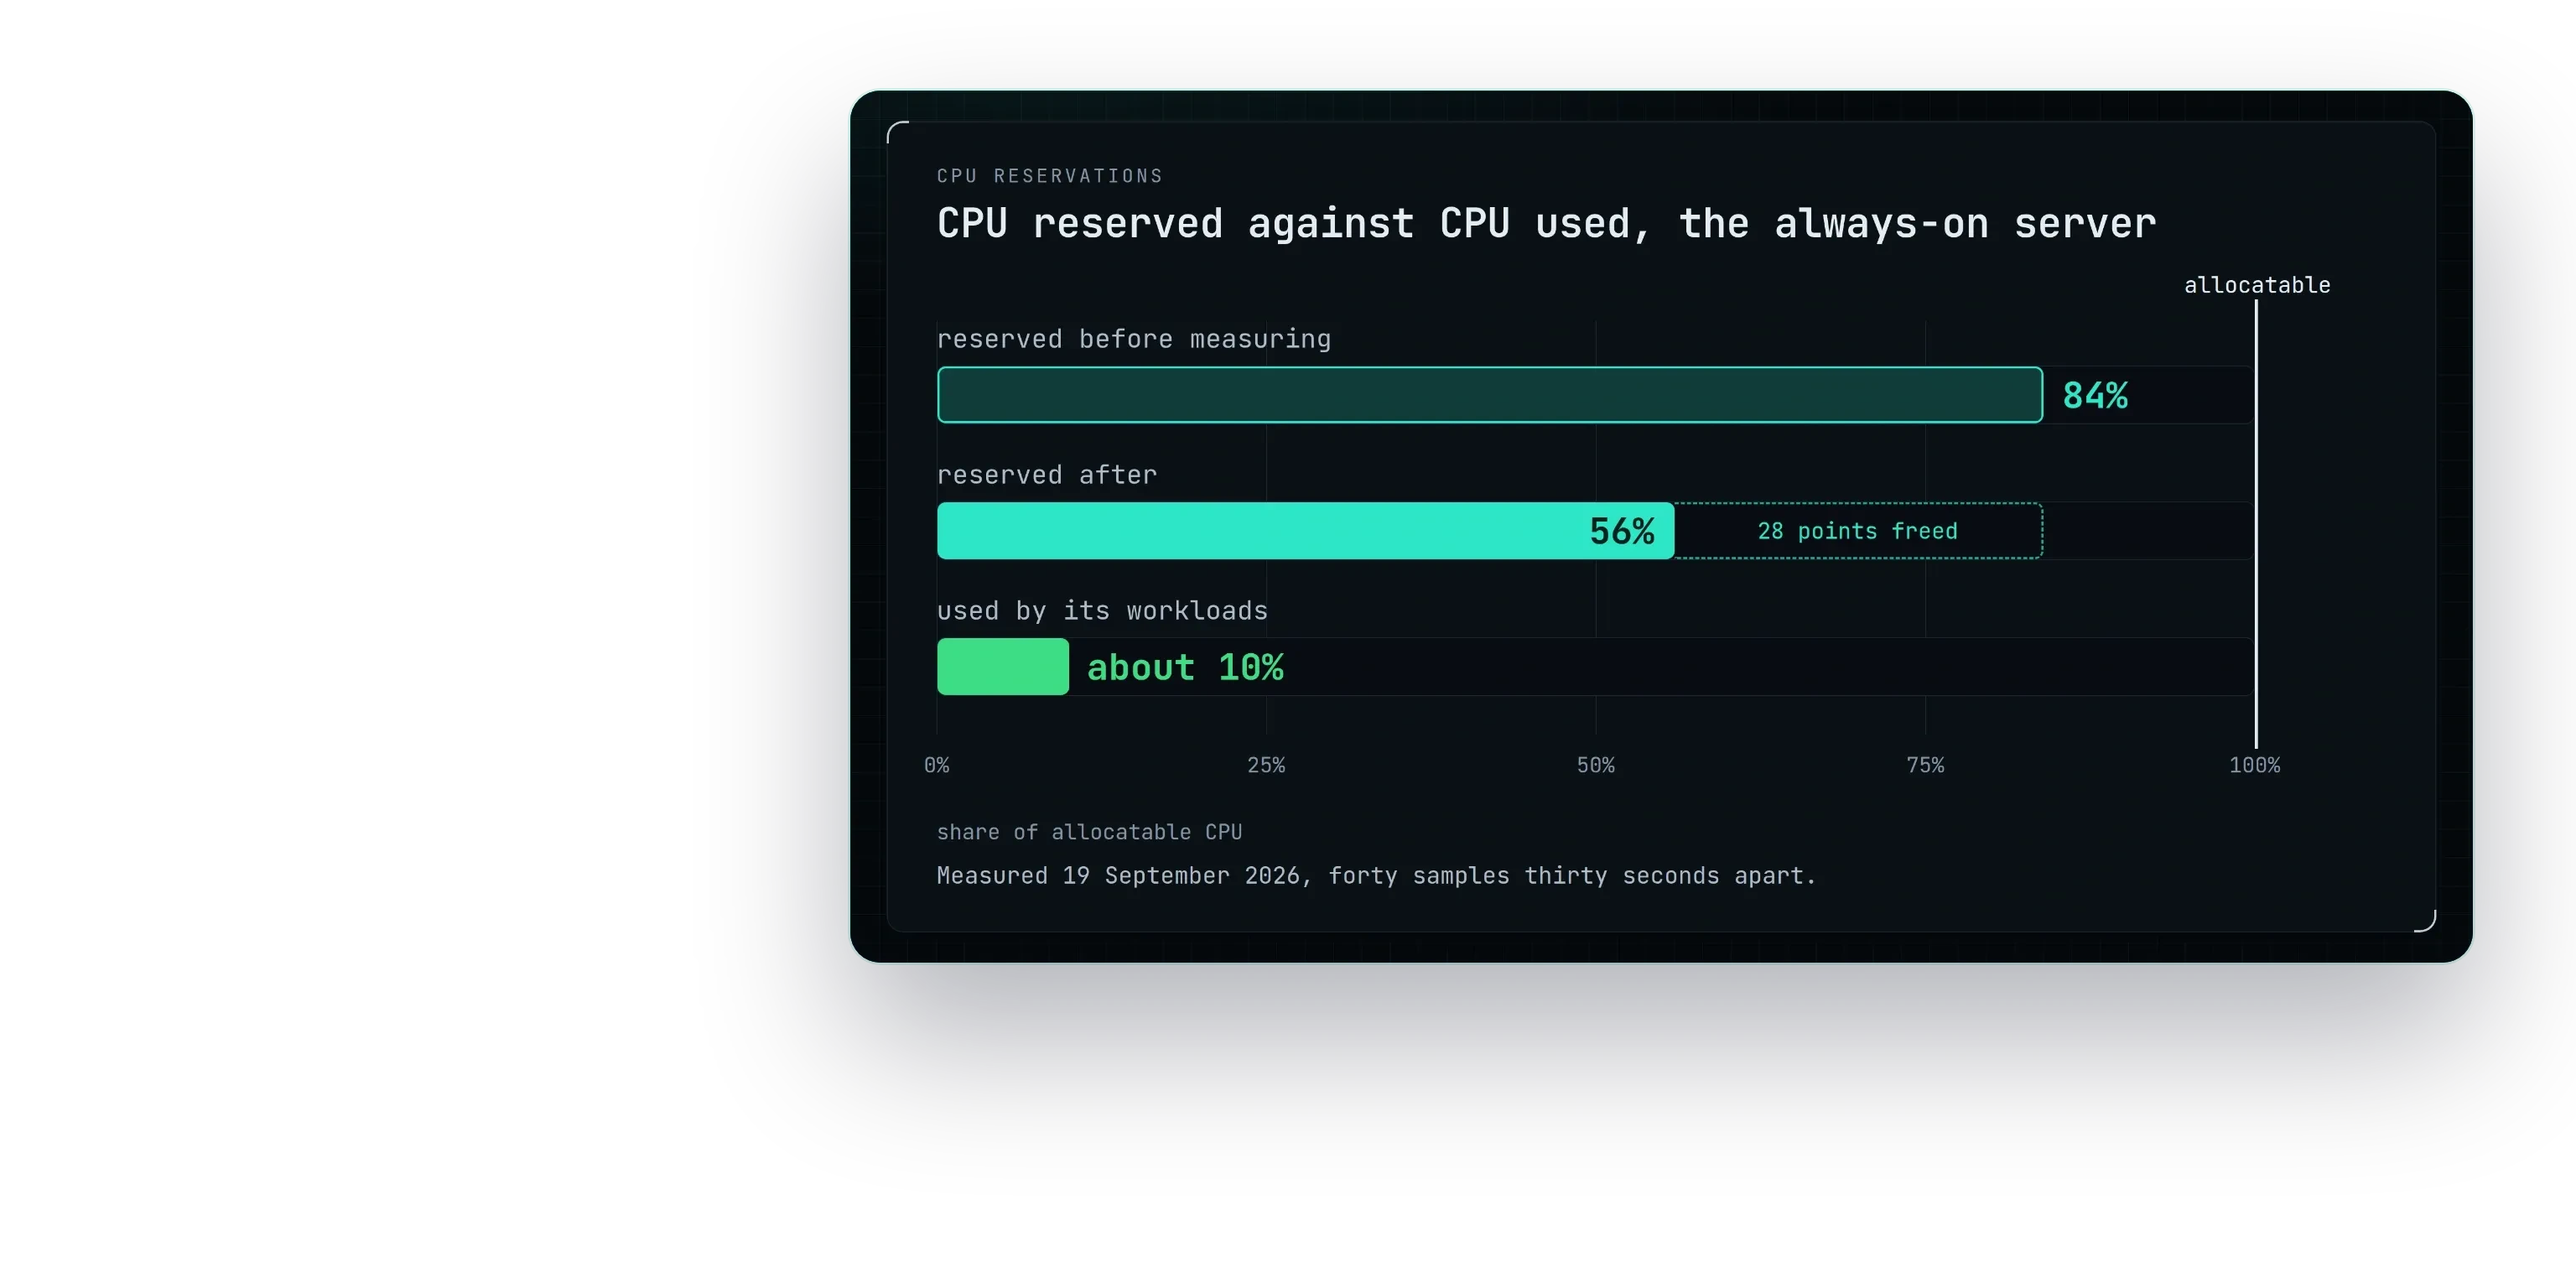
第二台可随时关机的机器加入了一个正在运行的单节点集群,没有改动任何应用。常开服务器保存控制平面、每个数据库和卷以及每个服务的第一个副本;构建机在 taint 之后承担构建任务和无状态服务的第二个副本,它休眠时这些副本会等待,而不是退回常开服务器。工作结束时它自行关机,有任务进入队列时再回来;一个控制台展示每个节点、每个工作负载和每段可用时间;常开服务器上的每一项 CPU request 都经过测量,使其预留从可分配量的 84% 降到 56%。
Md Moniruzzaman
完整故事
如何在不做迁移的情况下为正在运行的环境增加容量,以及这对自己运维而非租用基础设施意味着什么。
一台机器包揽一切,预留额度耗尽了
在最初几个月里,集群只是一台常开服务器,承载着一切:控制平面、每个数据库和卷、每个公开站点、镜像仓库,以及每次部署时的构建本身。在任何节点上,CPU request 都是一份预留,无论工作是否用到,调度器都会把它留出来,所以繁忙的节点往往在工作量饱和之前很久就先耗尽了预留。这台常开服务器的预留已经达到可分配 CPU 的 84%,因此无论机器看起来多么清闲,下一个工作负载都放不进去了。
如果新机器永远不会消失,增加容量很简单。更难的情况是第二台机器随时可能关机,只有当集群清楚地知道哪些东西可以在那台机器上运行、哪些东西绝不能依赖它时,这才是安全的。让这件事变得安全的规则一句话就能说完:任何保存数据的东西都绝不会在可能消失的机器上运行。
职责相反的机器
一台服务器从不关机,承载控制平面、每个数据库和卷、各个私有仓库以及每个服务的第一个副本。构建机随时可能关机,开机时负责构建和第二个副本。一个角色标签和一个 taint 决定什么可以落在哪里,除非主动申请,否则任何东西都不会落到构建机上。

每个节点的状态都在一个屏幕上,包括正在休眠的节点
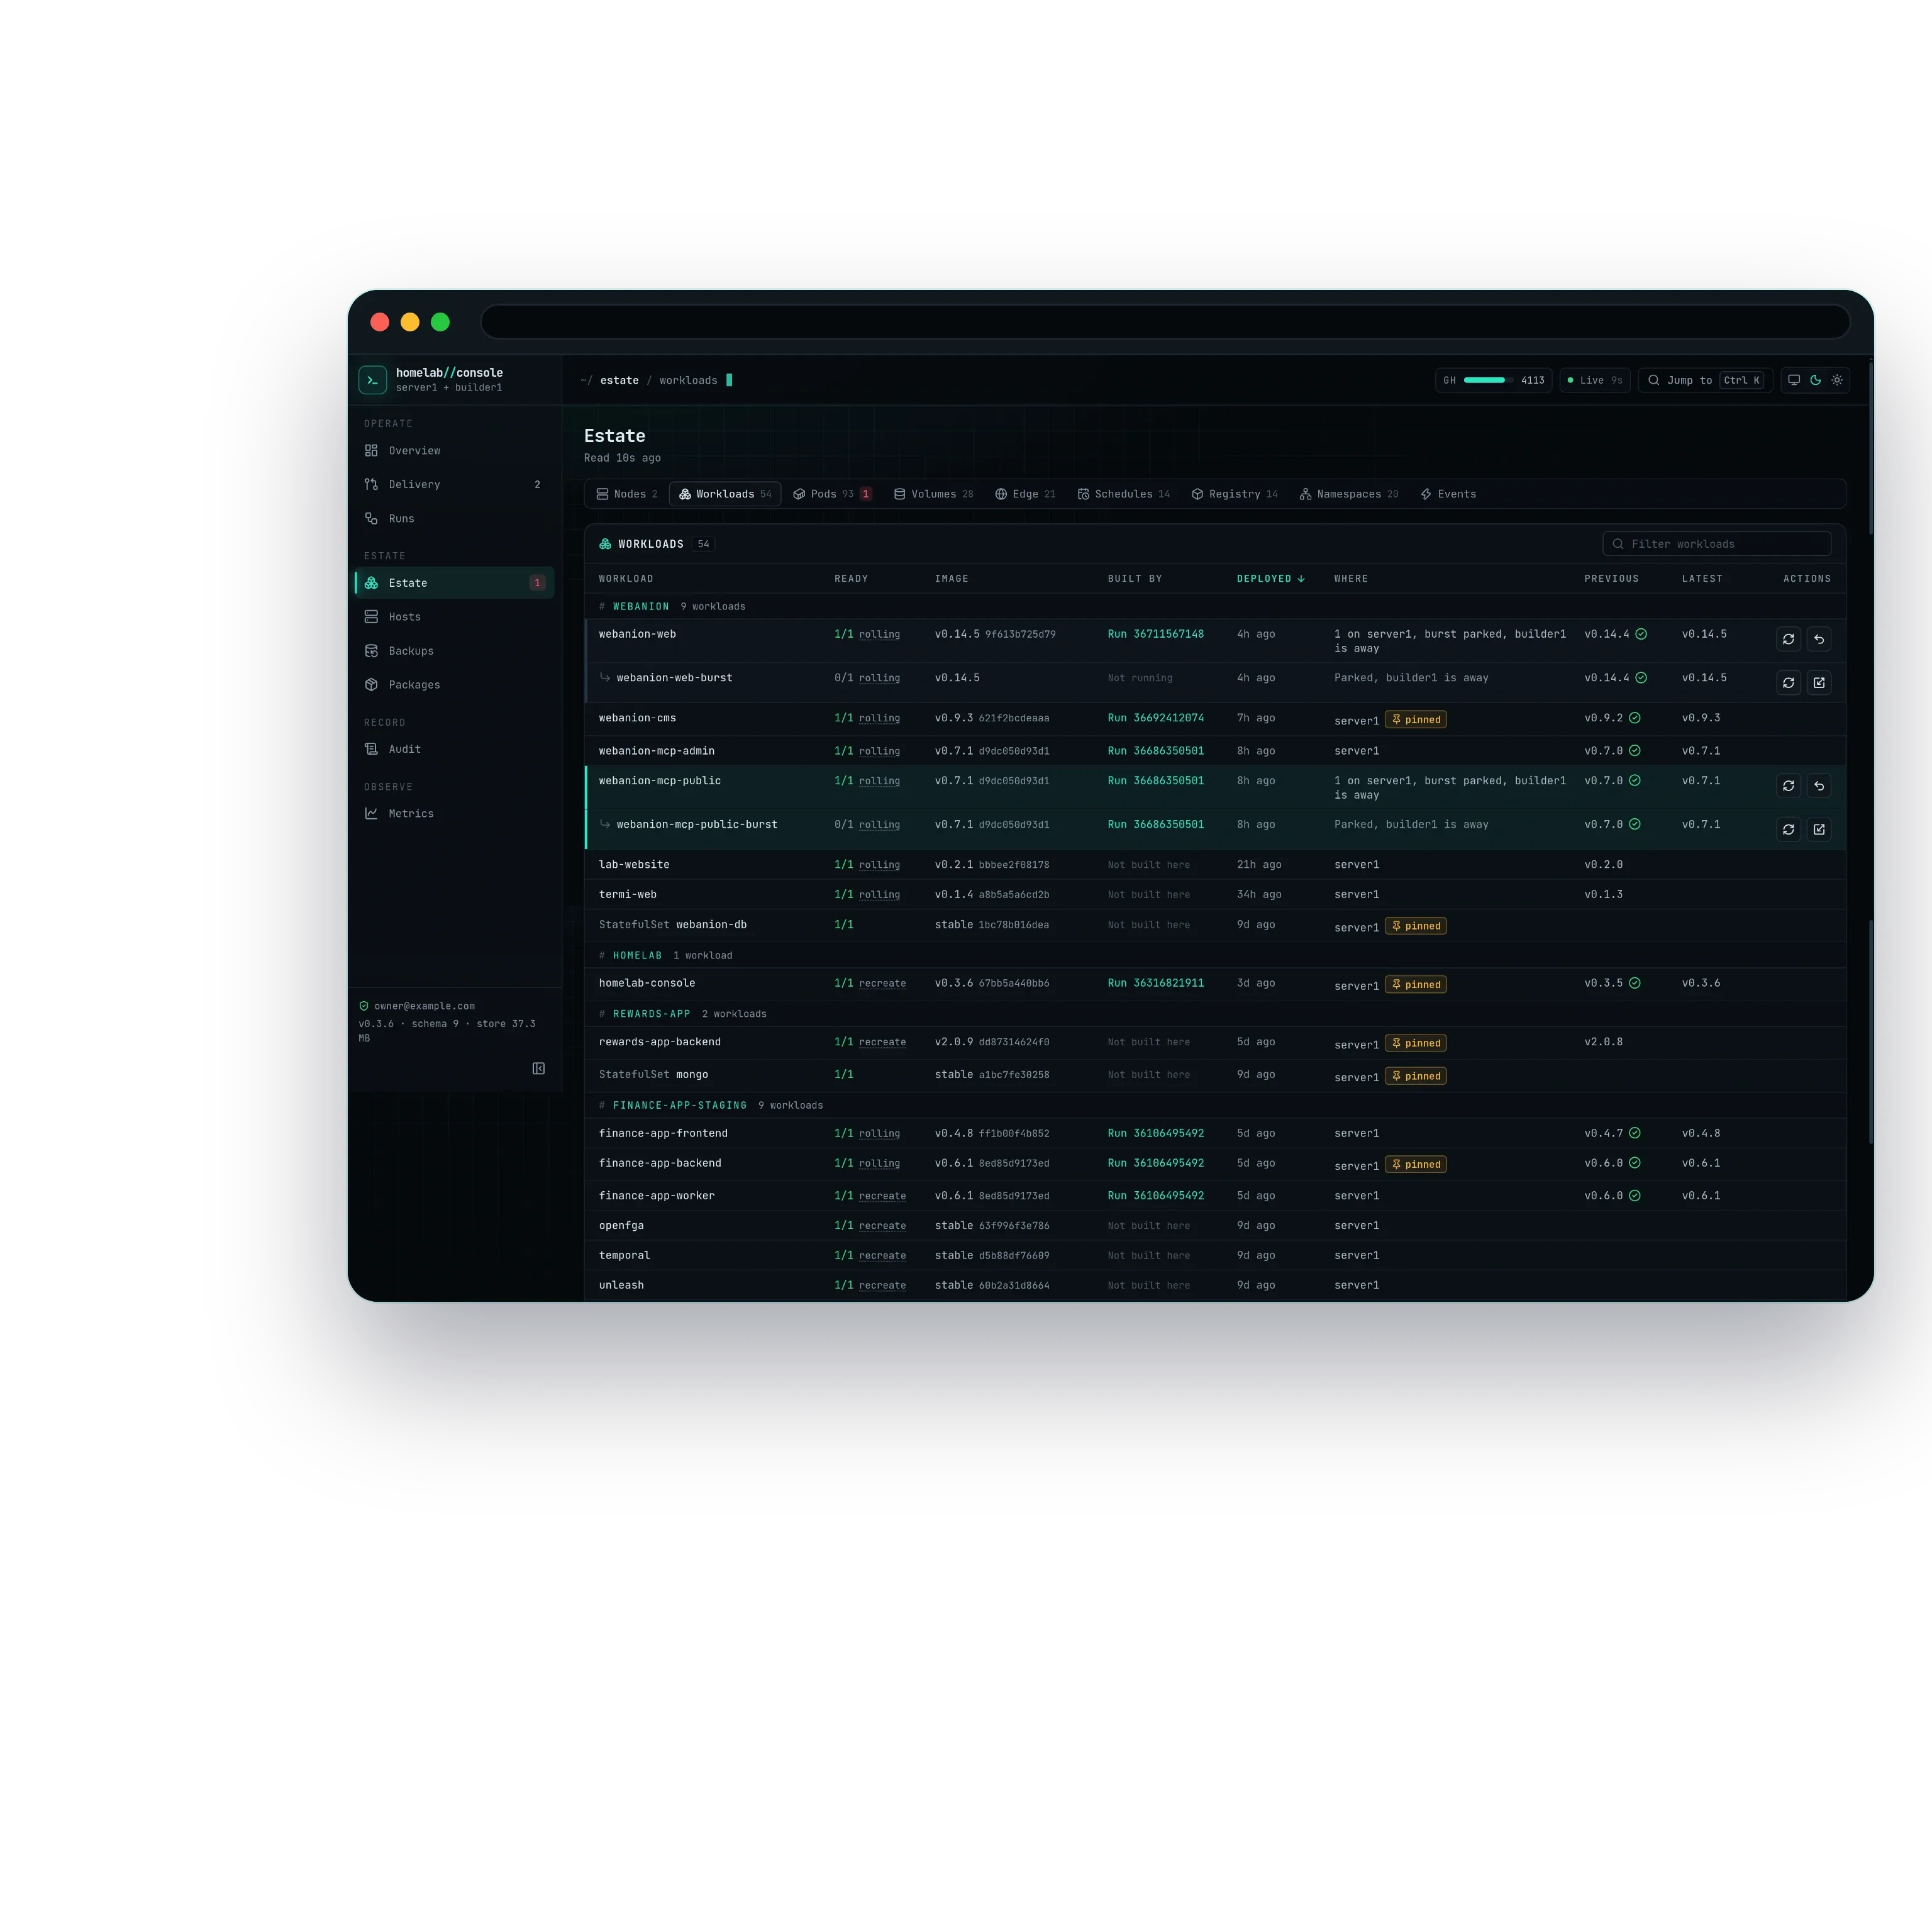
控制台的 Estate 视图为每个节点提供一张卡片:它的角色、它的工作负载申请的资源与实际用量的对比、它承载的 pod 数量,以及最近一天或一周的可用性条,逐段列出每一段 Ready 和 Away。这些卡片刻意呈现出相反的样子。截图当天,常开服务器在此前整整七天里一直处于 Ready 状态,而构建机只有其中 37% 的时间处于 Ready,共记录了 30 次变化,因为只要没有工作它就会休眠。
让工作负载各就其位的是角色和 taint,而不是运气。常开服务器带有自己的角色,没有 taint,所以普通工作负载会落在那里。构建机带有一个 taint,会拒绝所有没有声明自己能在会消失的节点上运行的 pod,所以不会有东西意外落到它上面,而把数据保存在磁盘上的工作负载则固定在那块磁盘所在的服务器上。


没有东西落在错误的节点上,也没有人在等节点
能从更多容量中受益的无状态服务会得到第二个副本,而不是被整体搬走。它的原始副本留在常开服务器上,构建机关机时由它单独提供服务。第二个副本只能在构建机上运行,不能去别处:那台机器休眠时,副本停放等待,绝不会退回到常开服务器上,因为那里的预留才是稀缺资源。机器恢复后,副本会自行启动,重新接入流量。
入口层针对不打招呼就消失的节点做了调整。断电机器上的副本不会拒绝连接,只是不再响应,所以路由器会在几秒内而不是半分钟后放弃它,并且只对页面请求重试一次,访客看到的是稍晚一点出现的页面,而不是一直转圈的加载图标。9月22日,有八个服务拥有第二个副本,其中包括网站和公开的 MCP 服务器;数据库、CMS 和所有后端都在常开服务器上保持单一副本。截图展示了两种状态:构建机休眠时停放的副本,以及构建机开机时由各个节点共同提供服务的网站和 MCP 服务器。

没有工作就休眠的容量
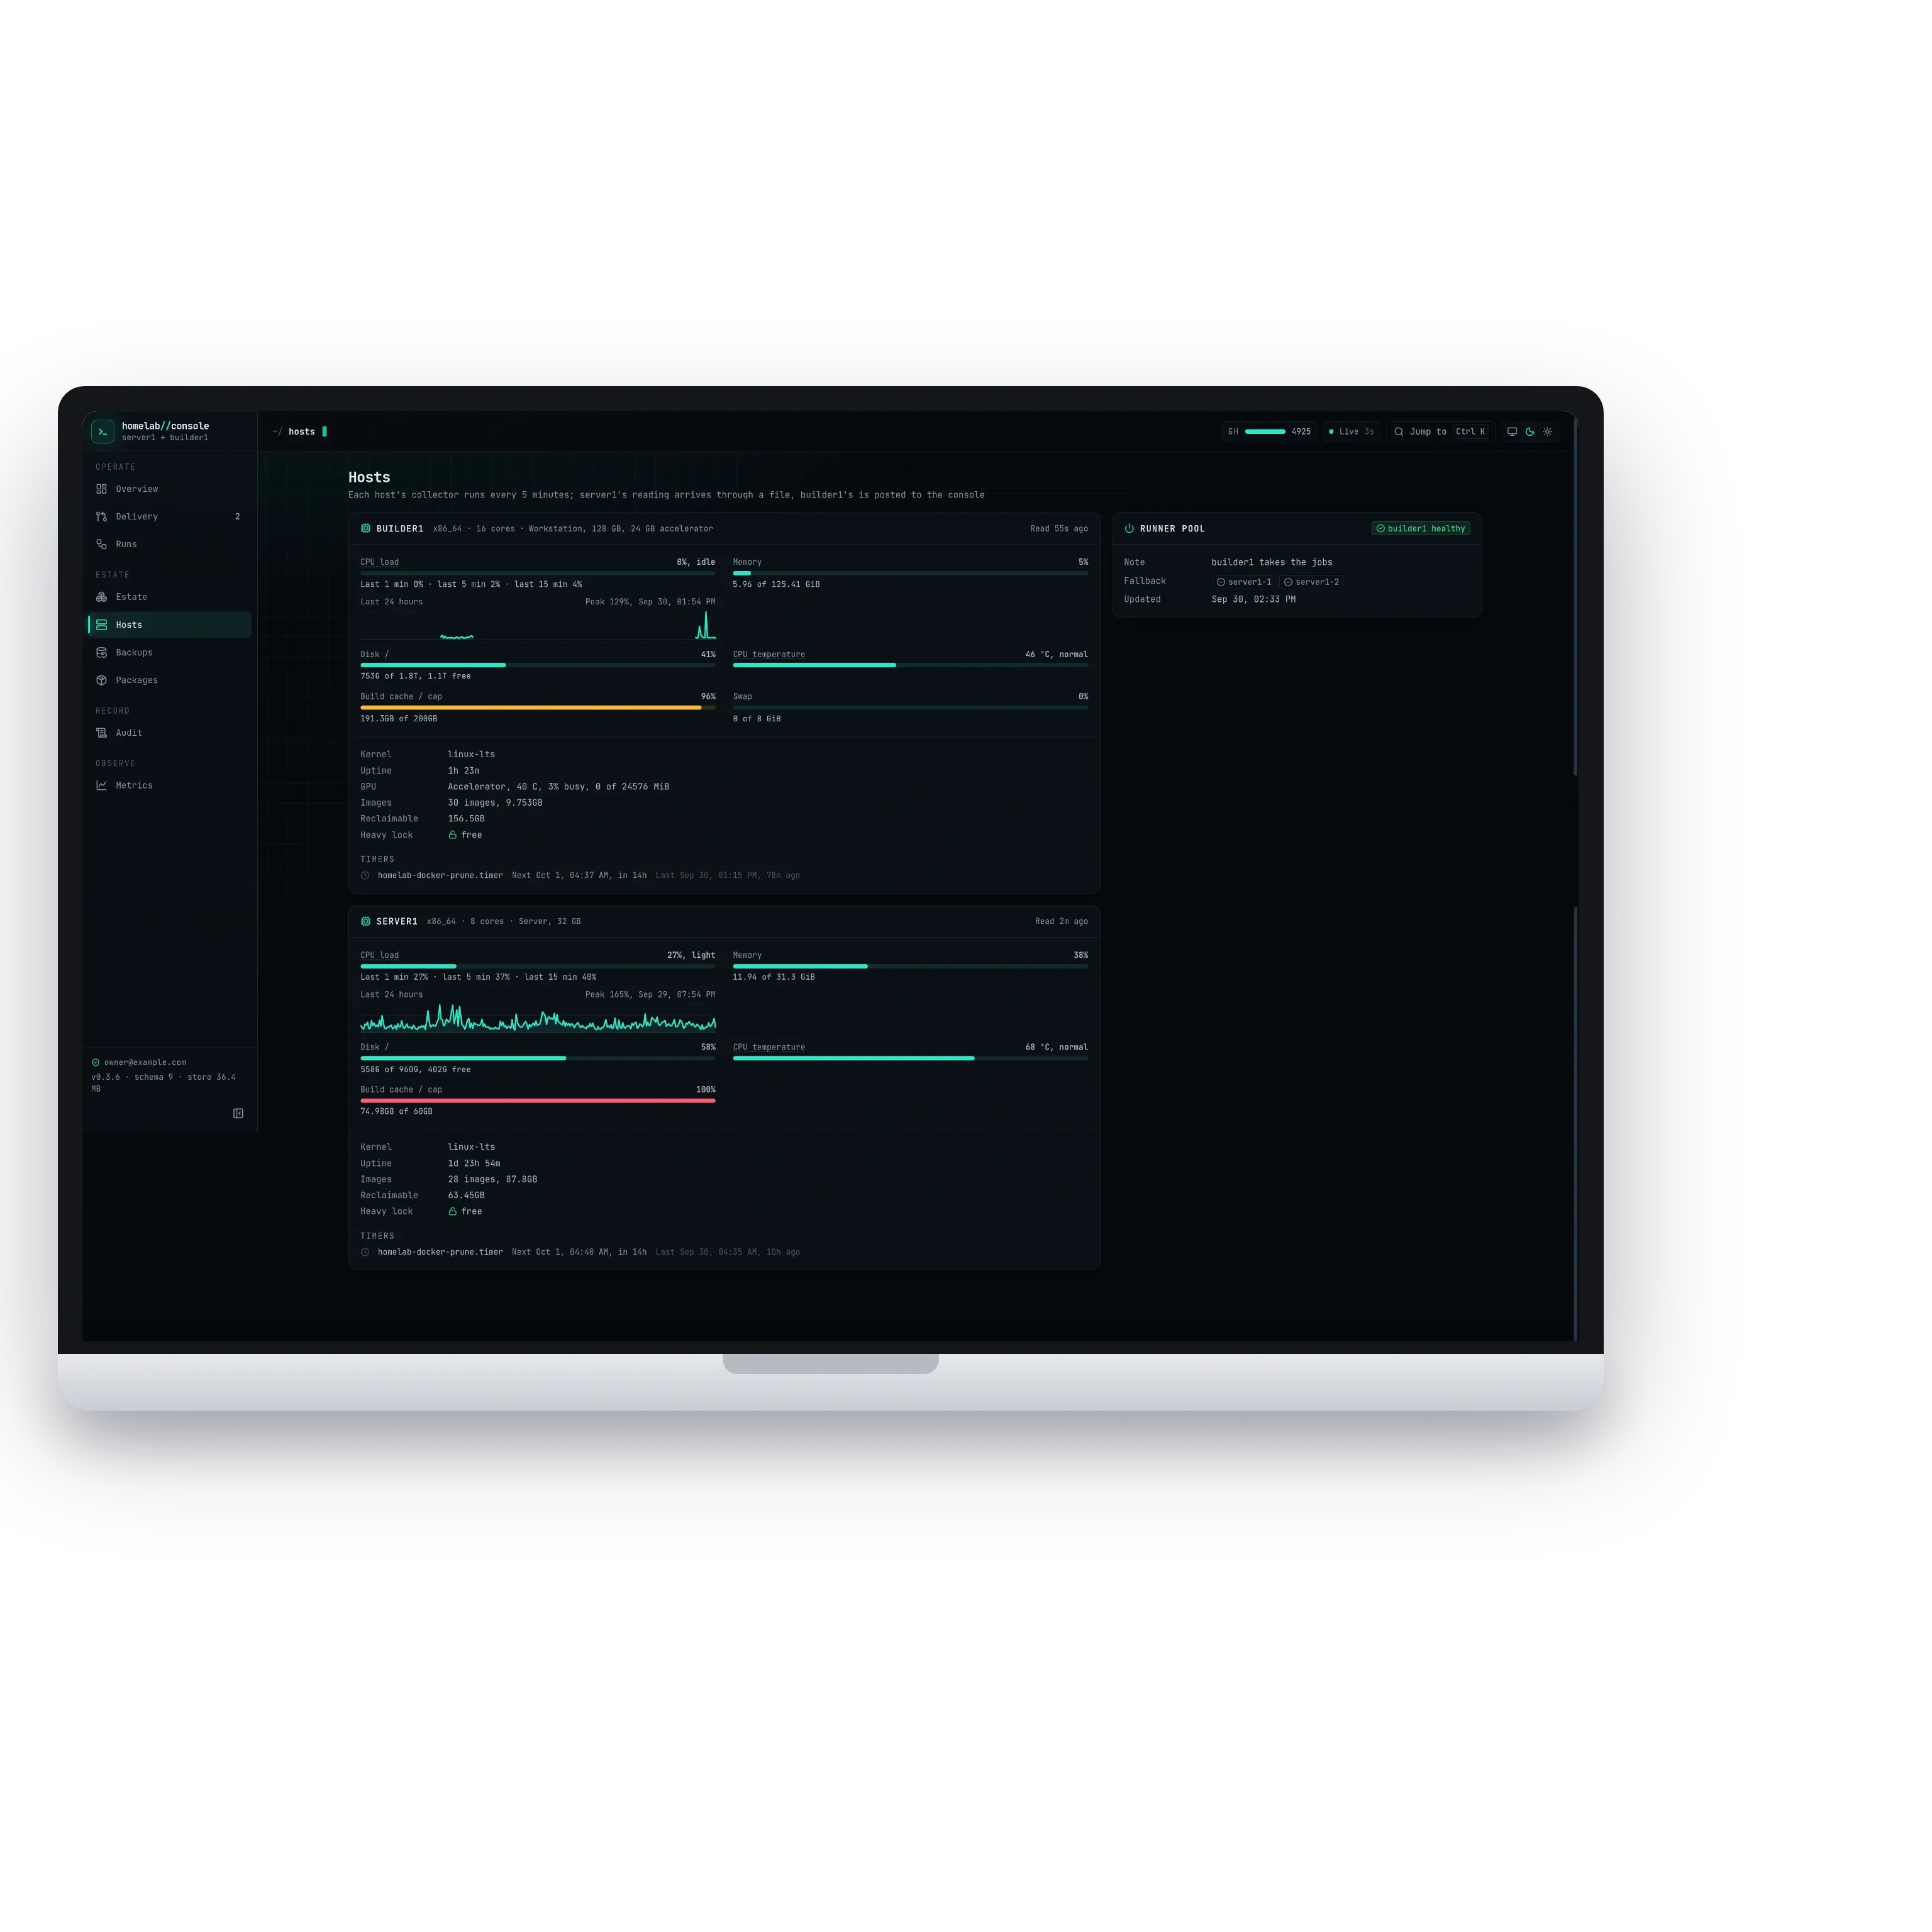
构建机什么都不做也要耗电六十到七十瓦,所以它不会闲着空耗。工作一结束它就自行关机,一旦有任务进入队列,它会在几分钟内回到集群,不需要任何人记着去开机。Hosts 视图把各台机器并排展示:带一天历史的负载、内存、磁盘、温度,以及构建缓存与其上限的对比。
手机视图展示了设计的另一半。构建机不在线时,它最后的读数仍然留在屏幕上,并标明读数的时间,因此空缺看起来是一台正在休息的机器,而不是故障。这样得到的是有工作时在线、没有工作时关机的容量。

预留额度是稀缺资源,所以每一项都经过测量
常开服务器上的每一项 request 都以每三十秒一次、共四十个样本进行测量,并按每个工作负载的峰值加上余量来设定。这台服务器此前预留的资源几乎是工作负载实际用量的九倍;调整之后,它的预留从可分配 CPU 的 84% 降到 56%,无需再添机器就为下一个服务腾出了空间。

下一台机器只是一个角色,而不是一个项目
整个过程中没有任何应用需要改动。调度位置写在角色标签、taint、affinity 和每个服务自己的 overlay 里,所以这些服务从来不知道有多少台机器。这也是让下一步变成例行工作的原因:下一台机器只需获得一个角色和一部分构建 runner 就能加入,一个服务可以在自己的代码仓库里启用第二个副本,而按同一模式搭建的另一个集群只需重复相同的步骤,不需要新的设计。它可以双向伸缩,因为关掉构建机不会丢失任何东西,也不需要 drain,失去的只是额外的速度。
这个限制是事先说明的,而不是事后发现的:构建进行到一半时断电,那次构建就会失败,然后重新运行。这适合拥有自有硬件、需要在不迁移的情况下获得更多容量的企业,也回答了 CTO 在交出基础设施之前会问的问题:眼前这个人能不能在为它写代码之外,也把它运维好。底层平台是支撑整个工作室的自托管 homelab的故事,而构建机为交付做了什么,则是用自有 runner 池取代托管 CI的故事。
你可能也喜欢

托管 CI 成了最慢的一环,于是构建搬回了家
构建和部署从 GitHub 的托管 runner 搬到了家中的一个 runner 池。过去每次运行都从一台全新机器开始,发布还要等排队、等故障恢复;现在由一台构建机在线时承接每个任务,常开服务器上的备用 runner 则由一个看门狗看守,一旦拿不准,它优先保证还能继续发布。镜像进入私有容器镜像仓库,工作室的程序库进入私有 npm 仓库,两者都在自家环境内,每次运行的记录也会归档,留存时间超过 GitHub 的保留期。最慢的部署从八分二十四秒缩短到三分零五秒,CI 也快了三分之一。
Md Moniruzzaman
9月 24, 2026
27 Pearls:移动发布和商店提交
一款已完成的 27 Pearls 应用,在为期一周的合作中成为 App Store 和 Google Play 上获批的商店页面,没有经历任何一轮拒审。这一周包括发布构建与签名、围绕学生收益撰写的商店文案、覆盖每种必需设备尺寸的截图、与应用实际收集的数据相符的隐私声明,以及一个可用的审核账号。这款应用至今仍在 Google Play 上。

Md Moniruzzaman
5月 05, 2023



博客是来自生产一线的笔记:架构决策、经受住真实用户考验的 AI 系统、能自己挣回成本的基础设施。写于工作之中,而不是隔岸观火。