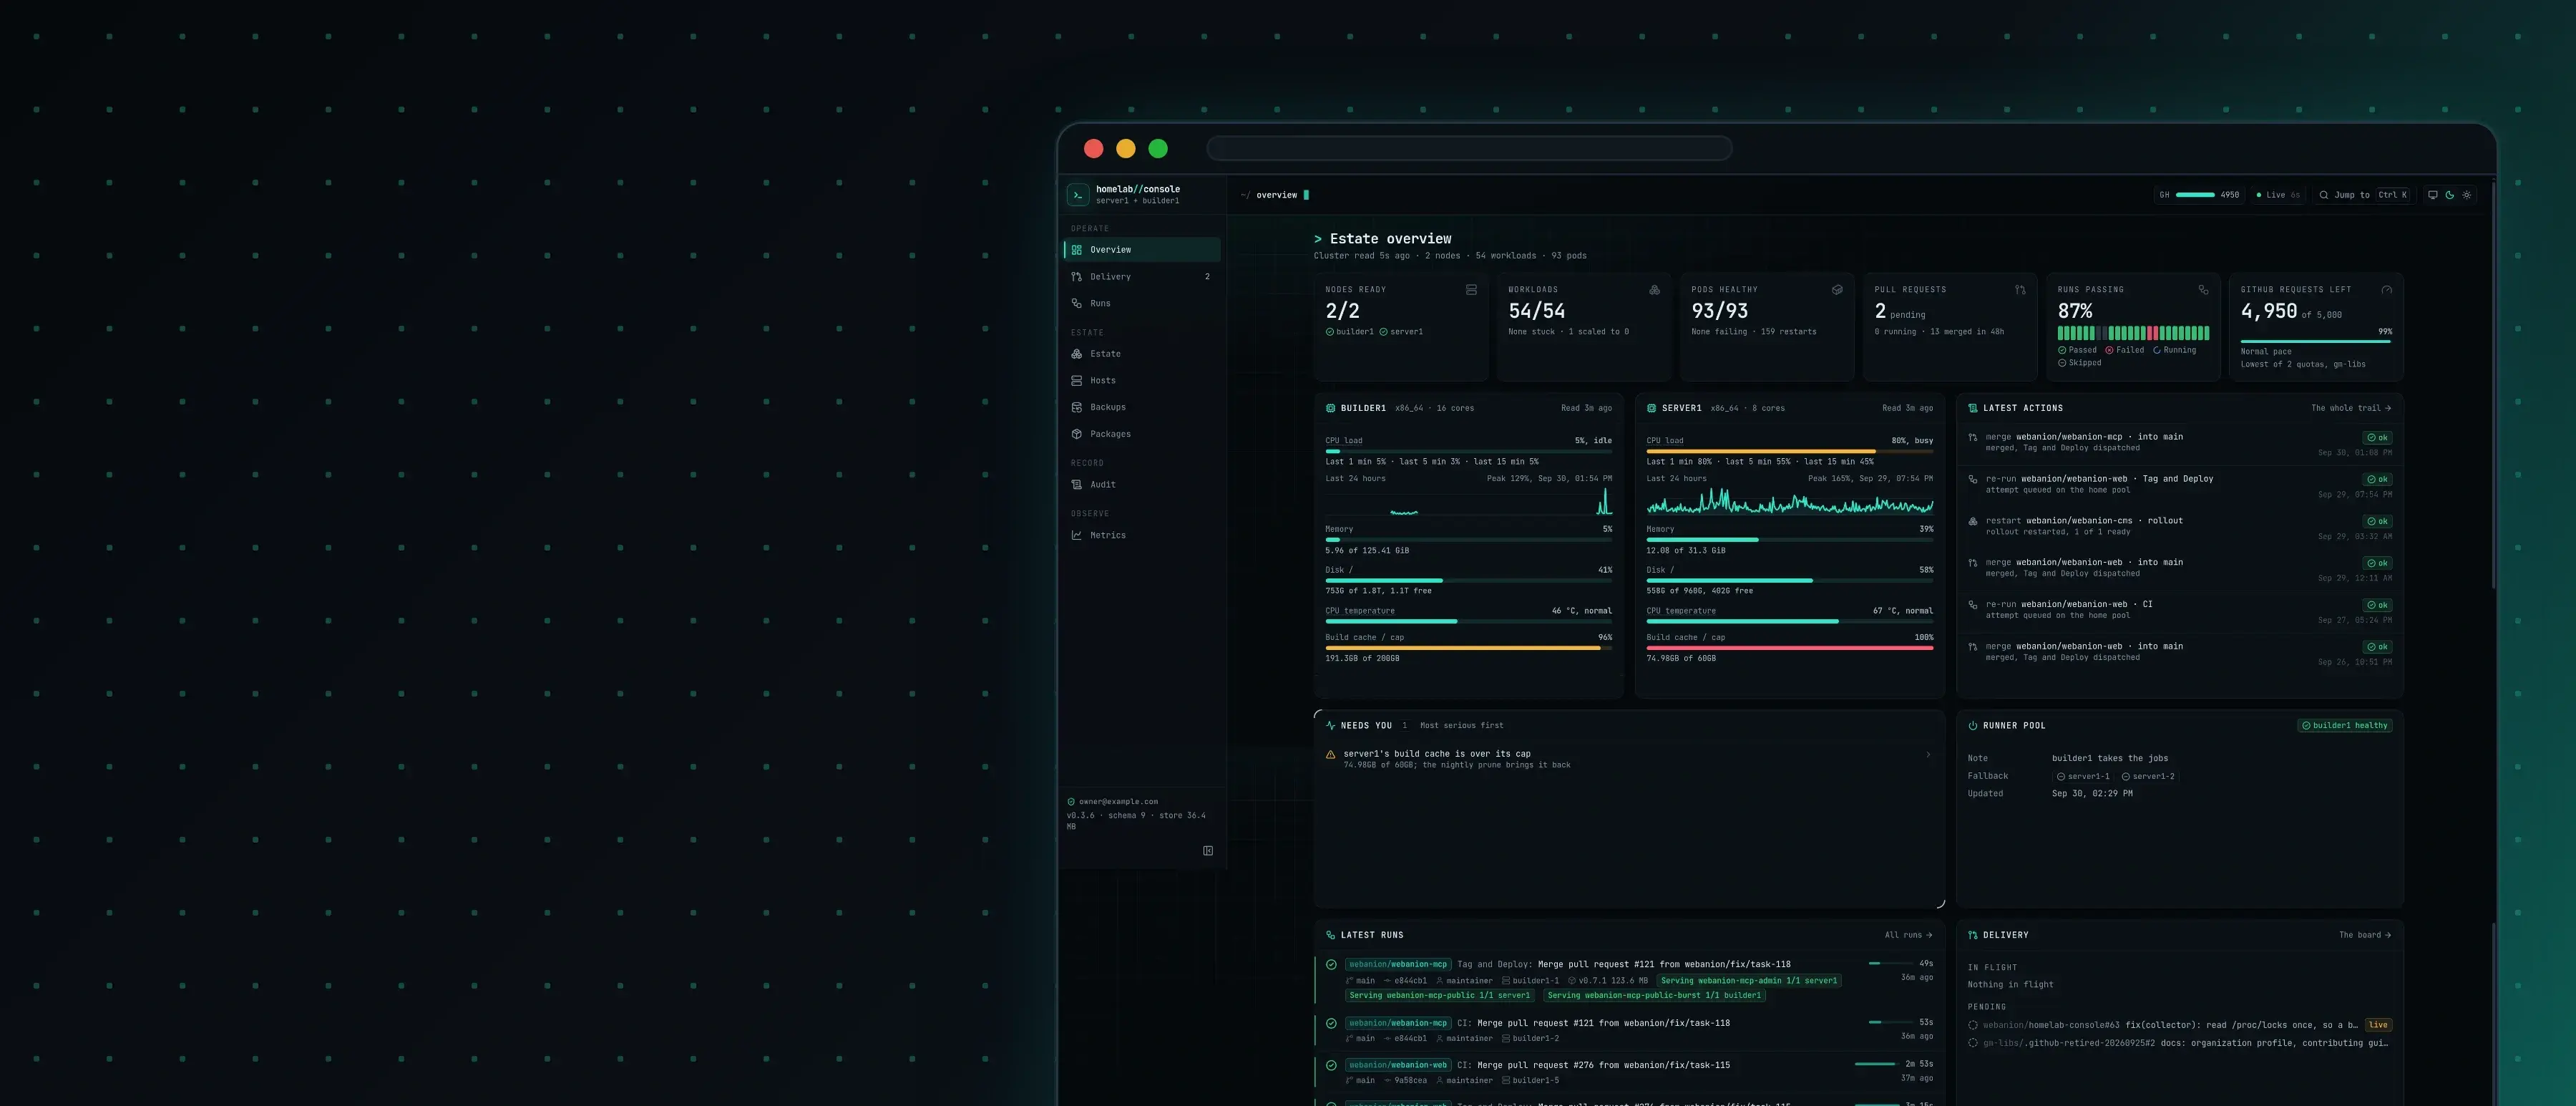
工作室自己的基础设施,运行在自托管的 Kubernetes 集群上,于 2026 年 2 月规划,此后每天维护:网站、CMS 和 MCP 服务器,以及它负责维护的客户平台,都通过 Cloudflare 隧道提供服务;每个数据库每晚导出并校验;指标和告警规则推送到手机;家门之外有一个宕机监控;还有一个容器镜像仓库和一个 npm 仓库;一个私有控制台把合并、运行、镜像、Pod 和节点汇集在同一个页面上。
Md Moniruzzaman
完整故事
不再为每家供应商各租一个控制面板,而是自己掌握整套技术栈,这需要付出什么;每天照看它,又能为工作室带来什么。
工作室交付的一切,都运行在自己的服务器上
一家为客户打造产品的工作室,自己要运行的东西也多得出人意料。Webanion 以它的全部语言提供自己的网站,还有其背后的 CMS,公开和私有的 MCP 服务器,供 AI 助手读取和管理这些内容,以及它为客户开发并负责维护的平台,其中包括一个金融平台、一个预订平台、一个账本应用和一个研究团队的网站。每一项都需要一个运行的地方、一个有备份的数据库、一张按时续期的证书,以及一个在出问题时能察觉的人。如果每一部分都向各自的供应商租用,就意味着每家供应商各有一份账单、一个控制面板和一个盲区,却没有一个地方能回答决定一天工作的三个问题:什么在运行,它是否健康,今天需要处理什么。
这里给出的答案,是在工作室自有服务器上运行的一个 Kubernetes 集群,于 2026 年 2 月规划,此后每天维护。每个网站和平台都通过 Cloudflare 隧道从这里提供服务,每个数据库每晚导出一次,指标和告警规则从内部盯着集群,一个宕机监控则从家门之外盯着它,一个容器镜像仓库和一个 npm 仓库保存着工作室自己的镜像和软件包,一个私有控制台统揽全局。在截图当天,也就是 2026 年 9 月 30 日,控制台统计到 2 个节点、54 个工作负载和 93 个 Pod。
一个页面,看清什么在运行、什么需要处理
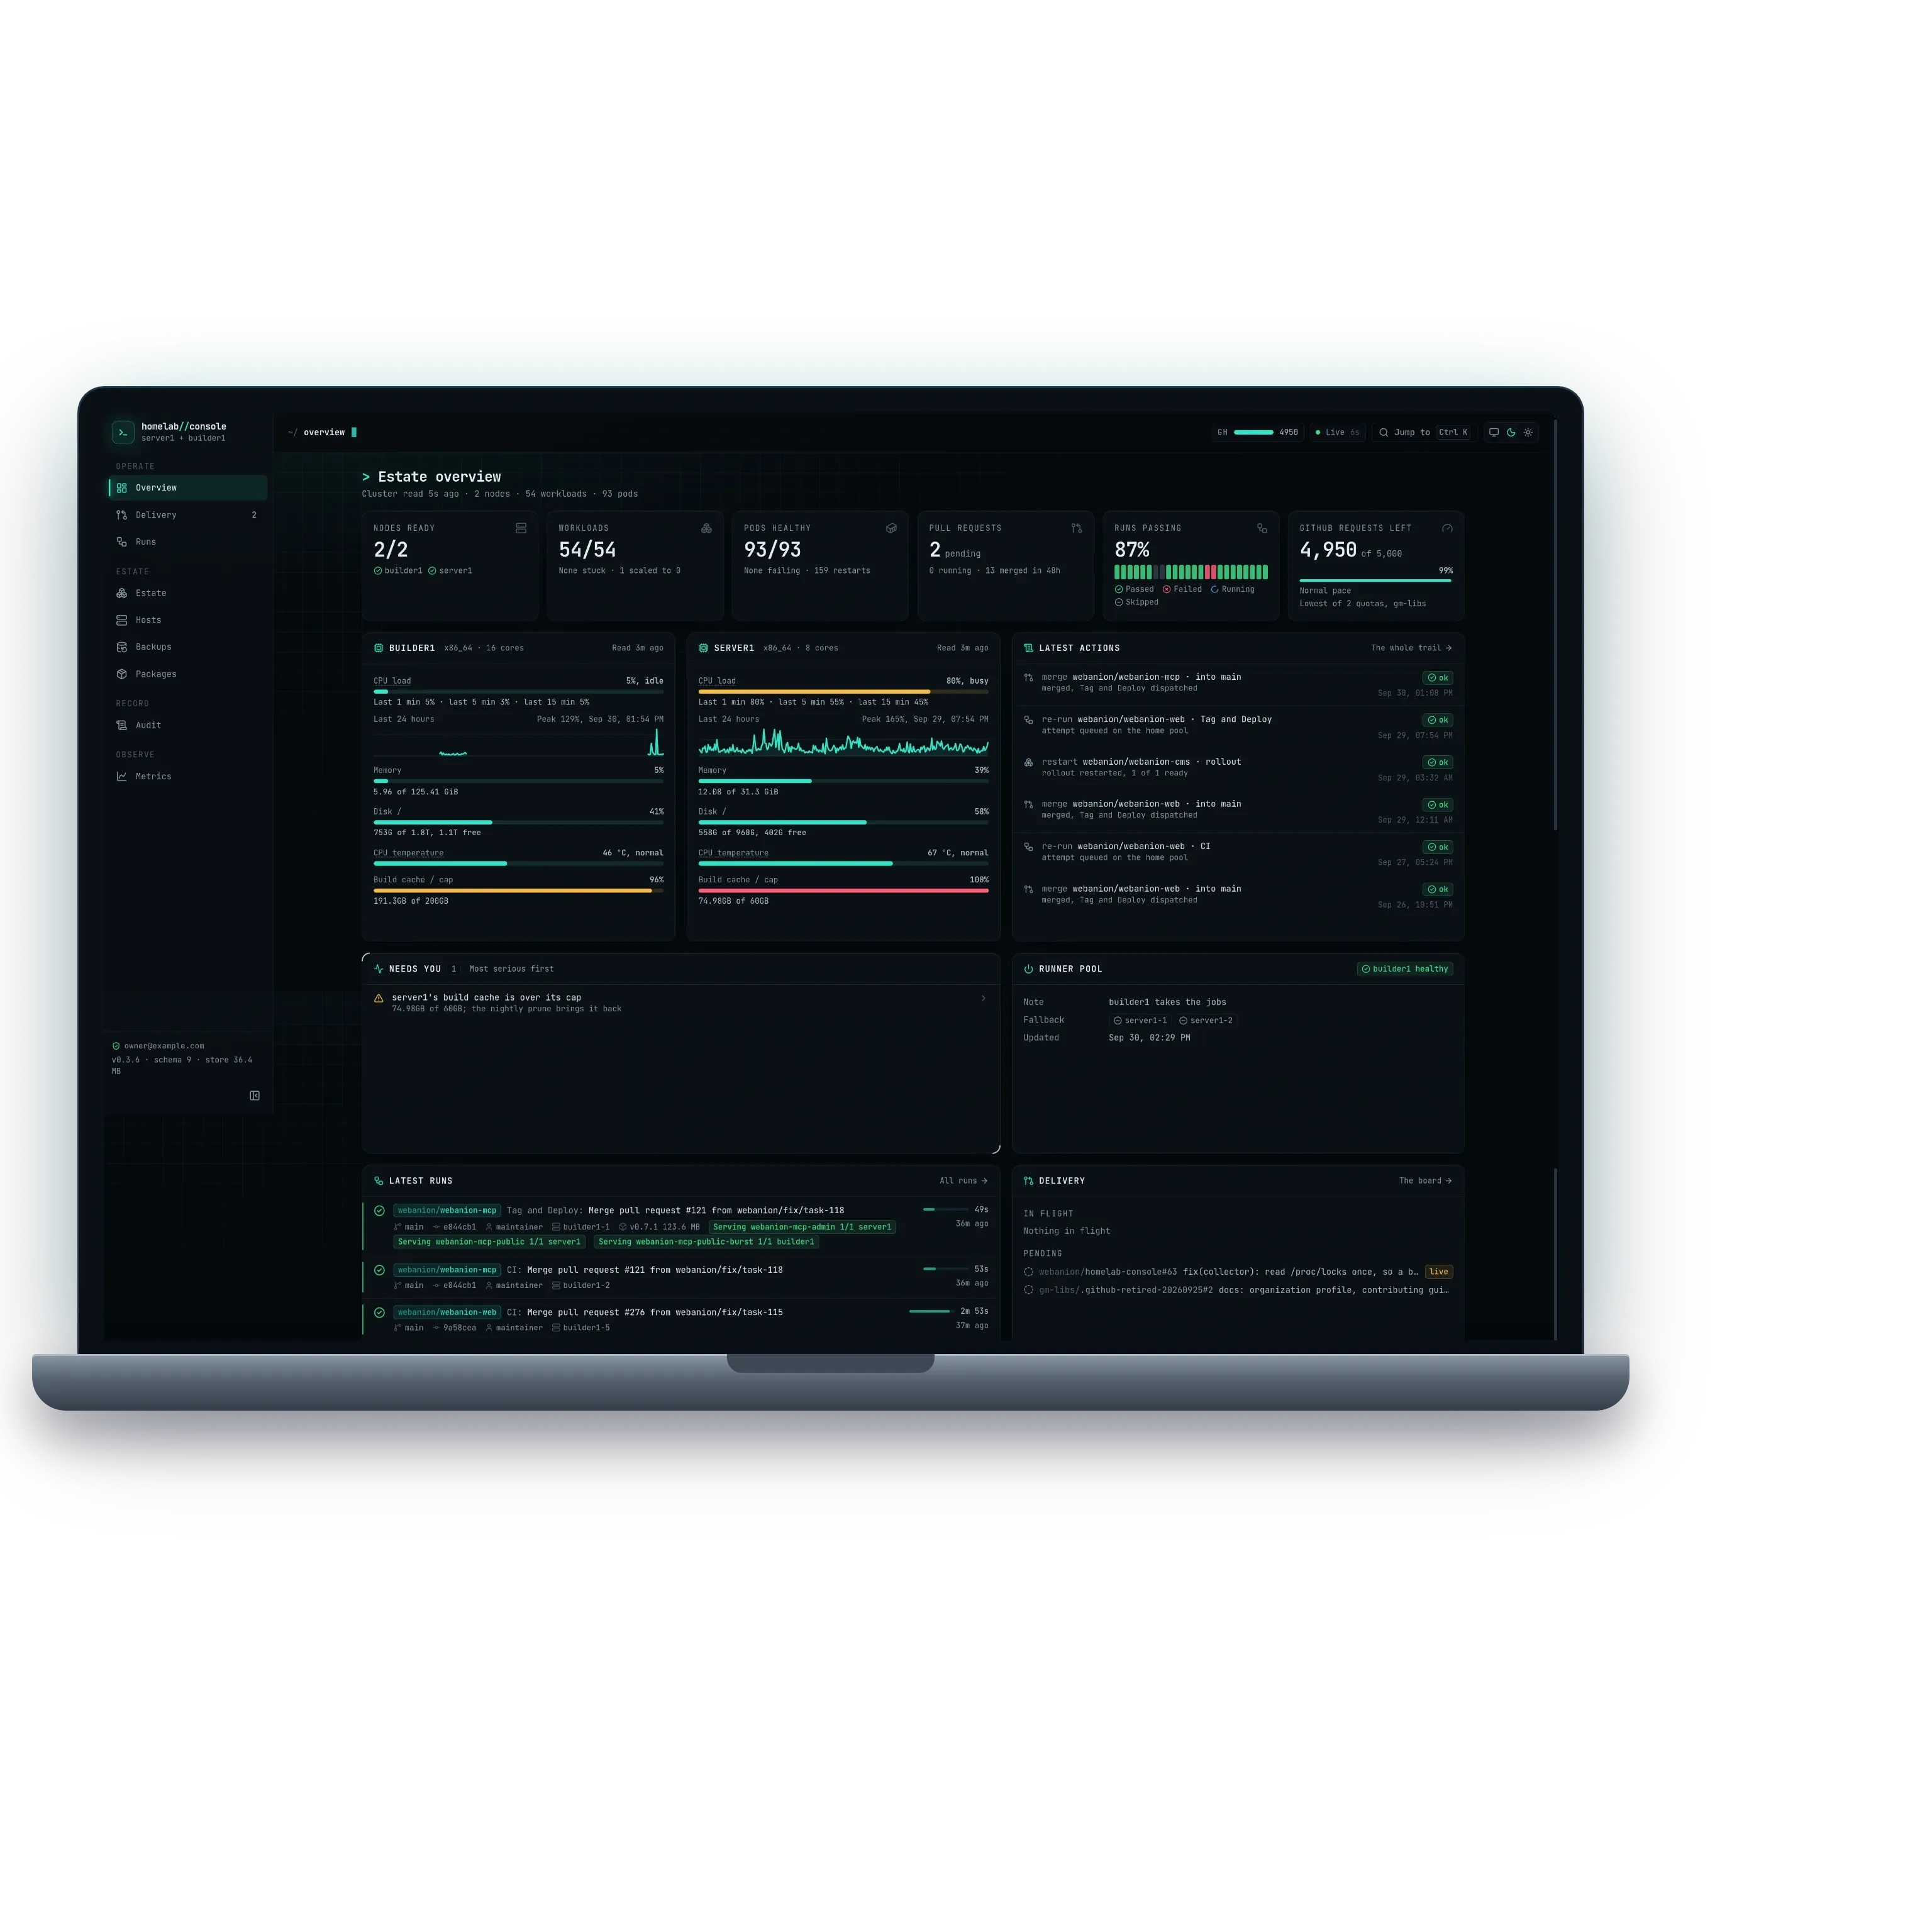
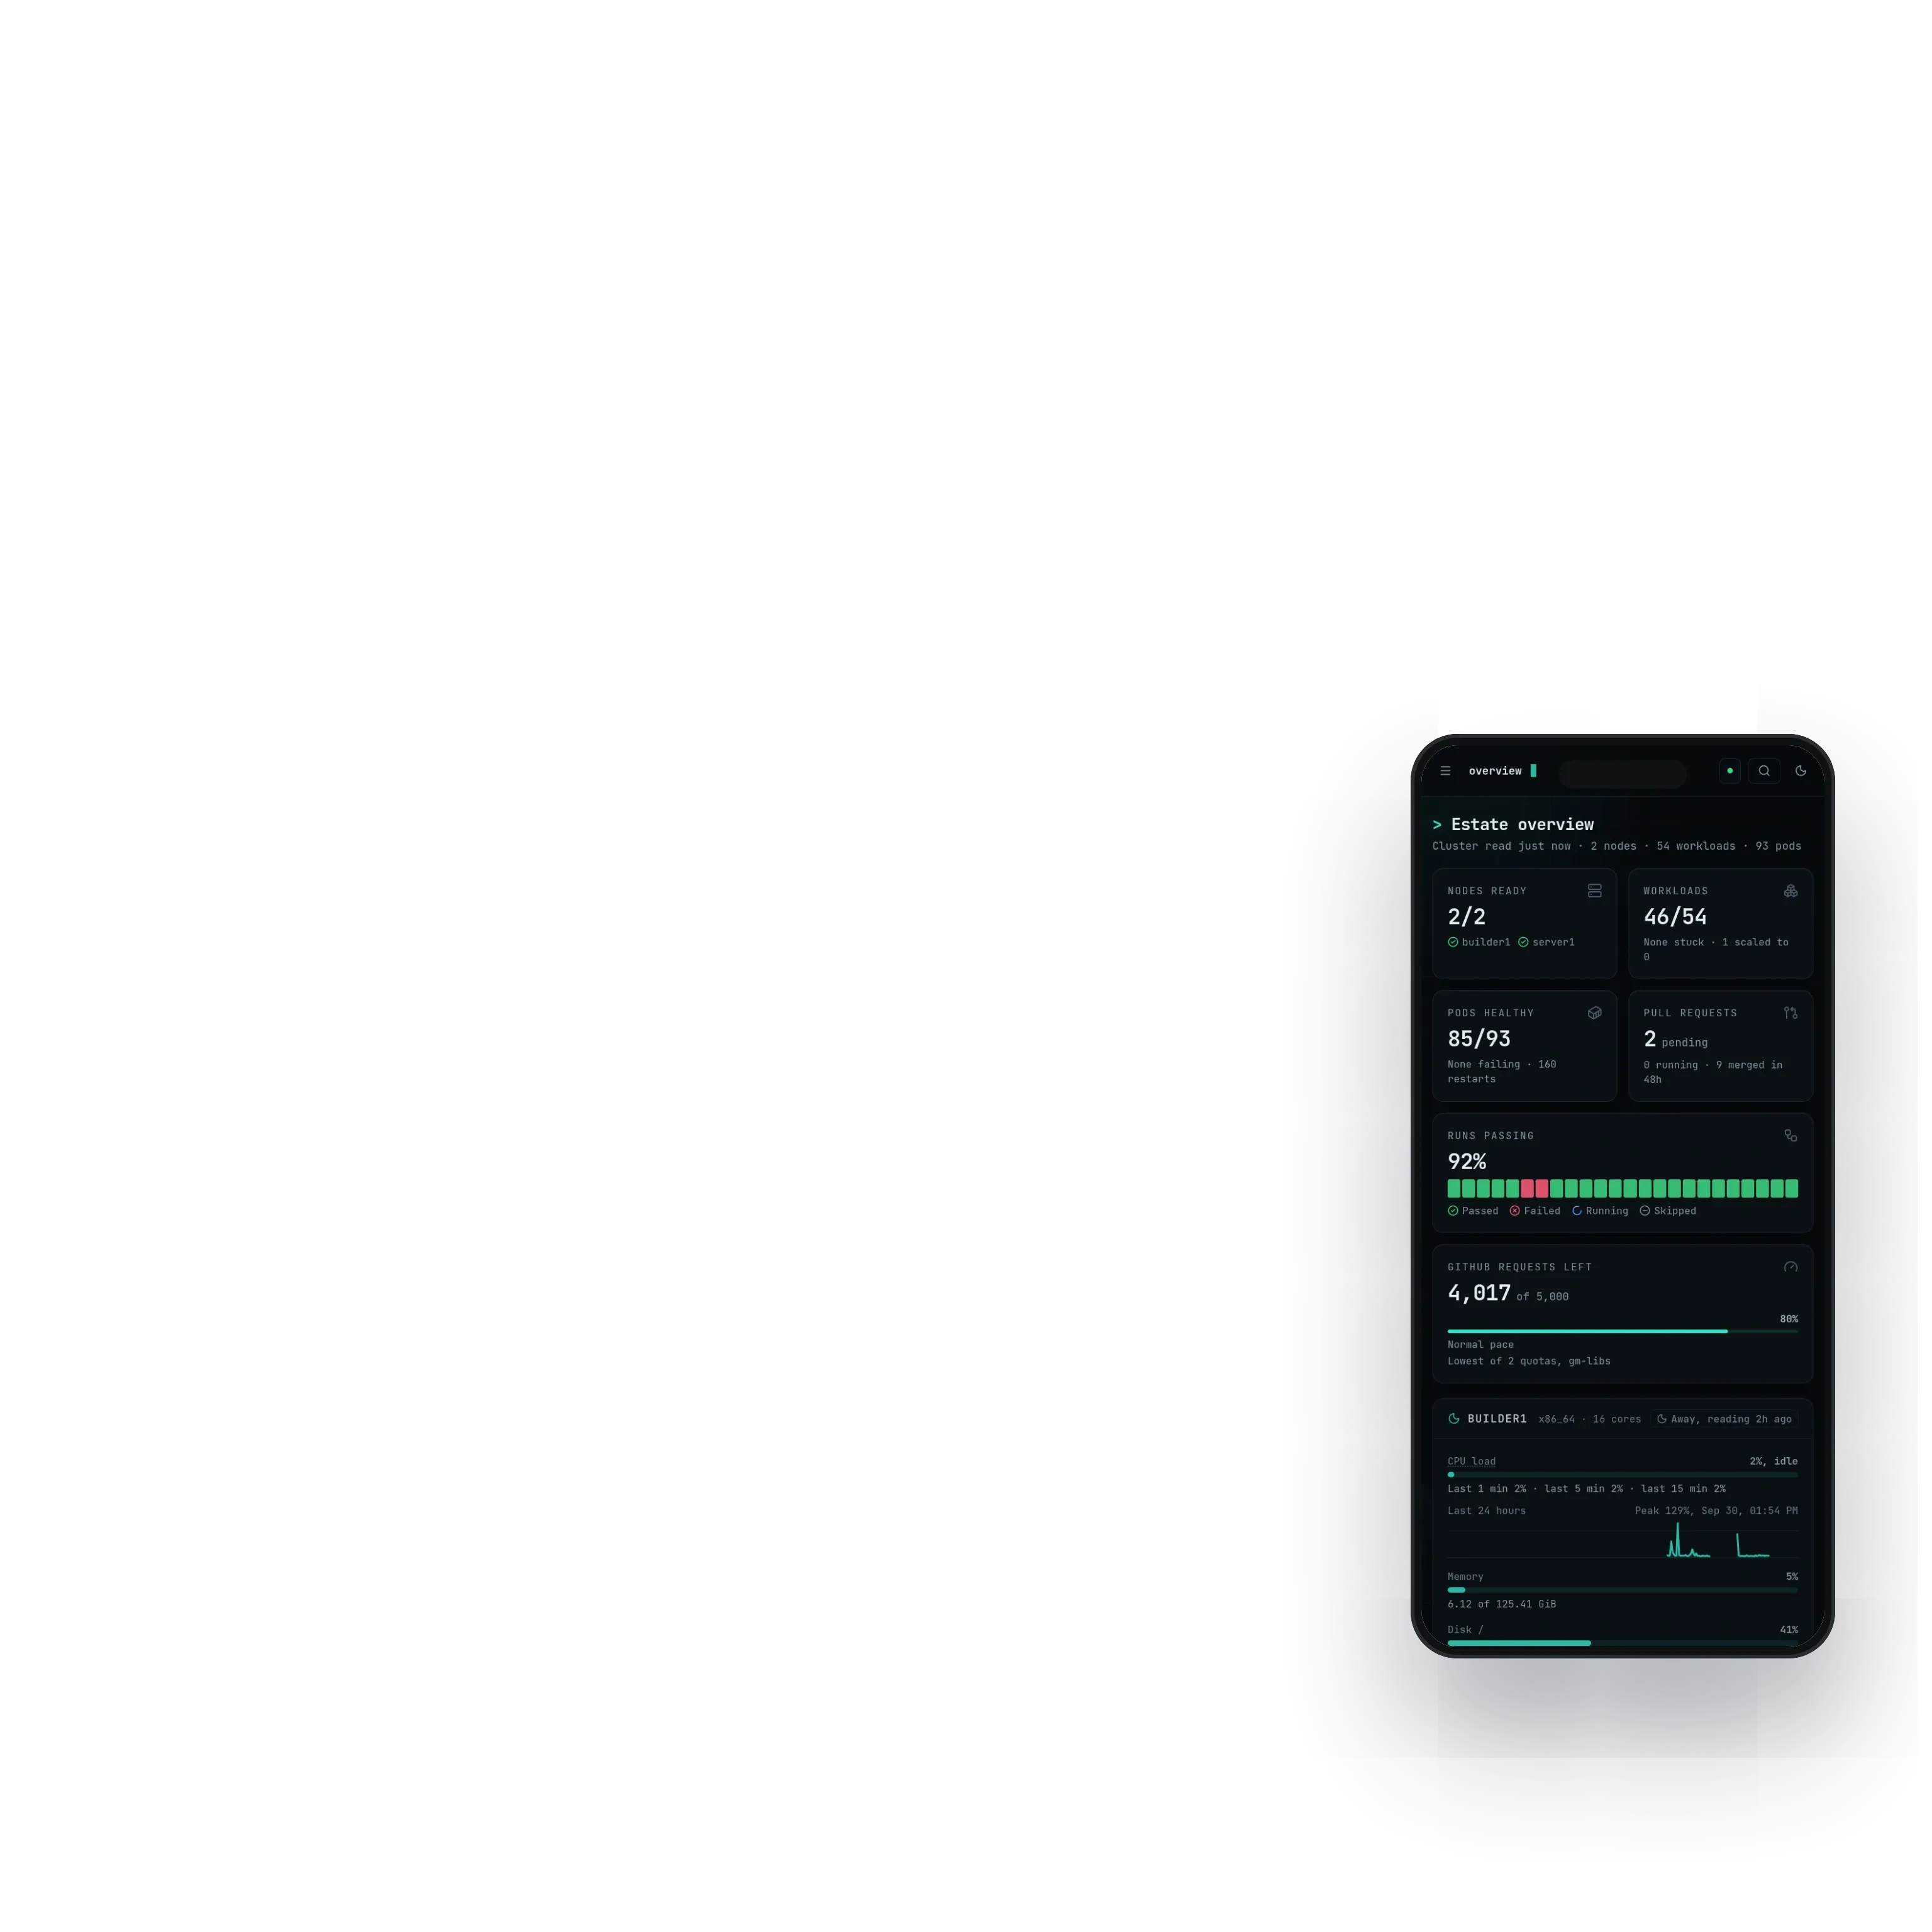
控制台是早上打开的第一个页面,也是合并期间一直开着的那个页面。它的总览同时读取集群、GitHub、镜像仓库和各台主机:就绪的节点,健康的工作负载和 Pod,待处理和已合并的拉取请求,近期运行中通过的比例,GitHub 请求额度还剩多少,每台主机的负载、内存、磁盘、温度和构建缓存,最近执行的操作,以及一份今天需要动手处理的简短清单,最严重的排在最前。
它真正的价值在于串联:这次合并、它触发的运行、这次运行推送的镜像、运行该镜像的 Pod,以及这个 Pod 所在的节点,都在一个页面上,而不是分散在五个标签页里。它位于 Cloudflare Access 之后,在手机宽度下同样可用,因为需要查看情况的时刻,往往不是笔记本电脑打开的时候。截图当天,它显示 2 个节点中 2 个就绪,54 个工作负载中 54 个正常,93 个 Pod 中 93 个健康,前两天共合并 13 次。
每一次合并,都从同一块看板发出
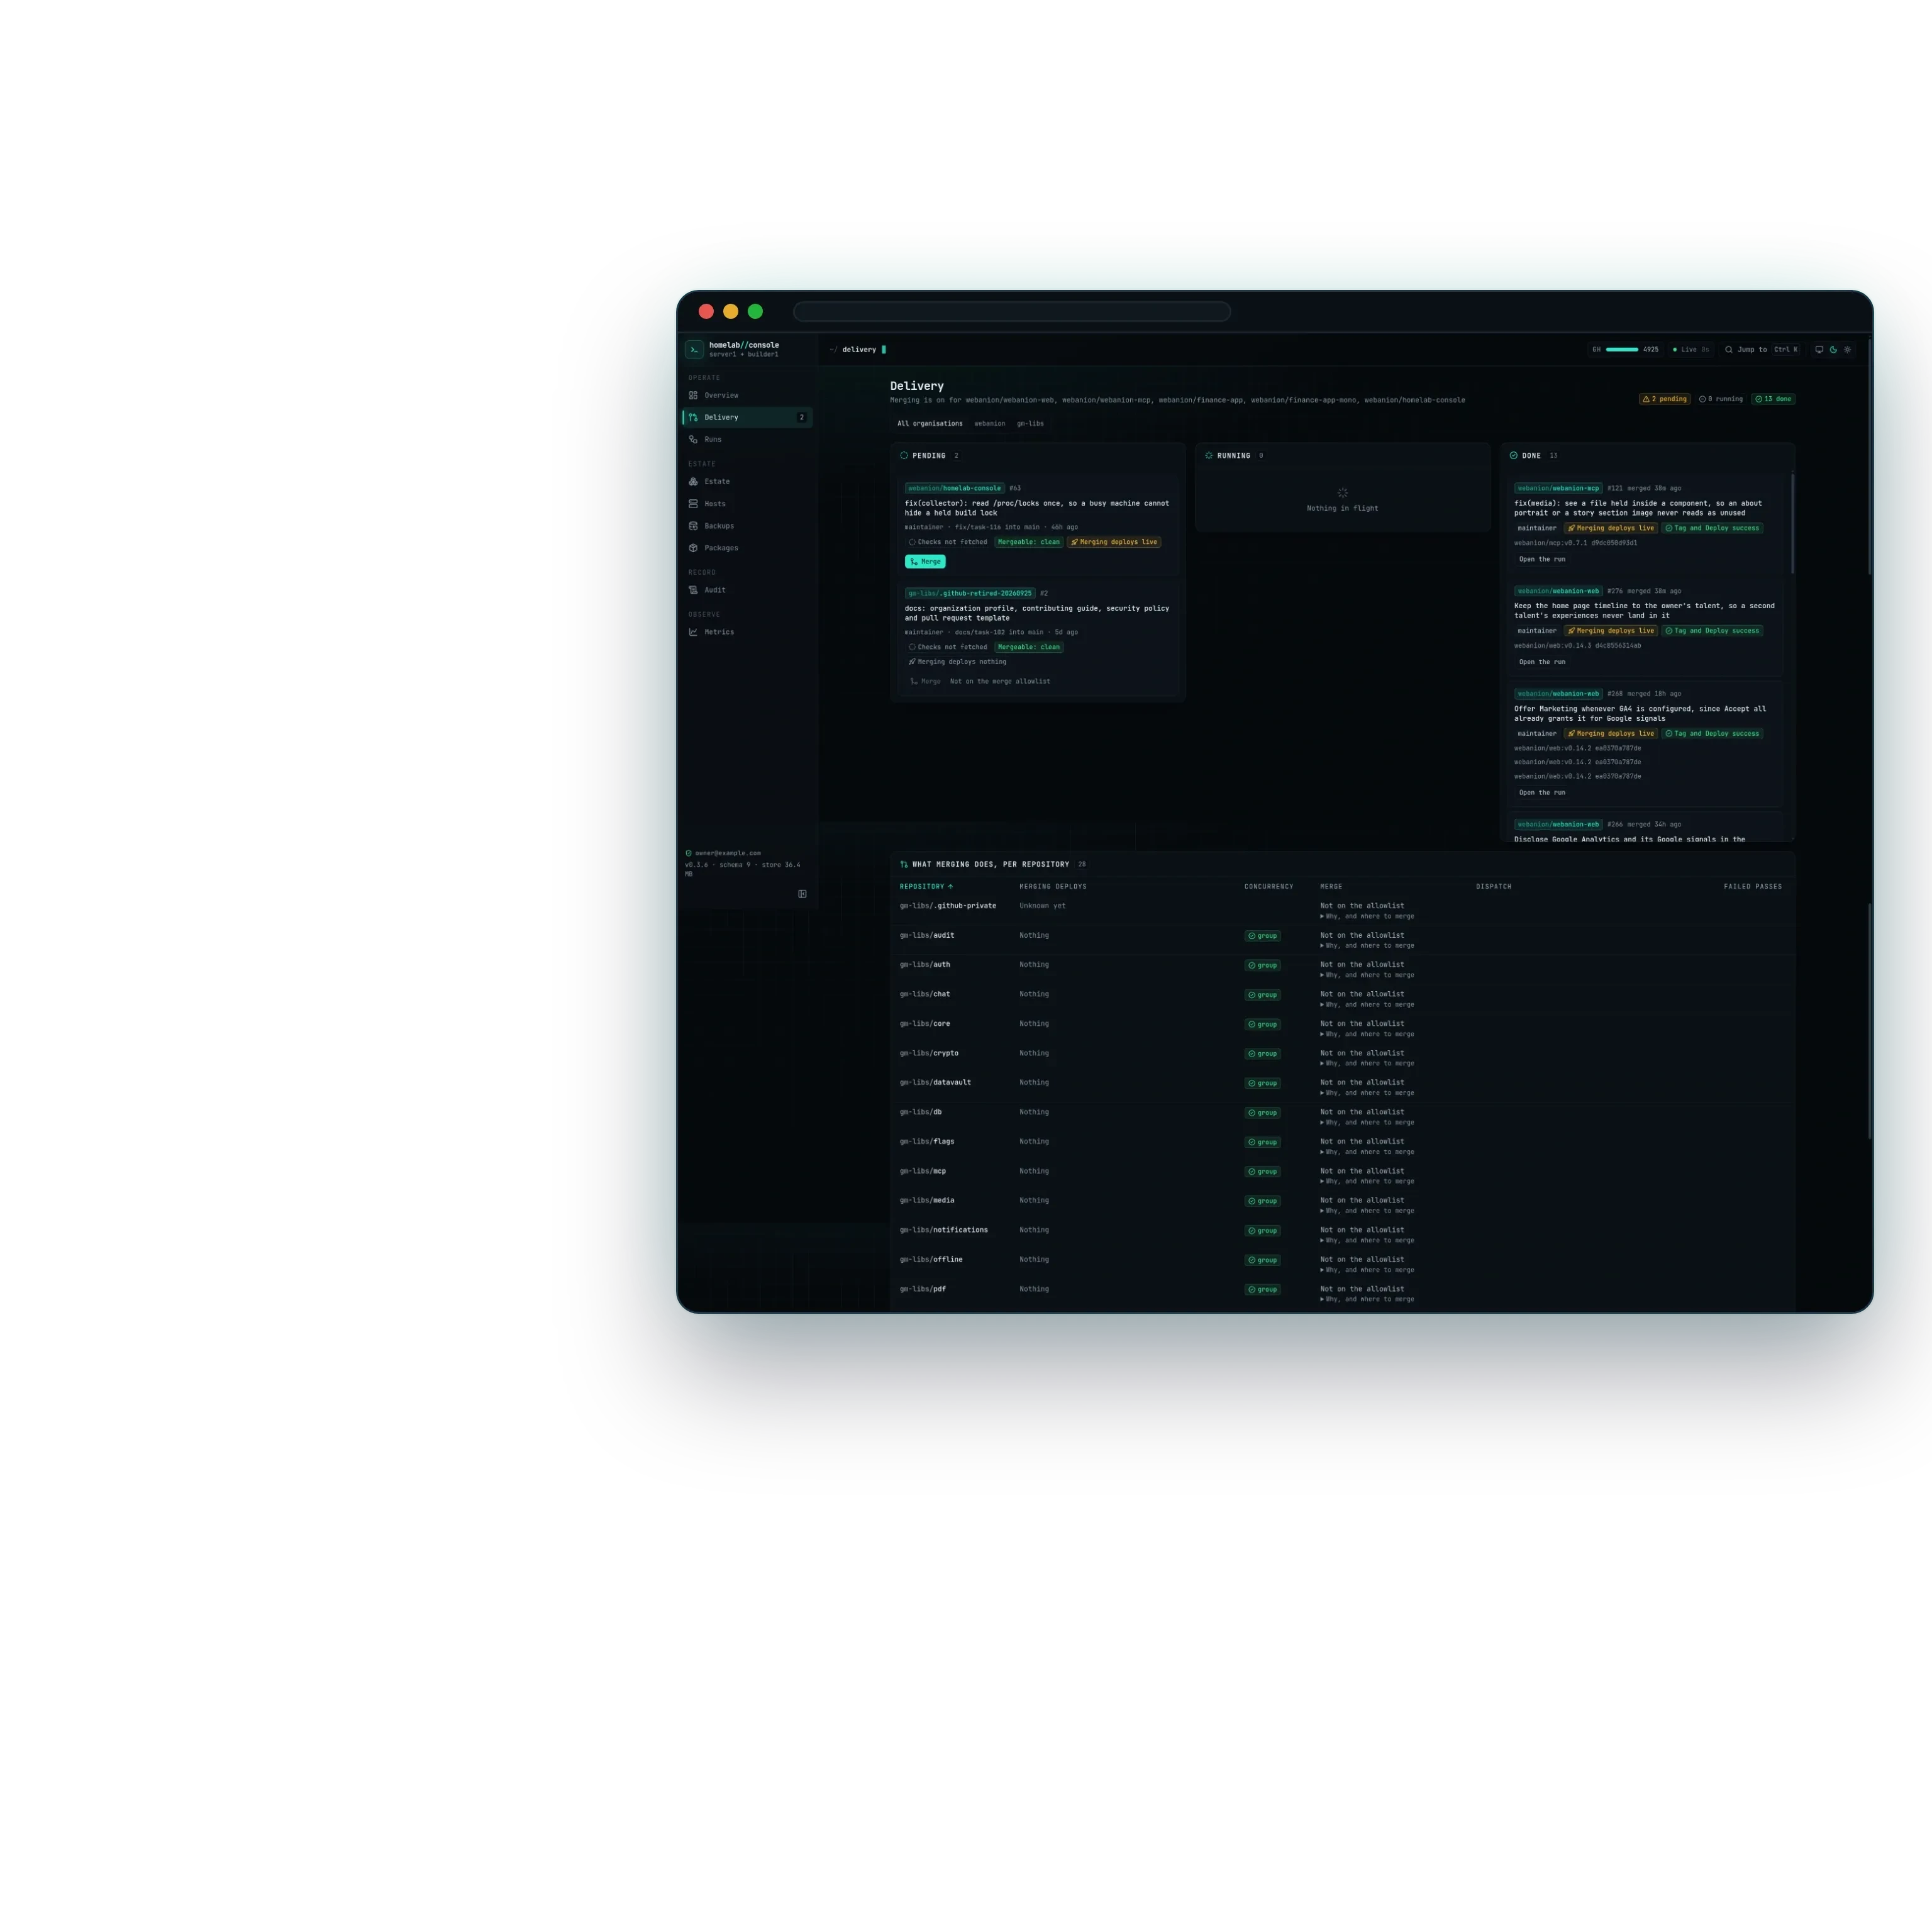
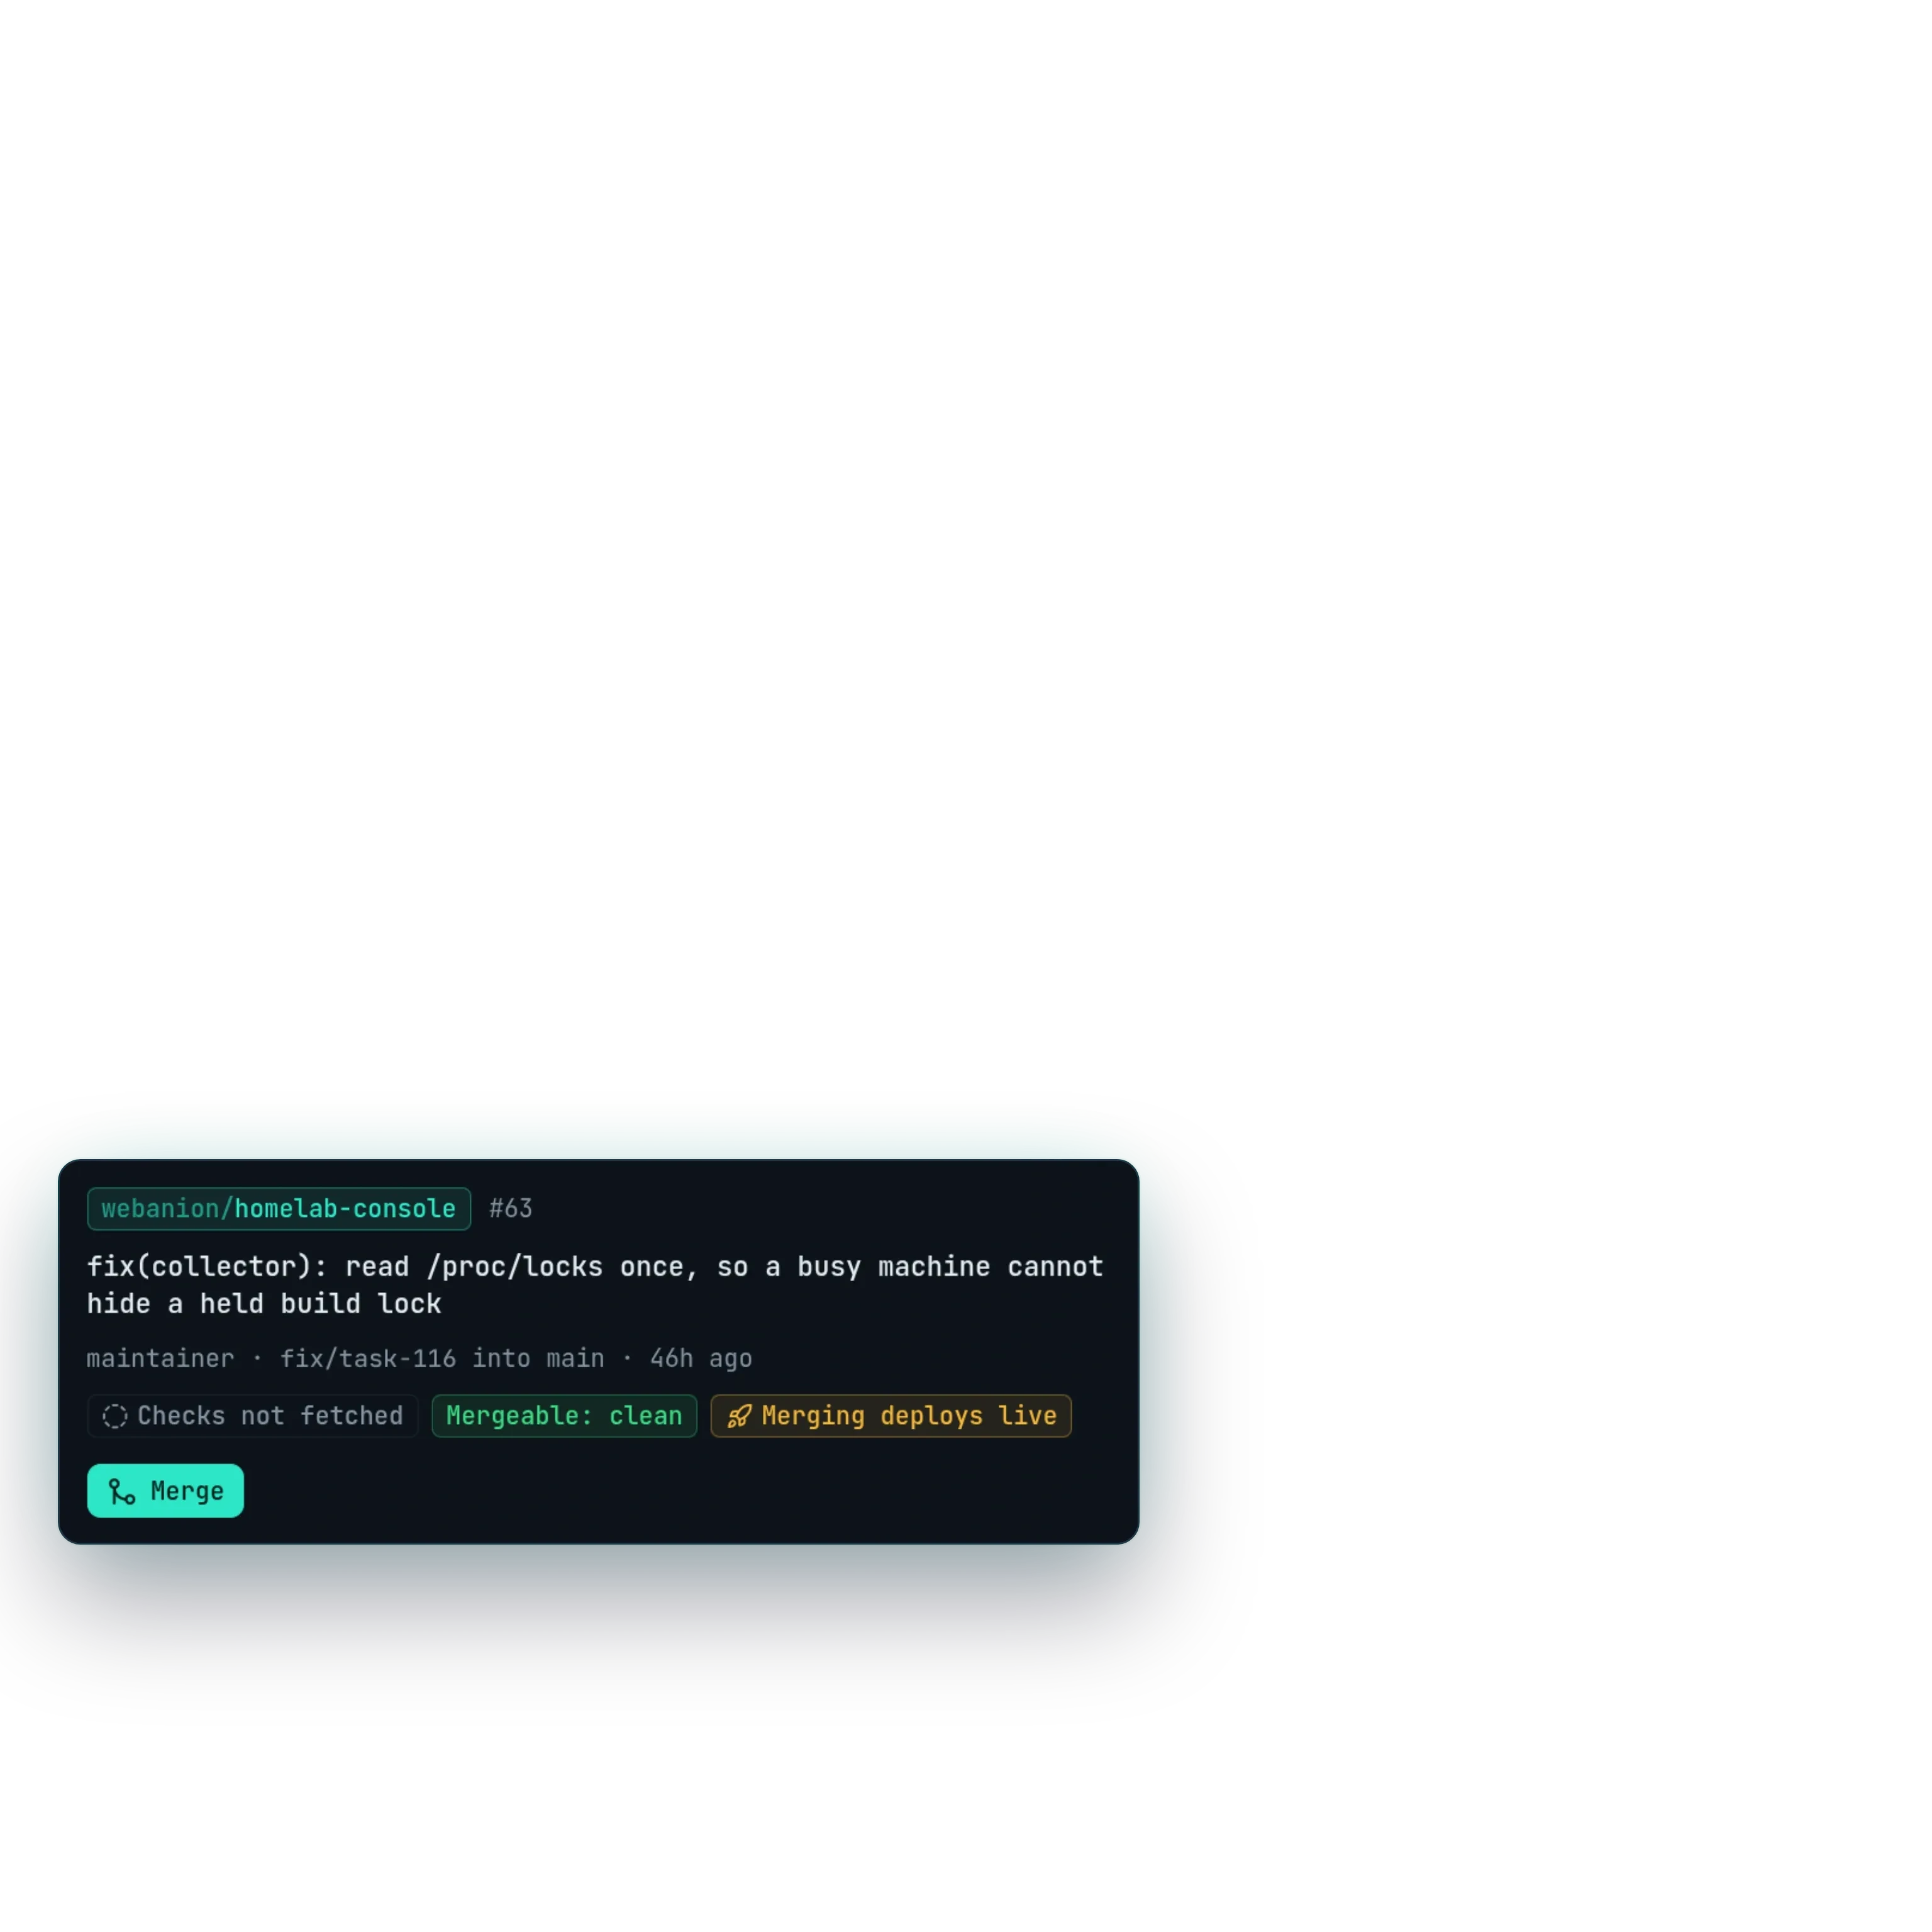
来自工作室各个 GitHub 组织的拉取请求都在同一块看板上,分为待处理、运行中和已完成,每张卡片都写明合并后会发生什么:部署到线上、部署到预发布环境,或者什么都不做。看板下方有一张表格,逐个仓库列出能否从这里合并、不能时的原因、它的并发组,以及它的工作流能否手动触发。
从看板发起的合并靠防护,而不是靠信任。在按下按钮的那一刻,服务器会重新读取拉取请求,绝不在检查未通过或仍是草稿时合并,始终使用合并提交,并且在任何会部署到线上的操作之前,要求输入仓库的完整名称。对于一周交付好几个产品的工作室来说,这就是事先知道一次合并会做什么与事后才发现之间的区别。截图当天,看板上有 2 个待处理的拉取请求和 13 个已完成的,每张已完成的卡片都附有它部署的镜像。
每晚都会报到的备份
集群上的每个数据库每晚都会导出,彼此间隔一刻钟,避免两个同时开始;每次导出都会在旁边写下每张表的行数,恢复验证把一次备份恢复到一个一次性的命名空间时,核对的正是这些数字。控制台自己的归档是唯一无法由其他东西重建的存储,它通过 SQLite 的在线备份复制,并在保存之前检查完整性和行数。每个任务在一次经过验证的运行之后,都会向家门之外的一个“死人开关”发出信号,因此一个失败、卡住或不再被调度的任务,会在第二天早上被发现,而不是等到需要恢复的那一天。
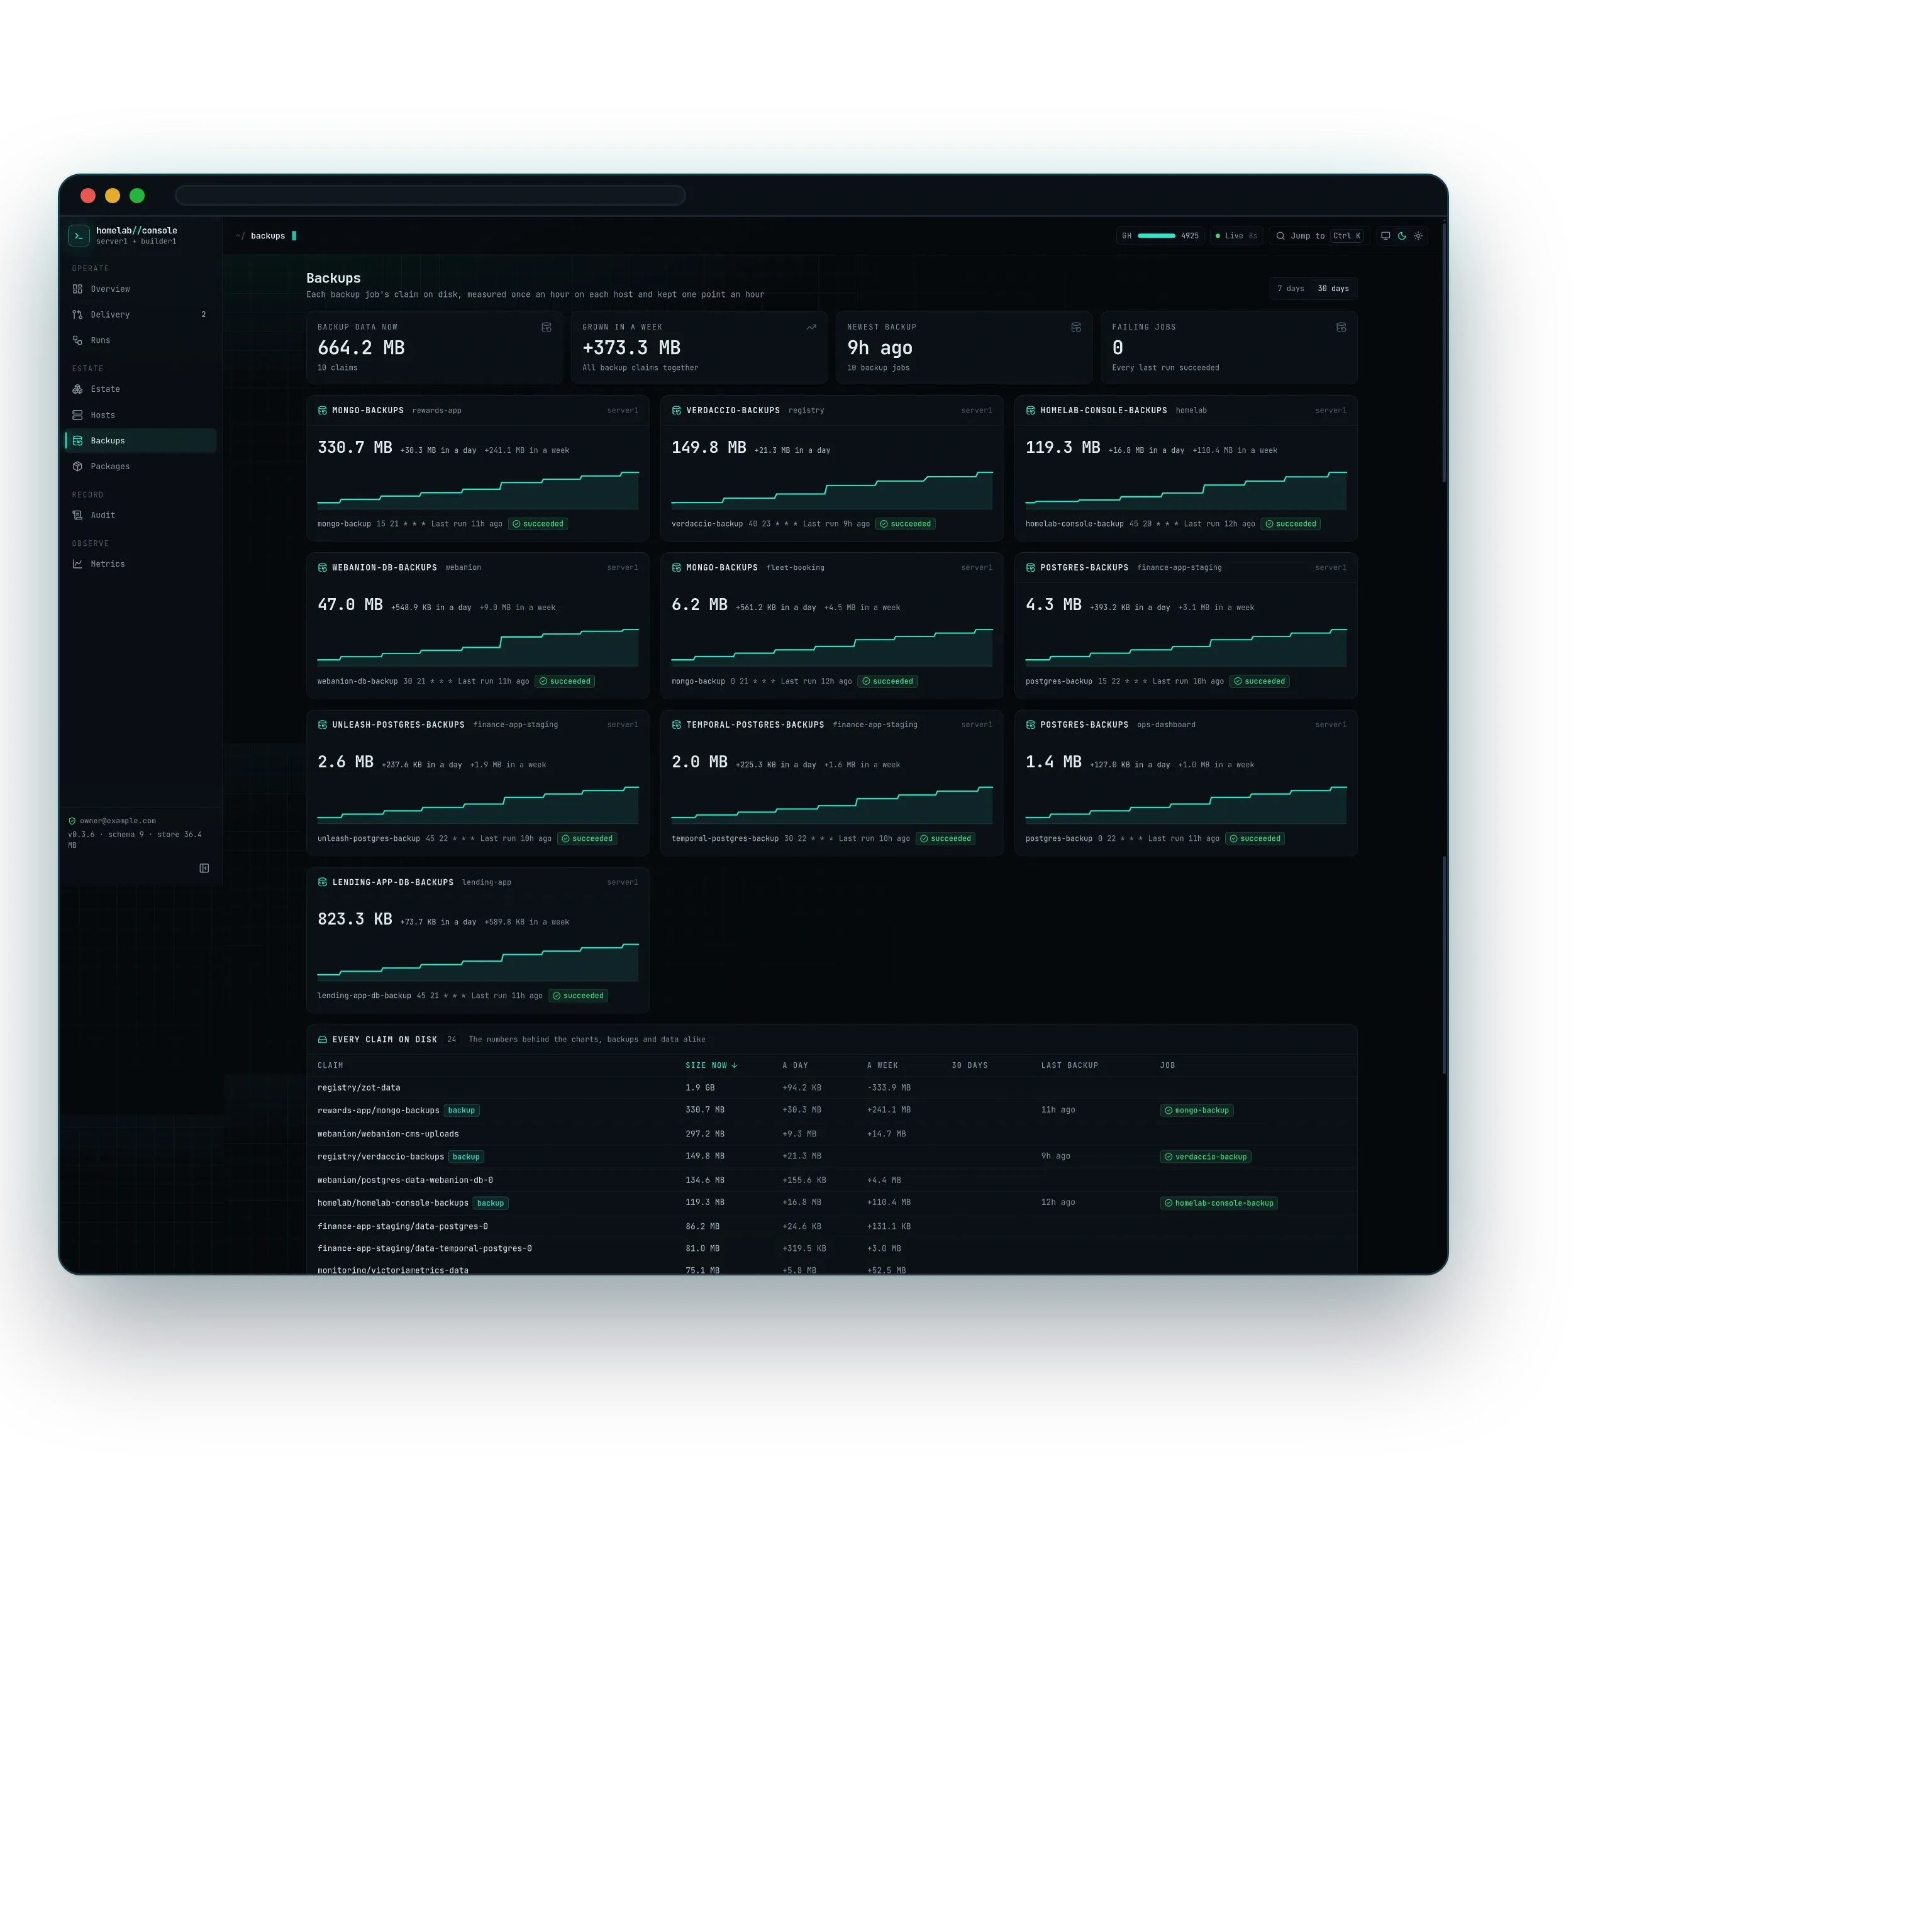
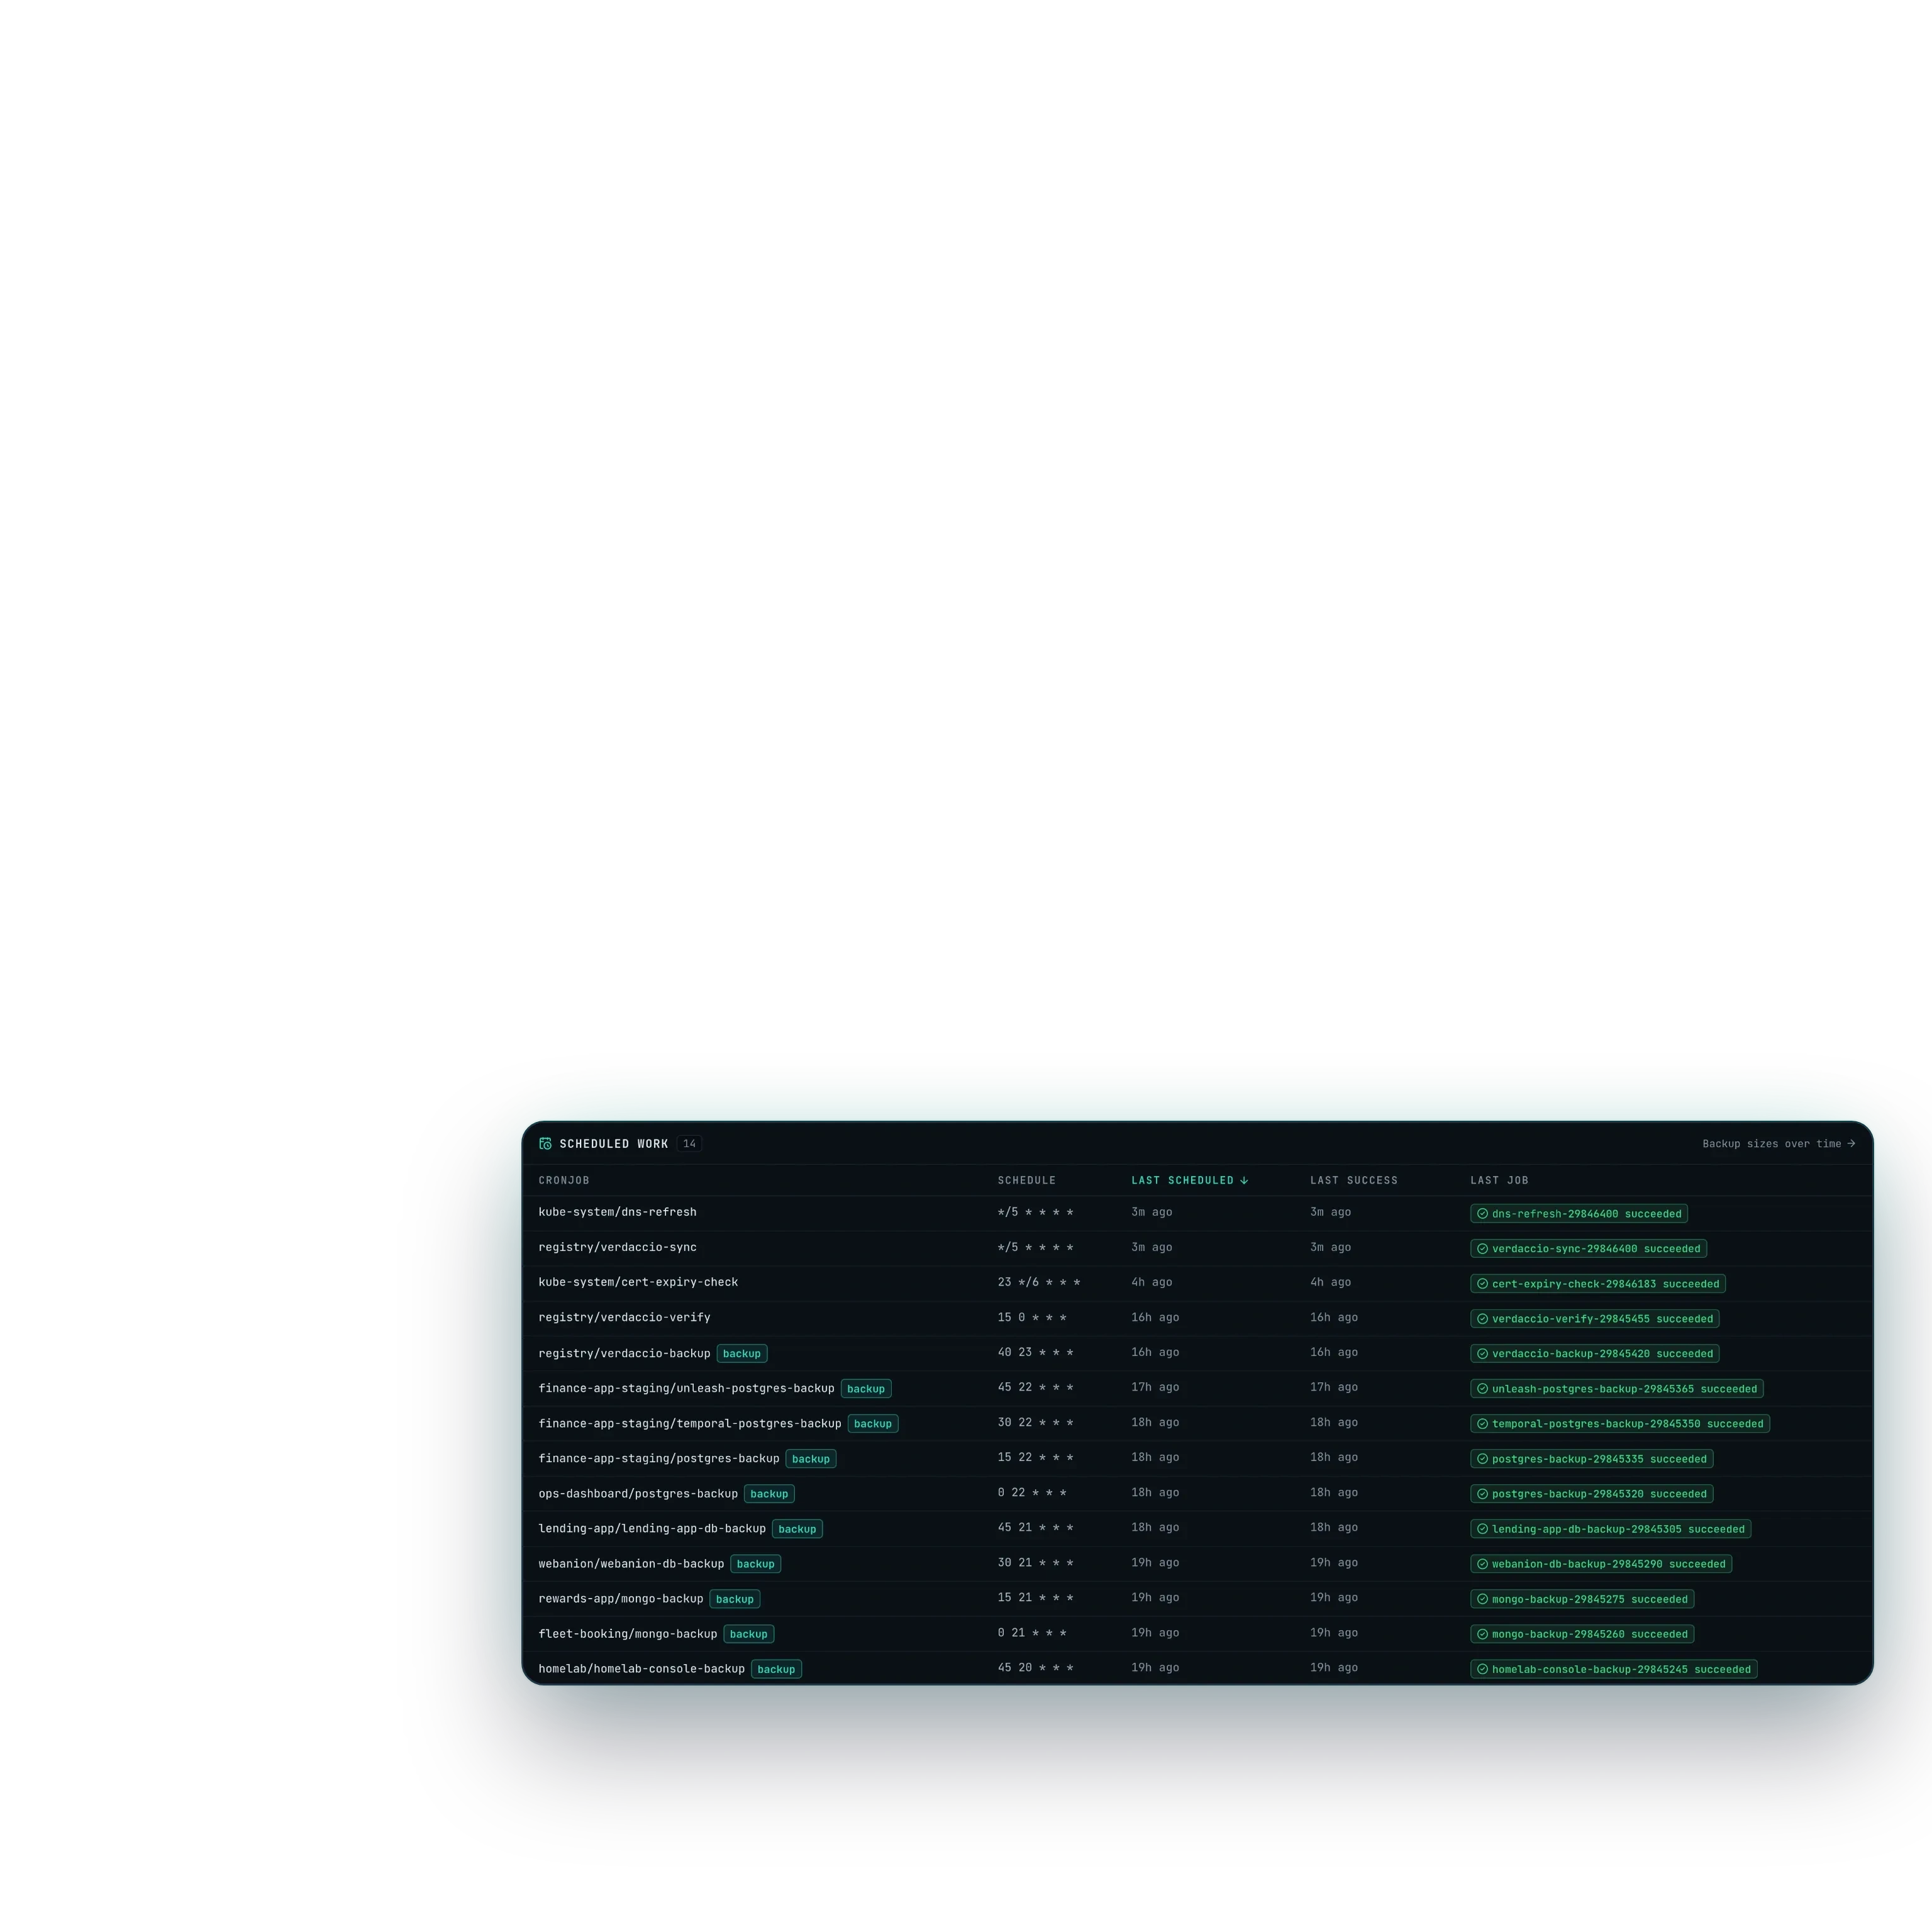
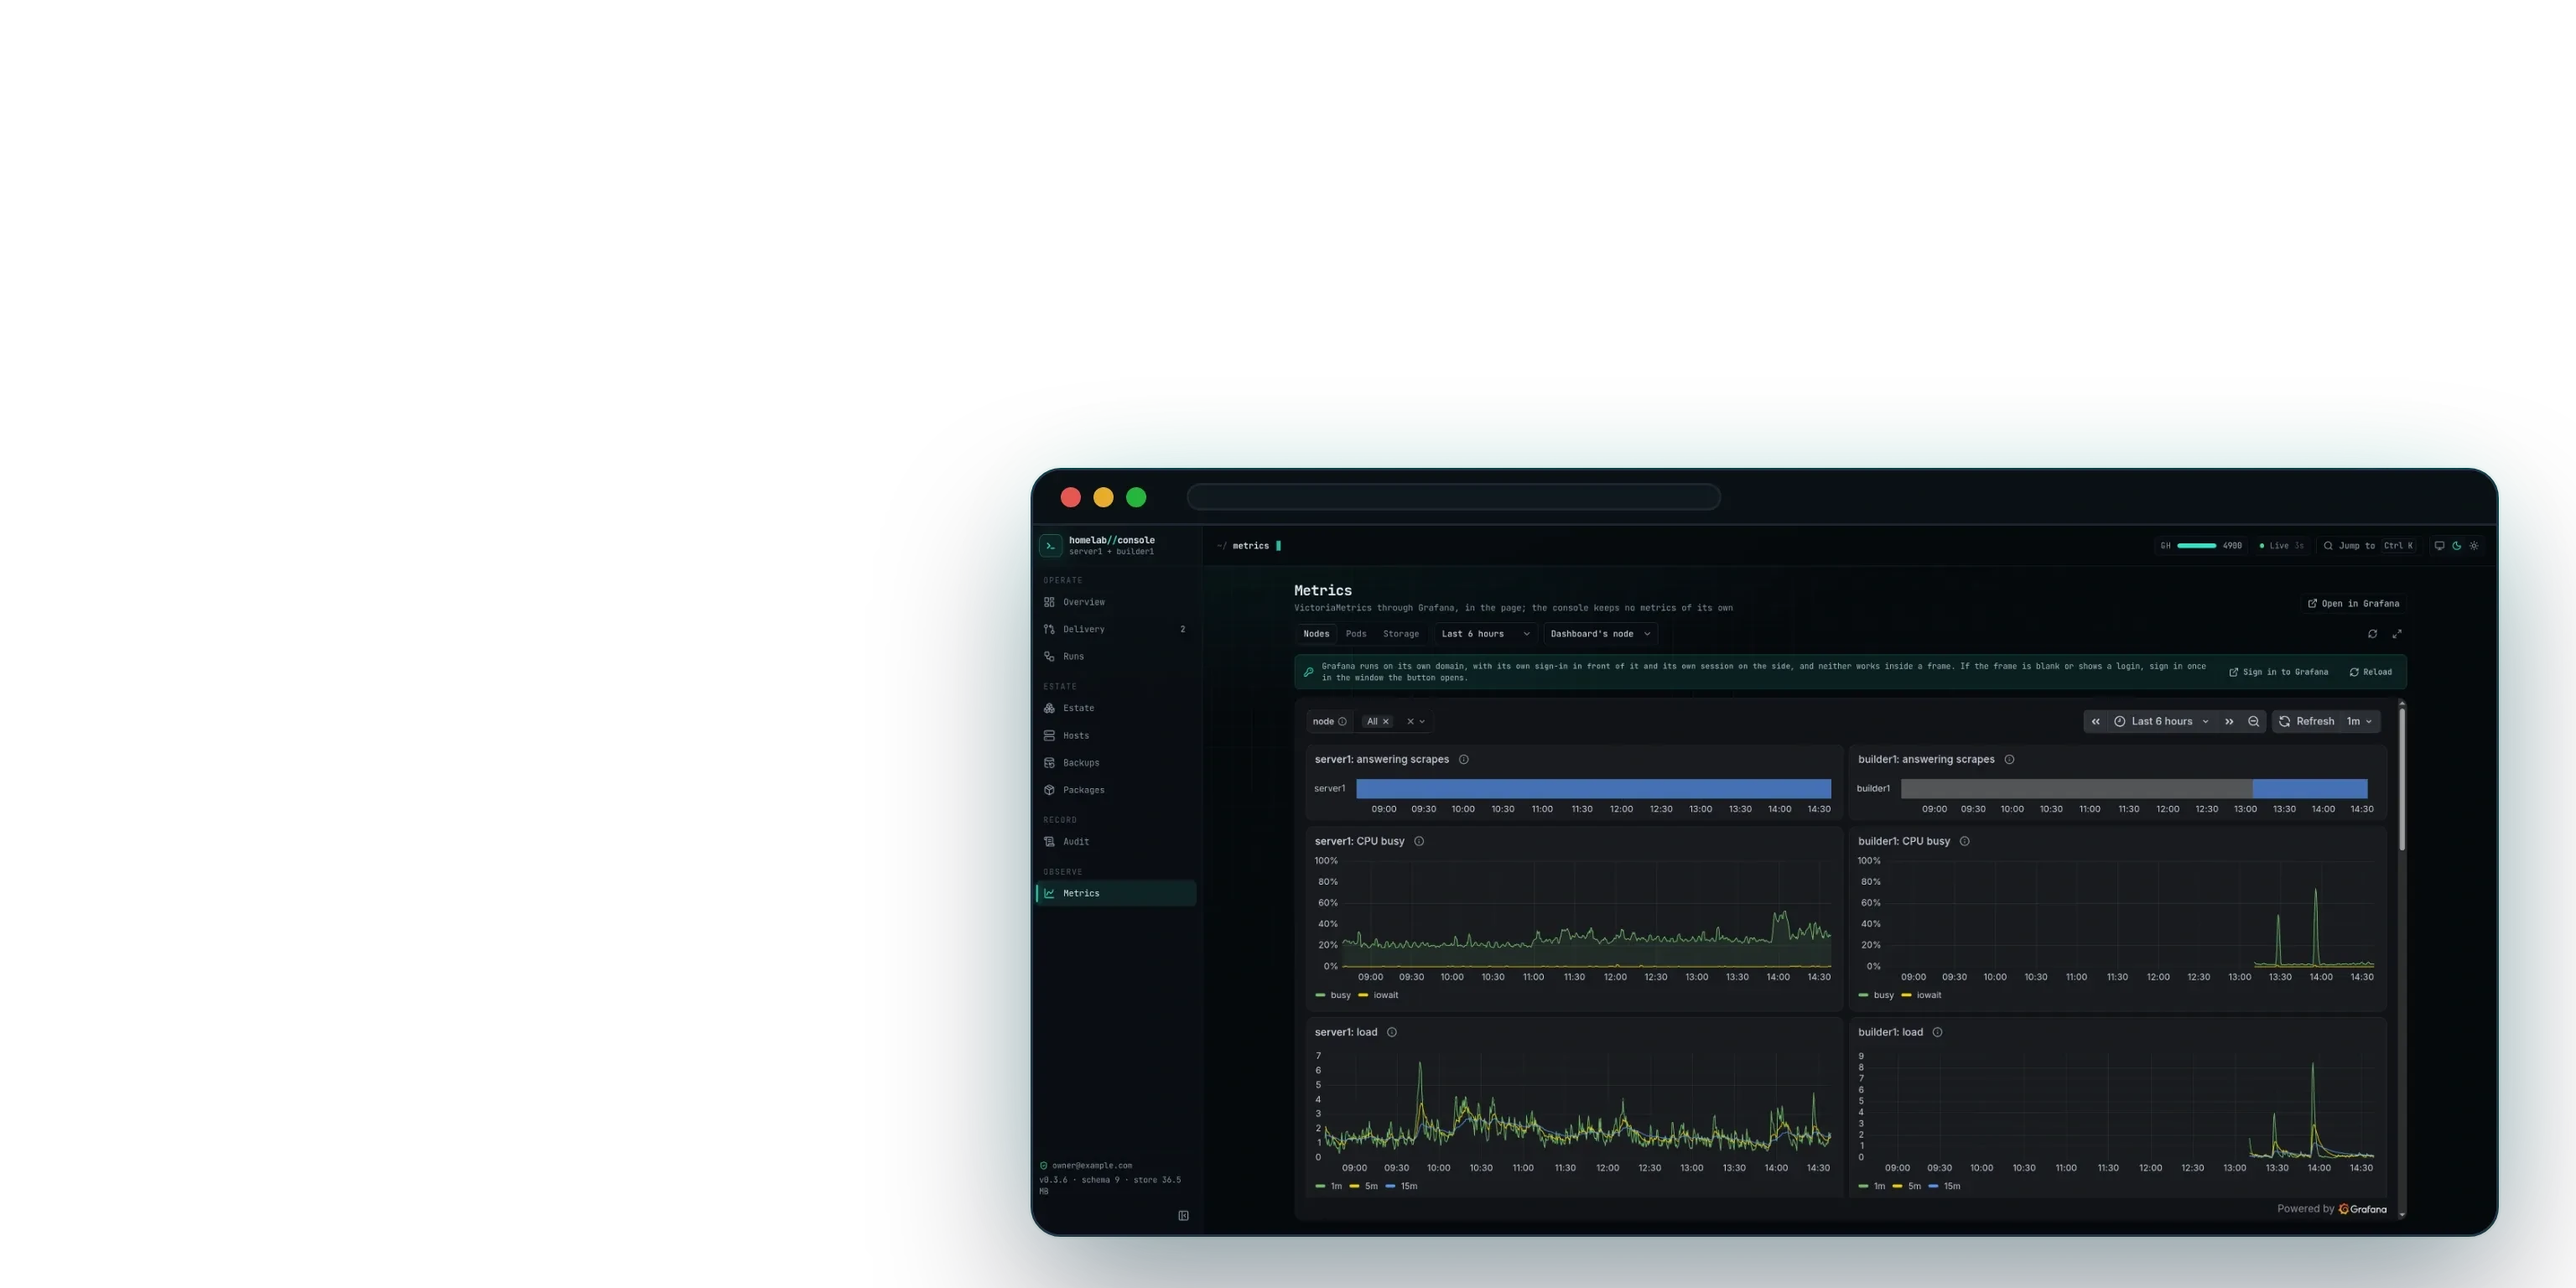
Backups 视图根据每小时的测量,绘制出每个存储卷的增长。截图当天,它显示 10 个存储卷共有 664.2 MB 的备份数据,10 个备份任务,最新一次在 9 小时前,没有失败的任务;Schedules 标签页列出了全部 14 个定时任务,最近一次运行都已成功。
主机、指标,以及家门之外的警报
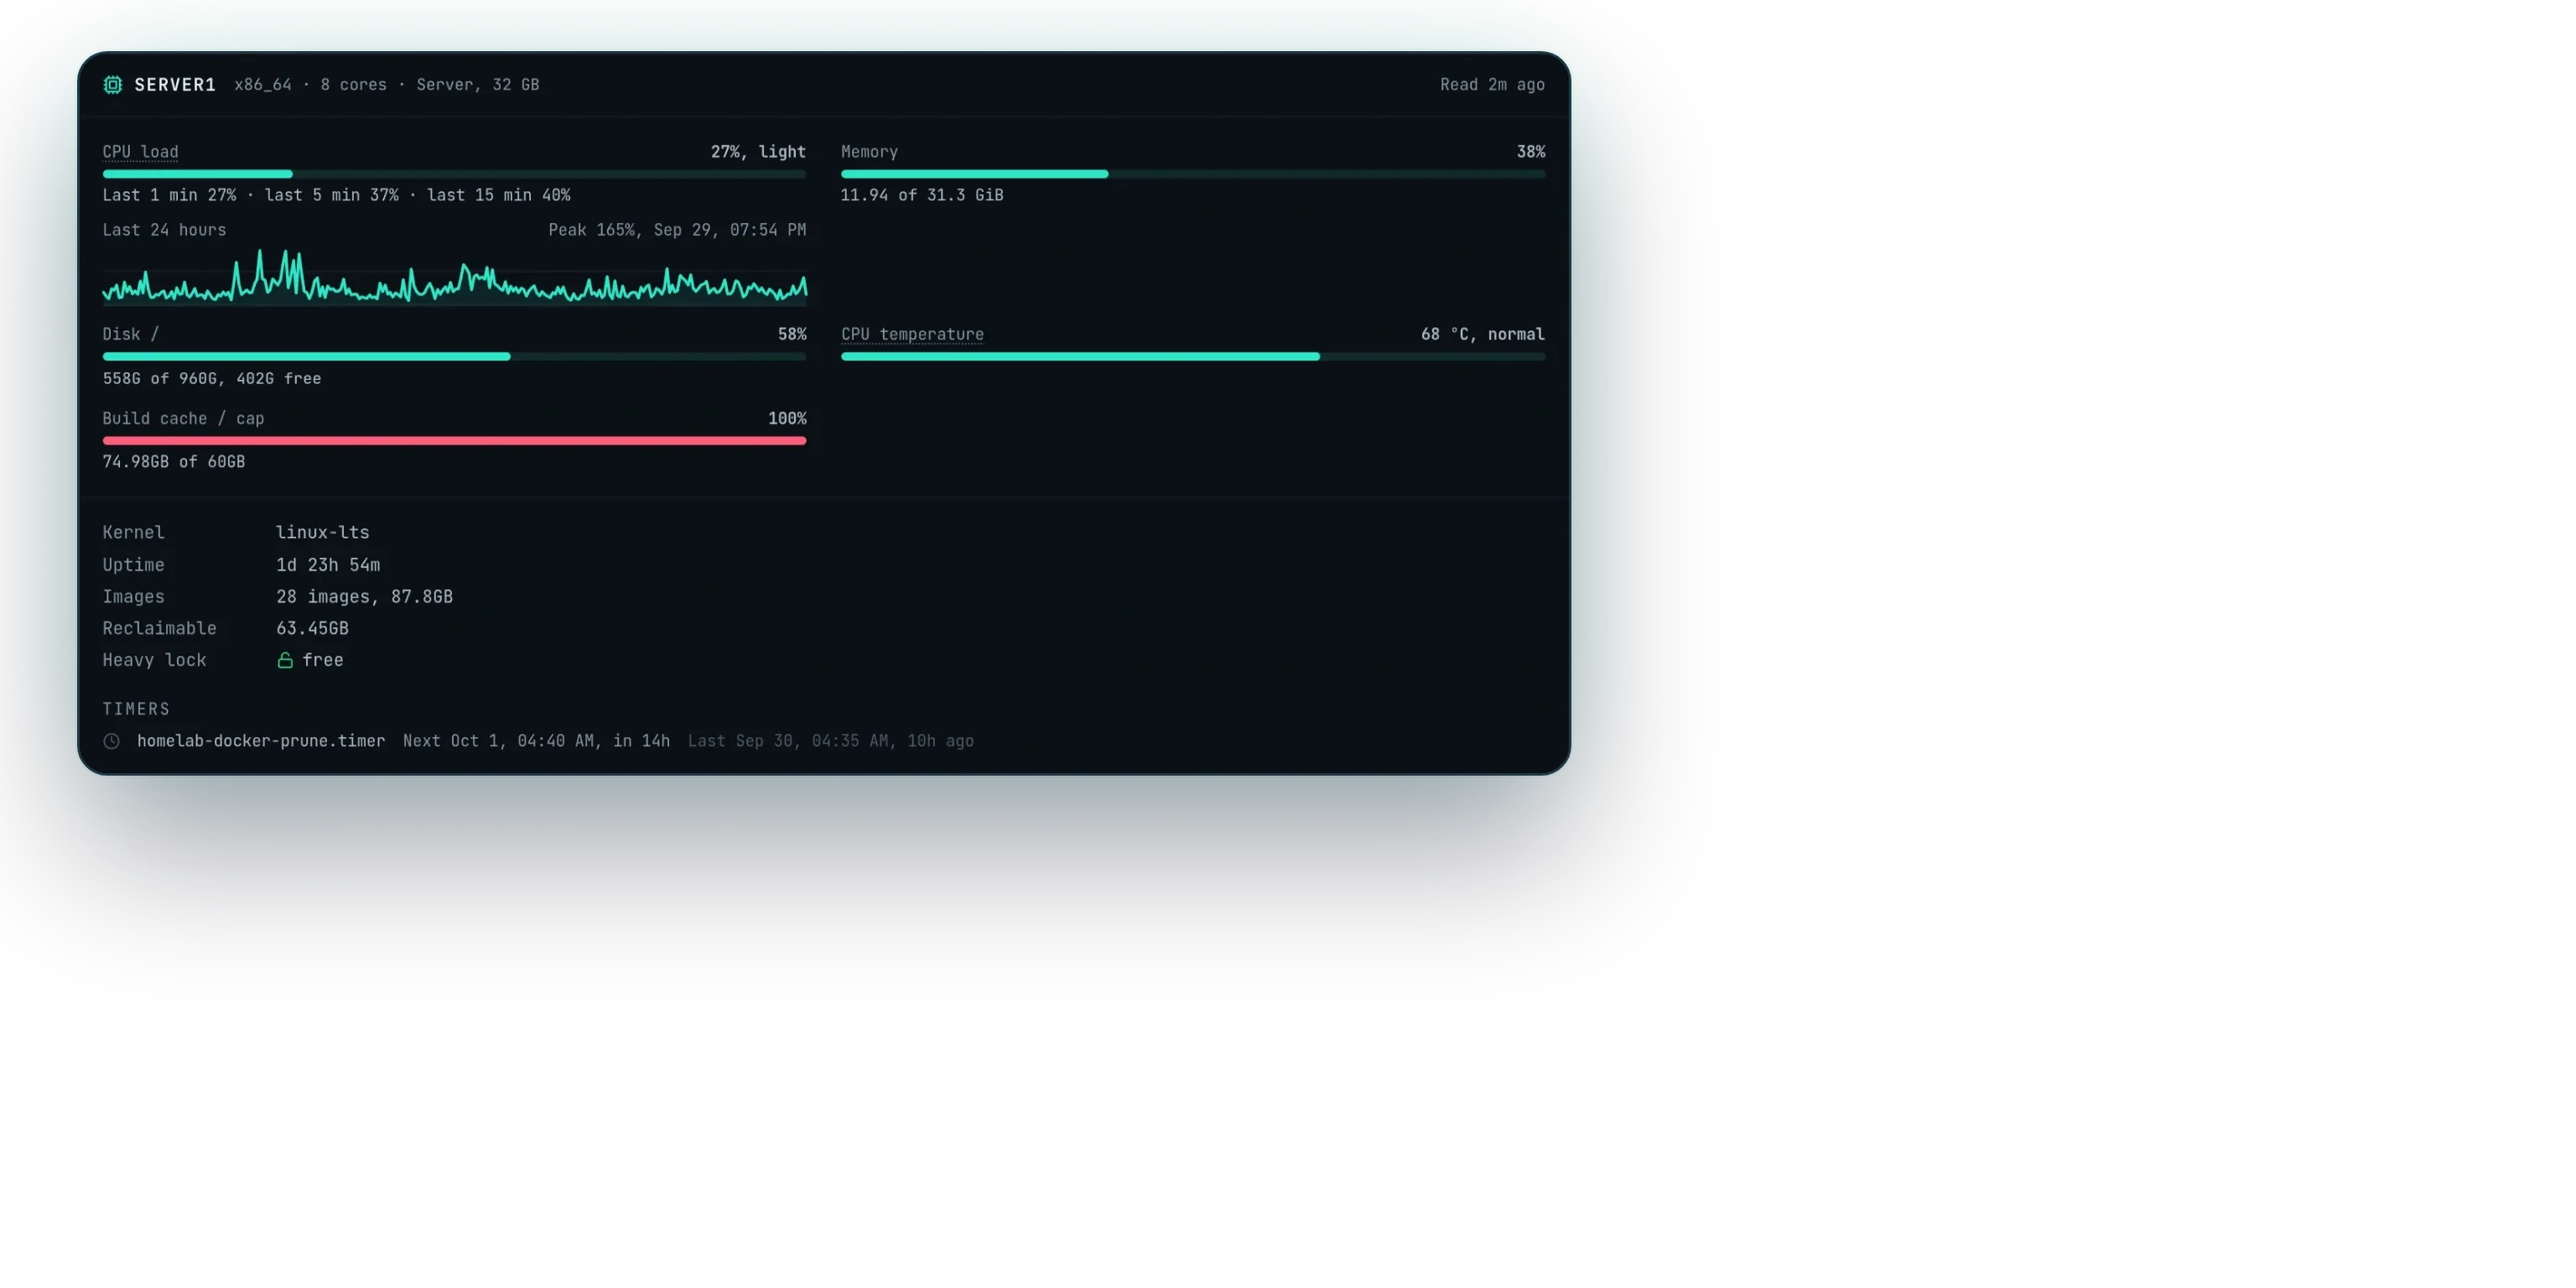
每台主机每五分钟上报一次负载、内存、磁盘、温度和构建缓存,指标存储则在页面内通过 Grafana 查看。集群的告警规则会推送到手机,每小时一次的检查会标出已合并却无人应用的清单文件,Cloudflare 边缘上的宕机监控每分钟检查一次每个公开网站,因为运行在集群上的监控,无法报告集群本身宕机。
所有设施,一张图看全
家庭实验室提供的一切,按角色而不是按机器画出:边缘的隧道和路由器,集群,数据库及其存储卷,容器镜像仓库和 npm 仓库,运行器池,每晚的备份及其开关,指标存储及其告警,家门之外的宕机监控,以及读取这一切的控制台。

每一次操作都有记录,被拒绝的也不例外
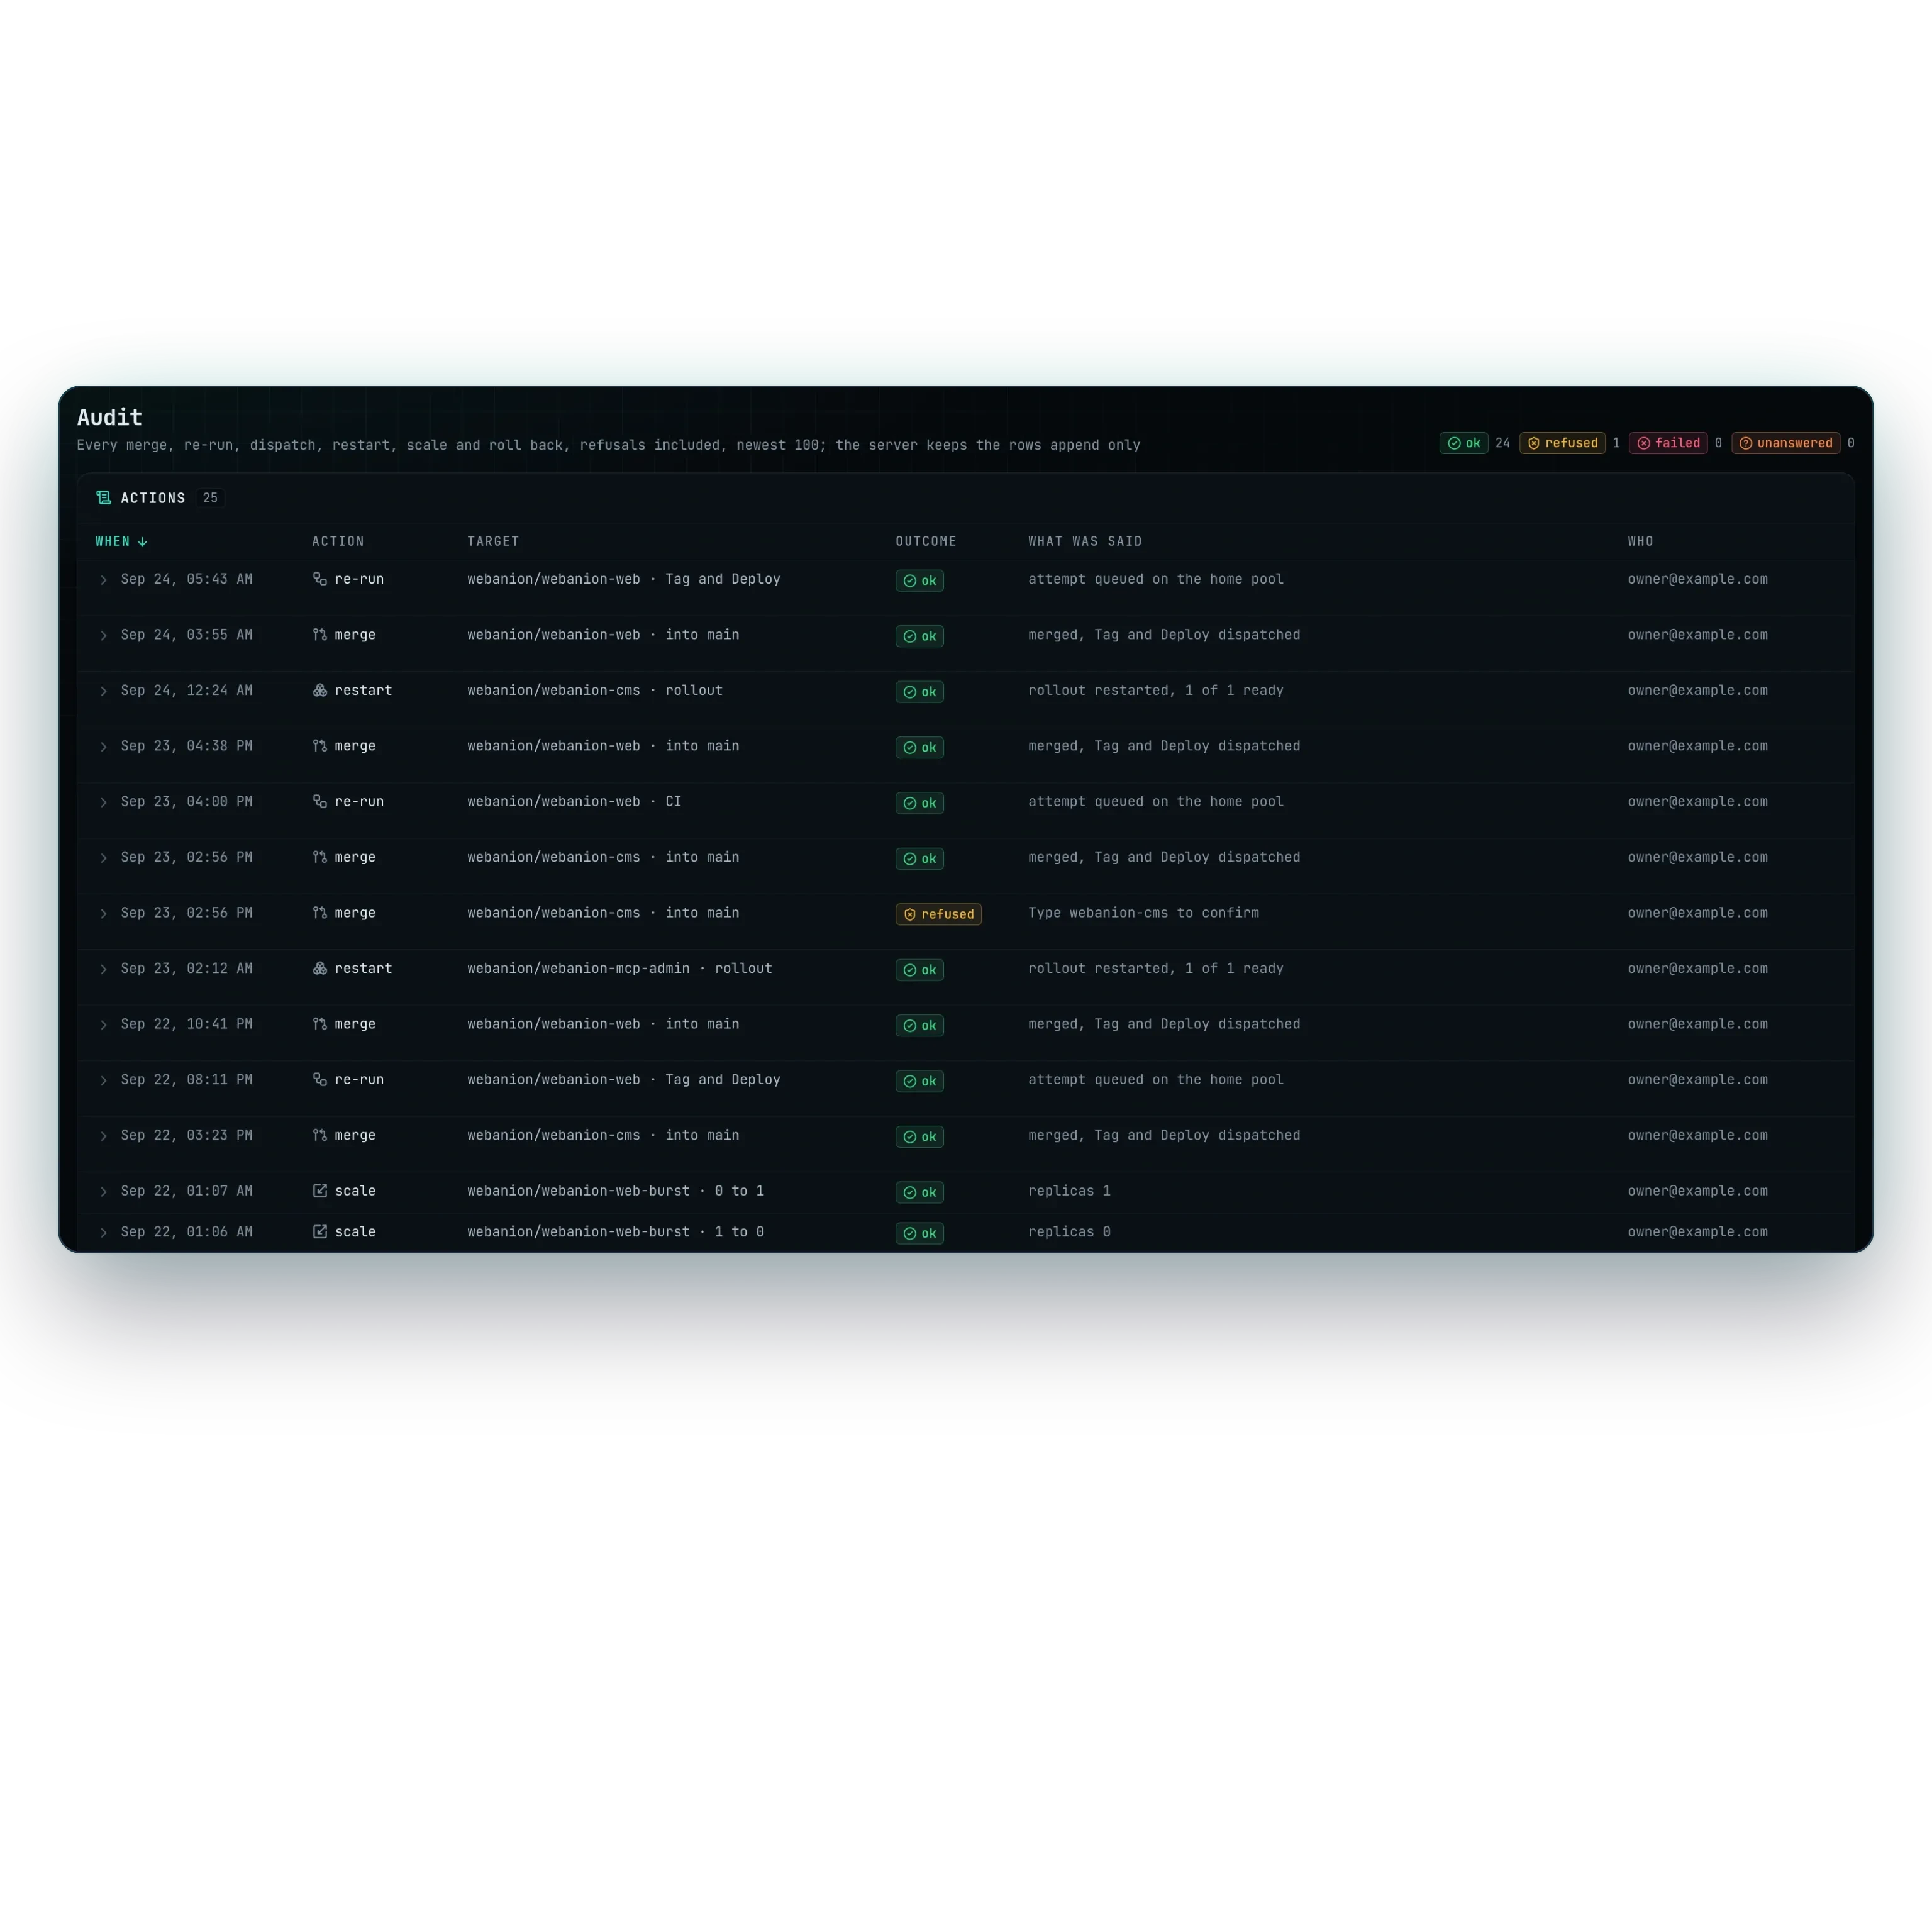
控制台不只是读取。合并、重新运行、手动触发、重启、扩缩第二个副本以及回滚,都可以在页面上直接完成,每一次都通过第二个身份写入,这个身份的权限逐一列出它可以触碰的每个对象,并且只为这一次操作申请一个令牌,用完即弃。在任何操作发生之前,控制台都会重新读取实时状态,把每个前提条件列为通过、警告或拒绝,任何会部署到线上的操作都需要输入其名称来确认。
每一次操作都会变成一行只追加、不修改的记录:时间、操作、目标、结果和返回的说明,被拒绝的也包括在内,因此一次被拒绝操作的记录,和一次成功操作的记录一样完整。同一个归档还保存着 GitHub 会删除的内容:每次运行在完成时即被归档,日志正文保留一年,记录行永久保留,超出 GitHub 默认九十天的保留期。
每天维护,以及它的价值
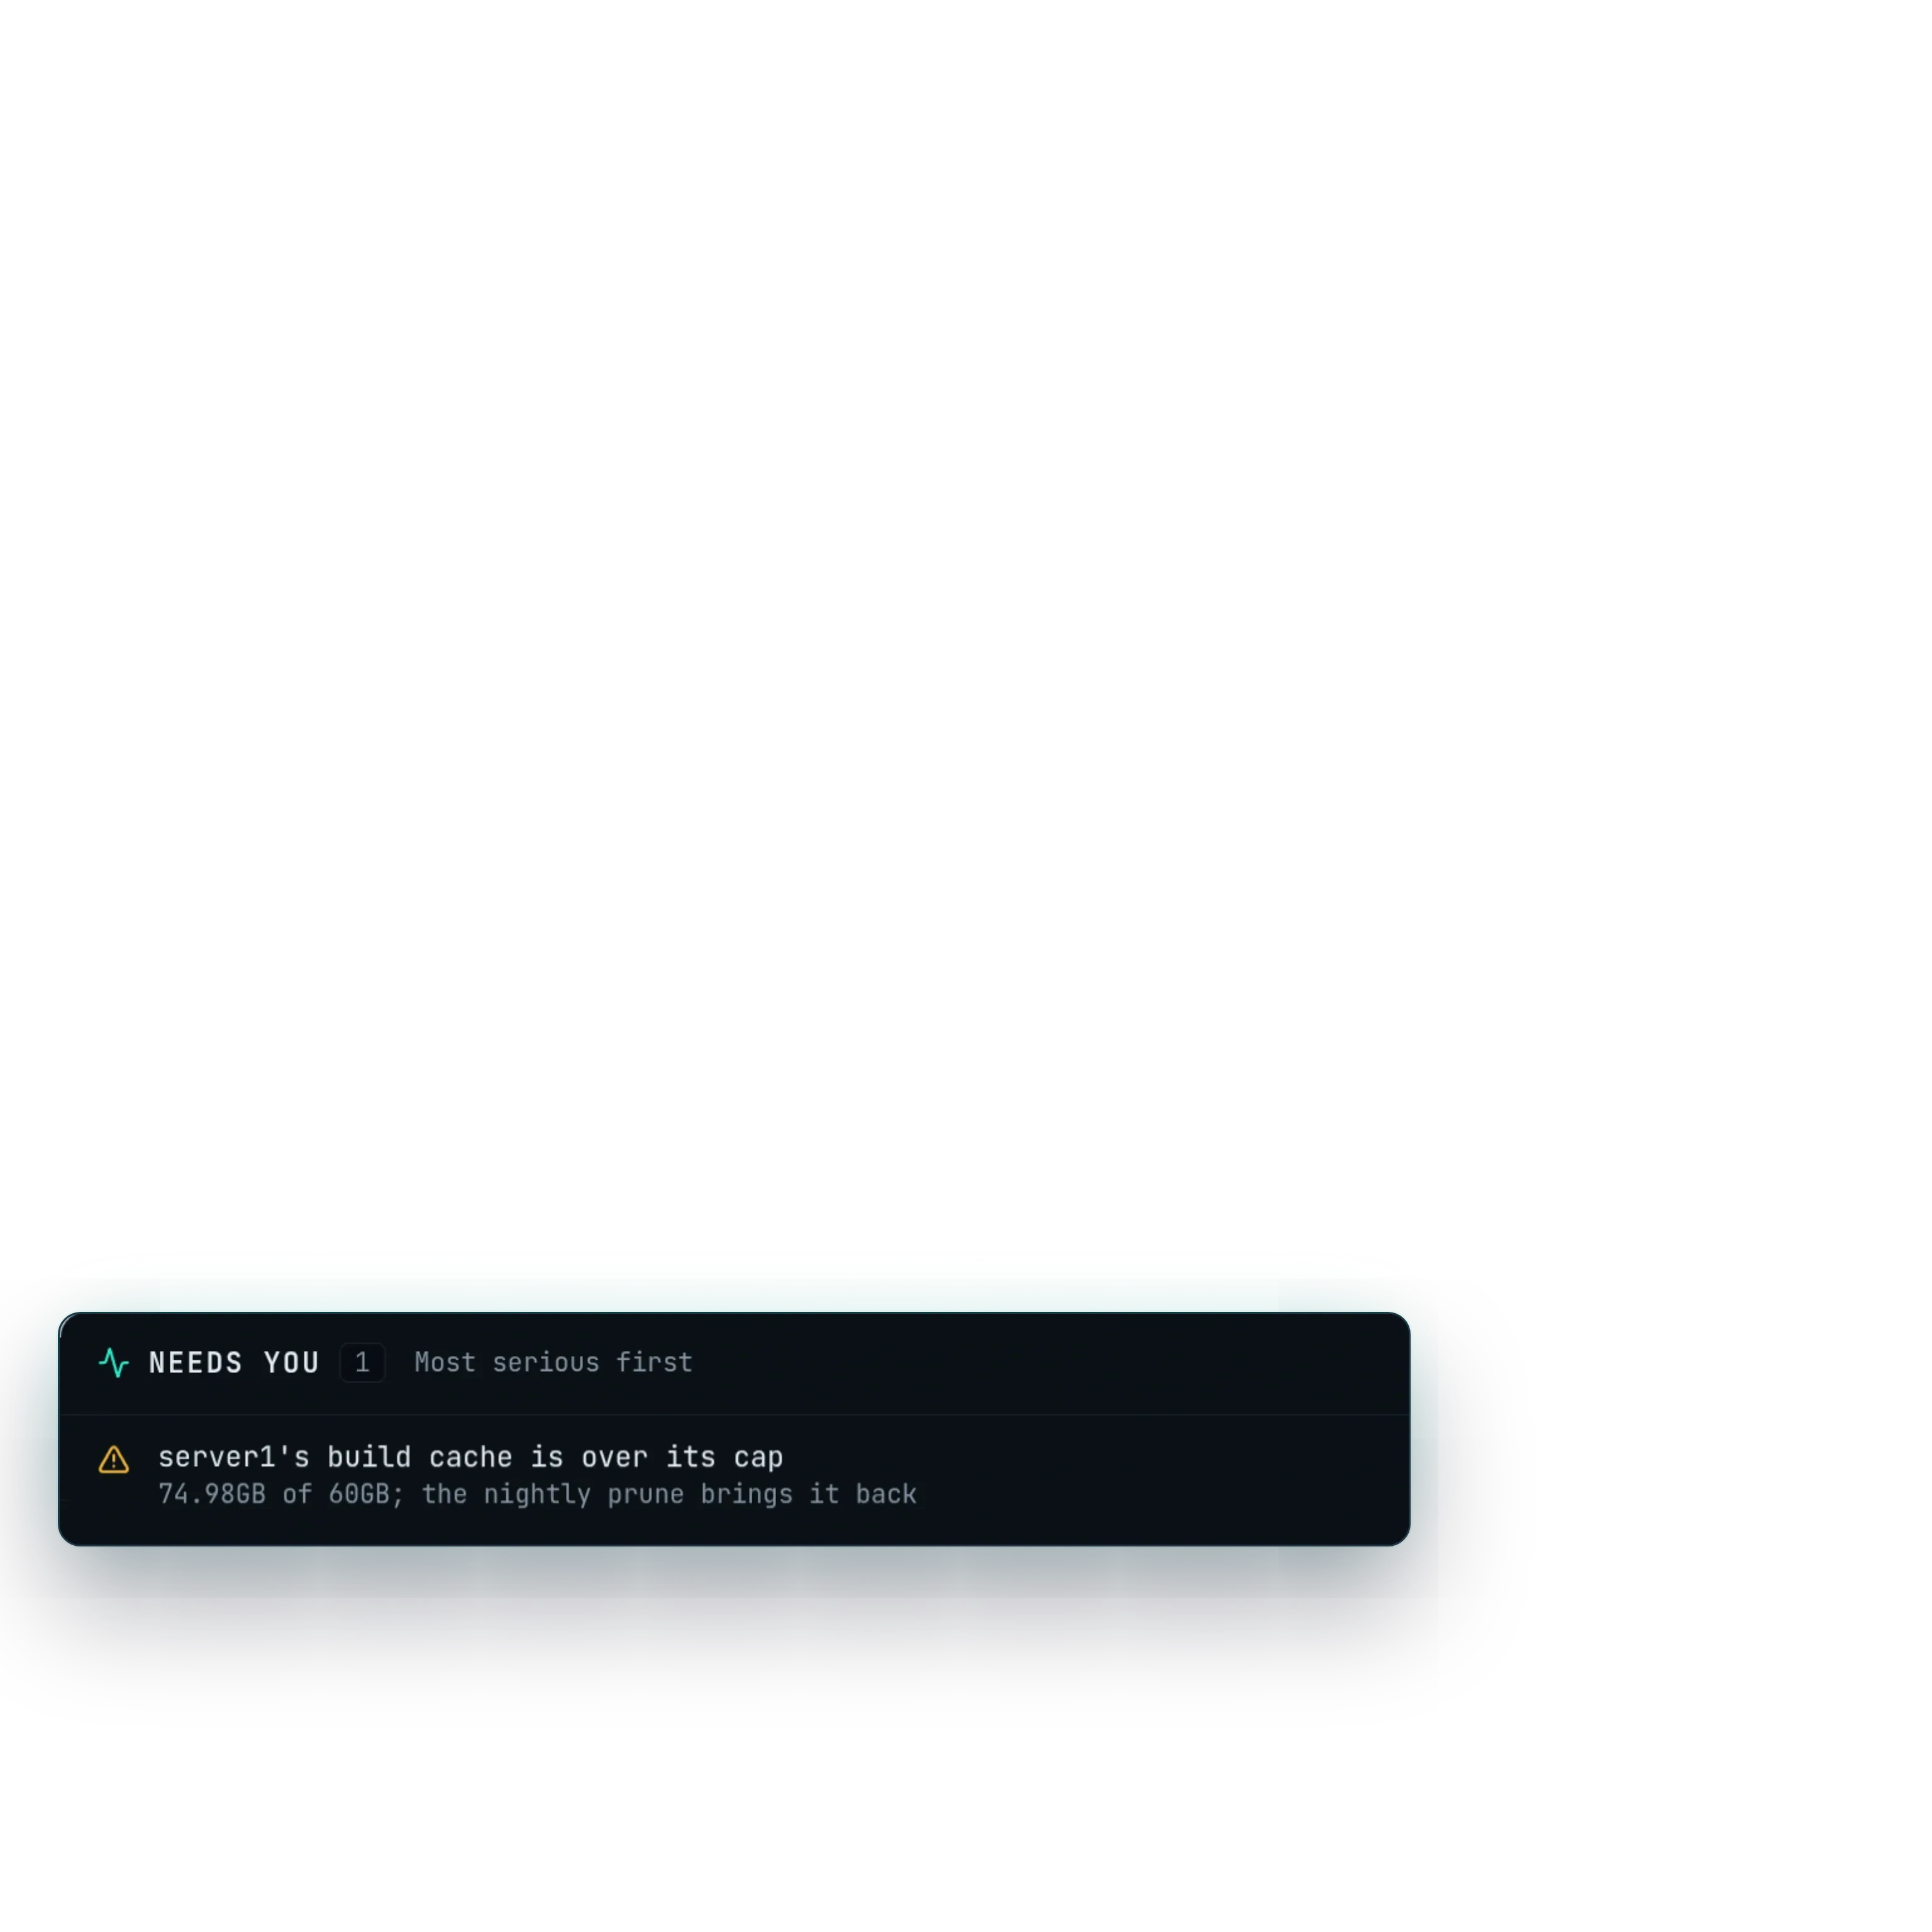
日常工作很短,因为大部分由工具承担:早上控制台里那份需要动手处理的清单,每小时一次、能发现已合并却无人应用的清单文件的漂移检查,夜里有任何故障都会通知的手机,只要每个任务按时报到就保持安静的备份开关,以及在证书到期前几周就发出提醒的证书检查。截图当天,那份清单上只有一项:一个超出上限的构建缓存,每晚的清理会把它降回来。这类小偏差,当天修复代价很小,一个月后才发现代价就很大。
坦白说,代价是必须有人负责。自己掌握整套技术栈,意味着证书、磁盘和升级是工作室的问题,而不是供应商的问题;一个没有人照看基础设施的团队,还是租用更好。对于希望自己的基础设施是能看懂的东西、而不是一叠发票的创始人或小团队,以及希望看到证据、证明自己付费的平台每天都有人照看的客户,这就是它在实践中的样子。Webanion 平台就运行在它上面,而它促成的事情也有各自的故事,例如在不改动任何应用的情况下,把一个节点扩展成集群,以及把构建从托管 CI 迁移到家中的运行器池和私有镜像仓库。
警报送达手机,警报本身也有人看守
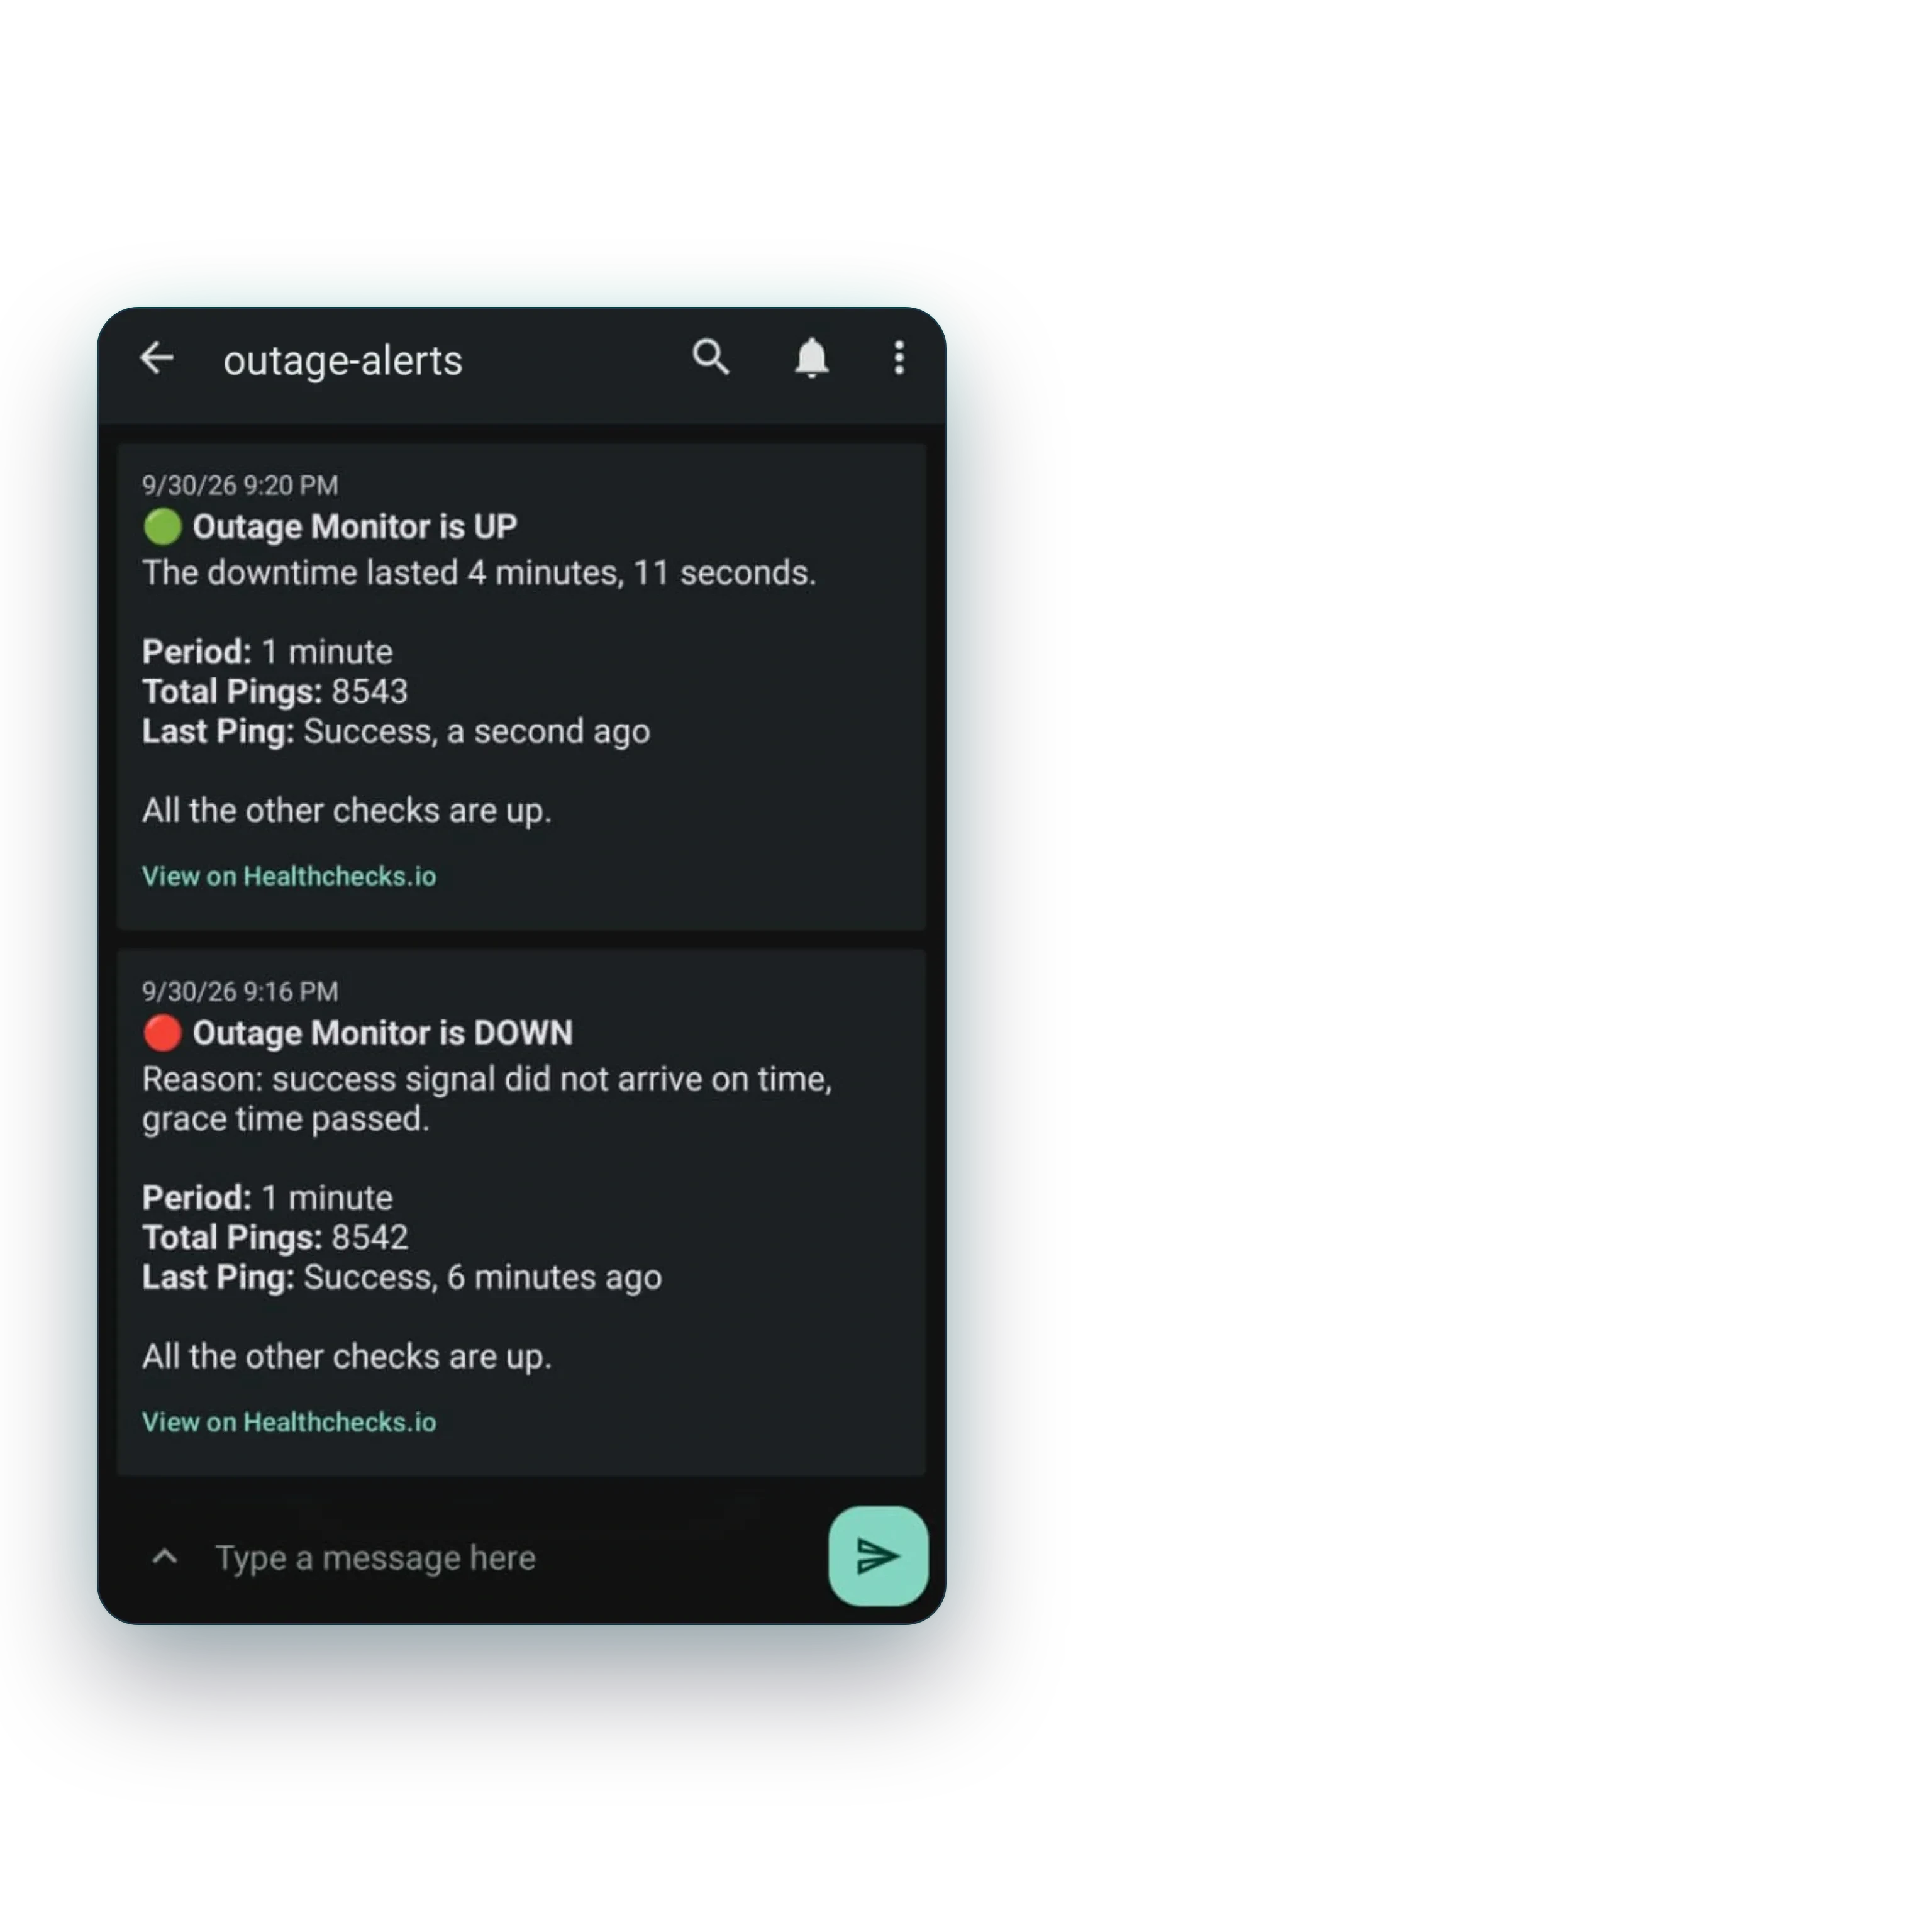
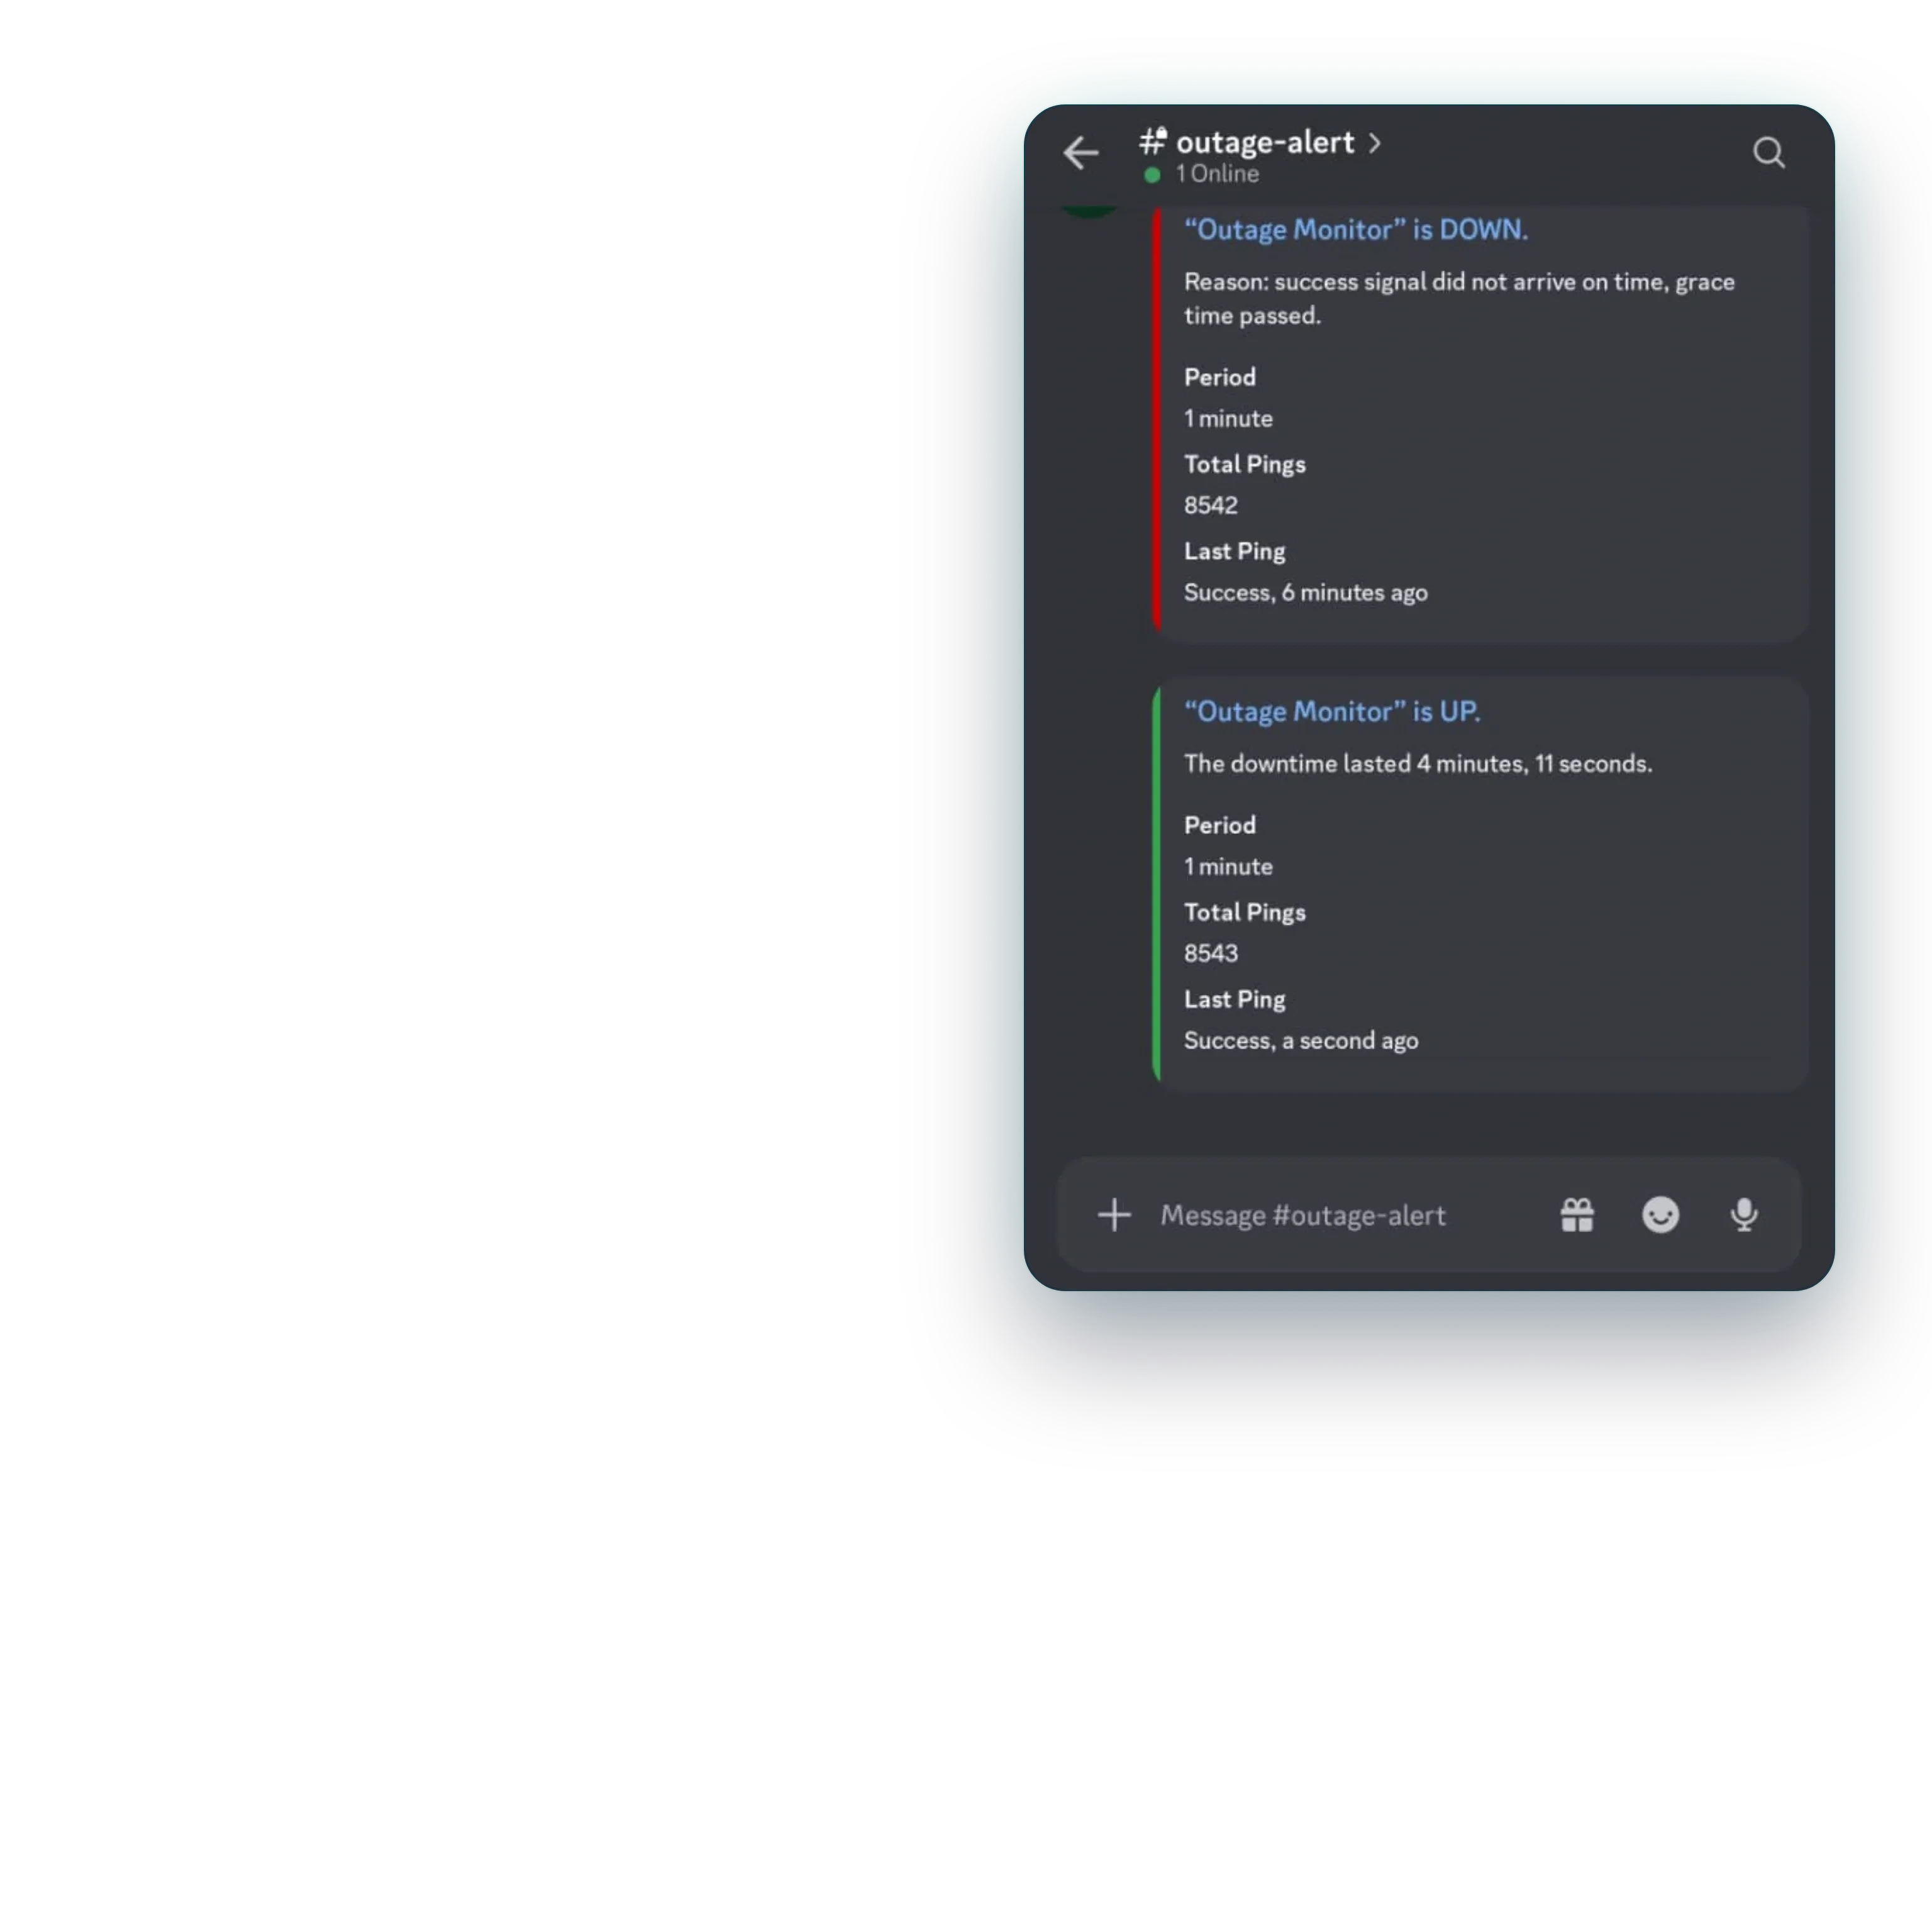
不需要有人一直盯着控制面板,问题也能被发现:警报通过 Telegram、Discord 和 ntfy 送达手机,Telegram 上的来自宕机监控和集群自身的告警规则,Discord 和 ntfy 上的来自监控的看守者。监控本身又从家门之外被看守着,所以 9 月 30 日它沉默了四分钟时,这段沉默本身就作为警报到来,先是宕机,然后恢复,同时出现在 Discord 和 ntfy 上。

你可能也喜欢

托管 CI 成了最慢的一环,于是构建搬回了家
构建和部署从 GitHub 的托管 runner 搬到了家中的一个 runner 池。过去每次运行都从一台全新机器开始,发布还要等排队、等故障恢复;现在由一台构建机在线时承接每个任务,常开服务器上的备用 runner 则由一个看门狗看守,一旦拿不准,它优先保证还能继续发布。镜像进入私有容器镜像仓库,工作室的程序库进入私有 npm 仓库,两者都在自家环境内,每次运行的记录也会归档,留存时间超过 GitHub 的保留期。最慢的部署从八分二十四秒缩短到三分零五秒,CI 也快了三分之一。
Md Moniruzzaman
9月 24, 2026
27 Pearls:移动发布和商店提交
一款已完成的 27 Pearls 应用,在为期一周的合作中成为 App Store 和 Google Play 上获批的商店页面,没有经历任何一轮拒审。这一周包括发布构建与签名、围绕学生收益撰写的商店文案、覆盖每种必需设备尺寸的截图、与应用实际收集的数据相符的隐私声明,以及一个可用的审核账号。这款应用至今仍在 Google Play 上。

Md Moniruzzaman
5月 05, 2023



博客是来自生产一线的笔记:架构决策、经受住真实用户考验的 AI 系统、能自己挣回成本的基础设施。写于工作之中,而不是隔岸观火。